
遇见数据集

gpn-star-scores

收藏
Hugging Face2026-07-24 更新2026-07-27 收录
官方服务:

资源简介:

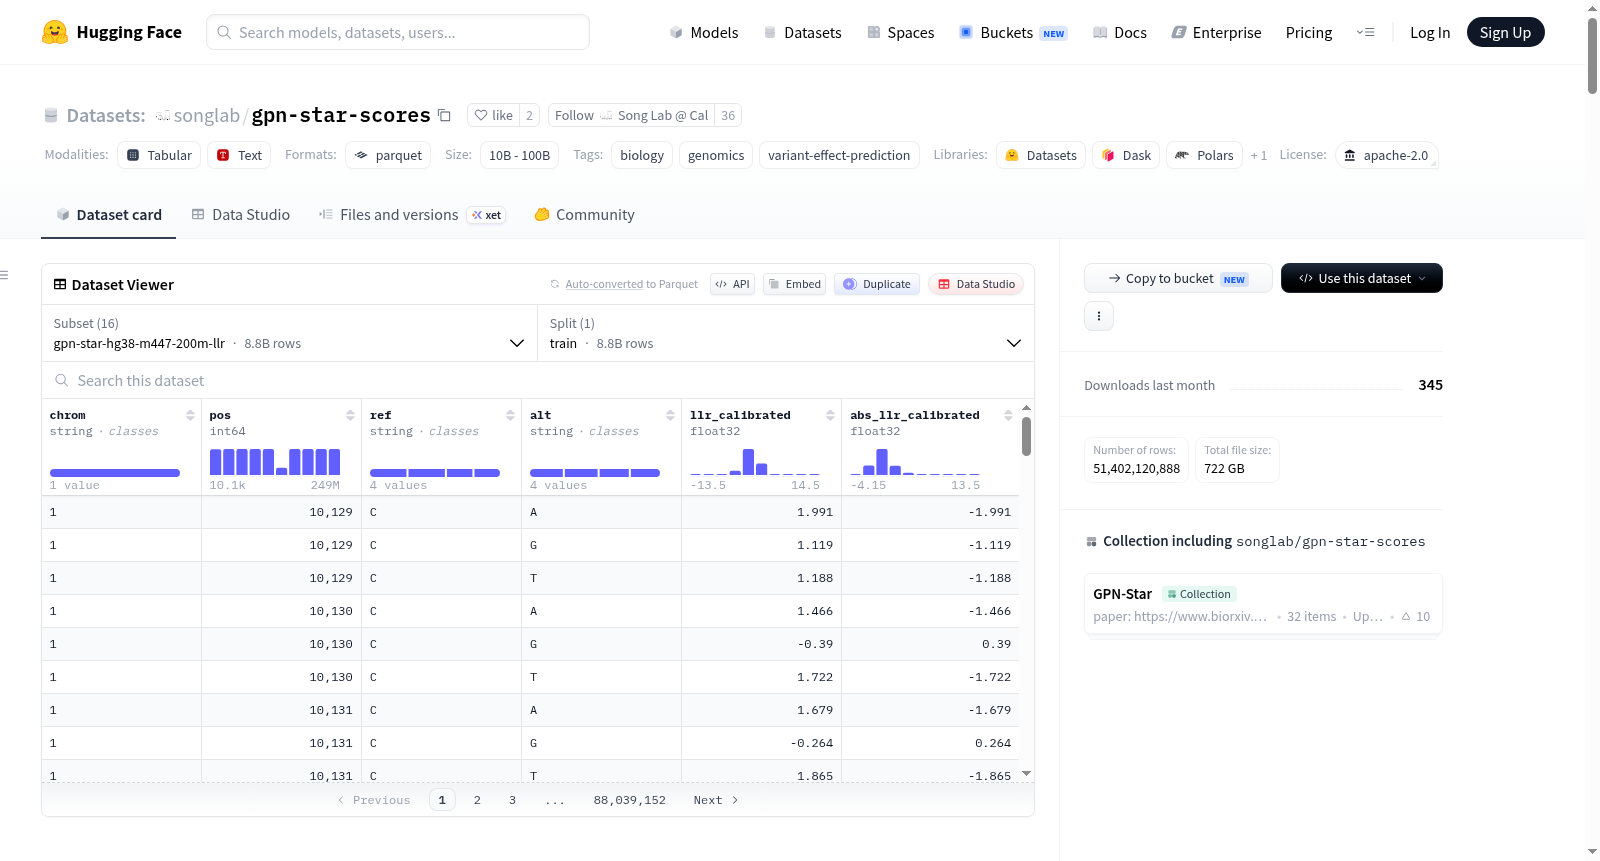
GPN-Star genome-wide scores 是一个全基因组范围的变异效应预测数据集,包含经过校准的 GPN-Star 模型分数。该数据集覆盖八个不同的物种模型与基因组组装组合,包括人类(三种不同进化约束的 200M 参数模型)、秀丽隐杆线虫、黑腹果蝇、鸡、拟南芥和小鼠。数据以两种主要形式提供:Parquet 格式的原始高精度分数文件,以及为基因组浏览器可视化优化的 BigWig 轨道文件。Parquet 文件包含两种配置类型:entropy 配置提供染色体位置、参考碱基和校准后的熵分数;llr 配置额外包含替代碱基、校准后的对数似然比分数及其绝对值。数据集规模庞大(10B<n<100B),适用于基因组学功能注释、进化约束分析、变异致病性预测等任务。用户可通过 UCSC Genome Browser 直接可视化数据,或使用 Polars 等工具进行高效的大规模基因组区间查询和变异注释分析。数据集采用 Apache-2.0 许可证发布。

GPN-Star genome-wide scores is a genome-wide variant effect prediction dataset containing calibrated GPN-Star model scores. It covers eight different species model and genome assembly combinations, including humans (three 200M parameter models with different evolutionary constraints), Caenorhabditis elegans, Drosophila melanogaster, chicken, Arabidopsis thaliana, and mouse. The data is provided in two main formats: raw high-precision score files in Parquet format, and BigWig track files optimized for genome browser visualization. Parquet files include two configuration types: the entropy configuration provides chromosome positions, reference bases, and calibrated entropy scores; the llr configuration additionally includes alternative bases, calibrated log-likelihood ratio scores, and their absolute values. The dataset is large-scale (10B<n<100B) and suitable for tasks such as genomic functional annotation, evolutionary constraint analysis, and variant pathogenicity prediction. Users can directly visualize the data via the UCSC Genome Browser or use tools like Polars for efficient large-scale genomic interval queries and variant annotation analysis. The dataset is released under the Apache-2.0 license.
创建时间:
2026-07-22
搜集汇总
数据集介绍
gpn-star-scores 数据集图片
构建方式
该数据集基于GPN-Star模型,整合了跨越多个进化时间尺度的系统发育信息,通过突变率校准的方式,对包括人类、小鼠、鸡、果蝇、线虫和拟南芥在内的六种生物的基因组进行了全基因组范围的约束性与变异效应评分。数据集将每个基因组划分为染色体片段,并以Parquet格式存储,提供了两种核心评分:以log-likelihood ratio(LLR)为代表的变异级评分和以熵(entropy)为代表的位点级评分。LLR评分针对每个基因组位置上的非参考等位基因(A/C/G/T)计算突变率校准的对数似然比,而熵评分则反映该位点的序列保守程度。数据集的构建严格遵循了坐标体系的一致性,Parquet文件采用无“chr”前缀的染色体名称和一维坐标,并同时提供BigWig格式用于UCSC基因组浏览器的可视化展示。
特点
该数据集的核心特点在于其跨越了广泛的进化谱系,涵盖了从植物到哺乳动物的多个模式生物,为比较基因组学和进化生物学研究提供了宝贵的资源。数据集提供了两种互补的评分指标:代表功能约束程度的LLR评分(绝对值越大表示约束越强)和代表序列保守性的熵评分(数值越低表示越保守),二者均经过突变率校准,可有效区分中性进化与功能选择。此外,数据集的规模庞大,包含超过500亿行数据,且以染色体分片、高精度的Float32格式存储,便于高效计算查询。多平台兼容性是其另一亮点,用户既可通过Hugging Face与Python代码直接进行数据分析,也可通过UCSC基因组浏览器的多组装hub实现交互式可视化探索。
使用方法
用户可以通过Hugging Face Datasets库直接访问该数据集,利用Polars等高性能数据处理框架进行本地或远程查询。典型的使用流程是首先加载目标变异位点的位置信息,然后通过染色体标识符与位置信息过滤对应的Parquet分片文件,最后通过外连接将评分数据与原始变异位点合并。对于大规模分析,建议预先下载完整的Parquet分片文件至本地以加速查询。可视化方面,用户可通过UCSC基因组浏览器的多组装hub链接,在六种生物的基因组上实时查看序列logo轨迹与LLR评分轨迹,其中负值LLR以蓝色表示较高的功能约束程度,正值则呈红色。数据集的所有文件均提供SHA-256校验和与不可变的版本标识符,确保了分析结果的可重复性。
背景与挑战
背景概述
GPN-Star genome-wide scores数据集由Song实验室于2025年发布,旨在通过系统发育信息增强的基因组语言模型来预测跨进化时间尺度的功能性约束。该数据集整合了人类、小鼠、鸡、果蝇、线虫和拟南芥等六个物种的参考基因组,提供了基于突变率校准的约束得分和变异效应预测,涵盖熵值和对数似然比两种核心指标。作为连接深度学习与进化基因组学的桥梁,GPN-Star为解析非编码区域的功能意义、识别致病性变异提供了全新工具,其大规模全基因组评分显著推动了精准医学和比较基因组学领域的进展。
当前挑战
该数据集面临的核心领域挑战在于准确区分中性突变与功能性约束,尤其是非编码区域中微弱但关键的选择信号。构建过程中需克服多物种比对质量的差异、突变率校准的统计复杂性,以及海量基因组数据(超过510亿行)的高效存储与索引难题。此外,将深度学习模型的输出转化为可生物学解释的评分需要严谨的校准策略,而跨平台一致性(如Parquet与BigWig格式转换)和浏览器可视化交互的稳定性也是技术上的重大挑战。
常用场景
经典使用场景
在基因组学与进化生物学领域,GPN-Star全基因组分数数据集主要用于评估单核苷酸变异的功能约束程度与致病性。通过结合系统发育信息的基因组语言模型,该数据集提供了经突变率校准的对数似然比(LLR)和位置熵值,能够精准量化人类、小鼠、鸡、果蝇、线虫及拟南芥等模式生物的基因组中每个位点的进化保守性与变异效应。研究者可基于这些分数快速筛选具有潜在功能影响的突变,从而在无标签数据条件下实现大规模功能性变异注释。
衍生相关工作
围绕GPN-Star数据集衍生出多项开创性工作,包括将其评分机制推广至其他进化分支的基因组模型,如GPN-Star-M(447哺乳动物比对)、GPN-Star-P(243灵长类比对)及针对小鼠、鸡、果蝇等物种的专用模型。这些工作验证了系统发育感知语言模型在跨物种功能预测中的普适性,并推动了后续将深度突变扫描实验数据与进化约束评分融合的研究范式,为精准基因组医学与进化发育生物学中的候选位点筛选提供了标准化基准。
数据集最近研究
最新研究方向
本数据集聚焦于利用系统发育信息整合的基因组语言模型,在跨进化时间尺度上预测功能约束与变异效应,代表了计算基因组学的前沿突破。通过为人类、小鼠、鸡、果蝇、线虫和拟南芥等六个物种提供全基因组范围的熵值与对数似然比评分,该研究将深度学习与进化生物学深度融合,革新了非编码区域功能元件注释的精准度。其核心意义在于实现了从单一物种到多物种、从编码区到全基因组的泛化能力,为精准解读人类疾病相关变异、揭示进化保守性模式以及推动动植物的功能基因组学提供了革命性工具,回应了后基因组时代对大规模、高分辨率变异效应预测数据集的迫切需求。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

