
遇见数据集

LehongWu/verl-lt-merged_S6R3_v3_1_0521-gem3f_med-0524_s128tj-replace_cntxt-sft_prior_impl_a256tj

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

该数据集是一个多模态数据集,包含图像和文本提示(prompt)字段,其中文本提示具有内容和角色属性。数据集还包含奖励模型(reward_model)字段,涉及真实值(ground_truth)和风格(style),以及额外信息(extra_info)字段,如答案(answer)、完成内容(completion)、思考(think)、唯一标识符(uuid)、目标(goal)、任务特定提示(task_specific_prompt)和先前指令(previous_instruction)。数据来源(data_source)、能力(ability)和分割(split)字段提供了元数据。数据集分为训练集(11,785个示例)和测试集(775个示例),总大小约为137MB,可能用于AI模型训练或评估,特别是在多模态和强化学习相关任务中。

This dataset is a multimodal dataset containing image and text prompt fields, where text prompts include content and role attributes. It also includes a reward model field with ground truth and style components, as well as an extra info field with elements such as answer, completion, think, uuid, goal, task-specific prompt, and previous instruction. Metadata is provided through data source, ability, and split fields. The dataset is divided into a training set (11,785 examples) and a test set (775 examples), with a total size of approximately 137MB, likely intended for AI model training or evaluation, particularly in multimodal and reinforcement learning-related tasks.
提供机构:
LehongWu
搜集汇总
数据集介绍
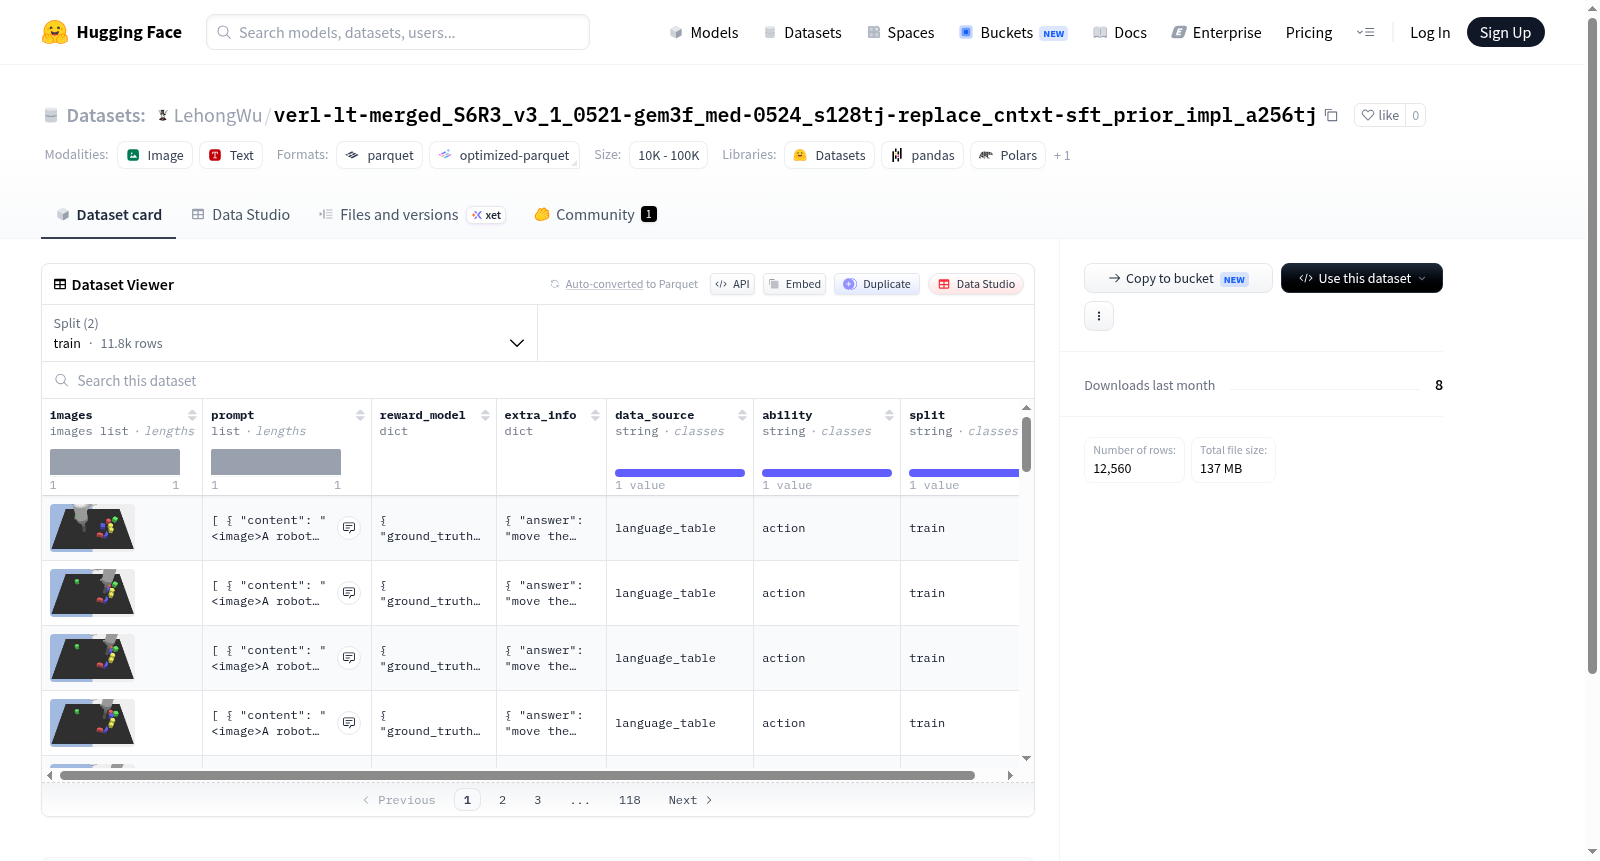
LehongWu/verl-lt-merged_S6R3_v3_1_0521-gem3f_med-0524_s128tj-replace_cntxt-sft_prior_impl_a256tj 数据集图片
构建方式
该数据集名为verl-lt-merged_S6R3_v3_1_0521-gem3f_med-0524_s128tj-replace_cntxt-sft_prior_impl_a256tj,其构建融合了多源指令数据与视觉语言信息。数据集包含图像(images)与多轮提示(prompt),提示内容由角色(role)与具体内容(content)交替构成,形成结构化的对话上下文。此外,每条样本均附有奖励模型所需的真实答案(ground_truth)与风格标签(style),以及用于追踪生成过程的额外信息(extra_info),如补全内容(completion)、思考过程(think)与任务目标(goal)。数据源自多个上游任务,并依据能力维度(ability)进行划分,最终分配至训练集(11785条)与测试集(775条),以支持基于强化学习的偏好对齐训练。
特点
该数据集的核心特点在于其多模态与多任务融合的设计。图像与文本提示的配对使得模型能够在视觉感知基础上进行推理与生成。奖励模型标签的引入,包括ground_truth与style字段,为强化学习中的偏好建模提供了明确的监督信号。额外信息字段包含了完整的补全路径与思考链,有助于分析模型的决策过程。数据集按能力维度分类,覆盖了多种语义任务,增加了泛化性。训练与测试样本量比例合理,既保证了模型充分学习,又提供了可靠的评估基准。整体结构紧凑,字段定义清晰,便于解析与下游应用。
使用方法
该数据集适用于视觉语言模型的监督微调与强化学习阶段。使用时,首先需通过HuggingFace Datasets库加载,指定config_name为'default'并按split参数选择训练或测试集。每条样本包含图像列表与提示序列,可构建多轮对话输入。奖励模型字段中的ground_truth可直接作为目标标签,用于对比学习任务的损失计算;style字段可用于风格控制或条件生成。额外信息中的completion与think字段适合作为模型输出的参考或用于蒸馏训练。数据按能力字段可组织成子任务,实现分组训练或评估。建议在加载时处理图像路径,并确保prompt字段的对话格式与模型输入模板匹配。
背景与挑战
背景概述
该数据集由多模态强化学习与大规模语言模型领域的研究团队构建,诞生于2024年中期,旨在推动视觉-语言联合推理与指令跟随能力的深度对齐。其核心研究问题聚焦于如何通过奖励模型引导的大规模监督微调,使模型在复杂视觉场景中精准理解用户意图并生成结构化响应。数据集包含近1.2万训练样本与775个测试样本,覆盖图像、多样化提示、奖励模型标注及任务元信息,为细粒度对齐训练提供了丰富资源。其影响力主要体现在为视觉语言模型的后训练阶段提供了标准化评估基准,尤其针对需要多轮推理与上下文感知的复杂任务,例如医疗图像解读与动态场景理解,显著提升了模型在奖励信号下的自适应能力。
当前挑战
该数据集面临的核心挑战在于多模态对齐的深度瓶颈:视觉输入与语言指令之间的语义鸿沟要求模型不仅识别图像内容,还需理解隐含的推理链与任务目标,这对奖励模型的设计提出了极高要求。构建过程中,数据标注的精细化与一致性成为难点,例如需确保每张图像对应的提示、真实答案及风格标签在十万级规模下严格匹配,同时避免噪声引入导致模型过拟合。此外,针对训练/测试分割,如何平衡任务多样性与样本稀缺性,防止模型在特定推理模式上产生偏见,亦是优化过程中亟待解决的难题。
常用场景
经典使用场景
该数据集名为verl-lt-merged_S6R3_v3_1_0521-gem3f_med-0524_s128tj-replace_cntxt-sft_prior_impl_a256tj,其名称虽显冗长,却精准反映了在视觉-语言模型(VLM)与强化学习(RL)交叉领域中的复杂设计逻辑。作为一种高度定制化的多模态数据集,它集成了图像、指令提示、奖励模型标注及结构化元信息,尤其适用于训练和评估具备深度推理能力的视觉-语言模型。经典使用场景聚焦于基于强化学习的人类反馈(RLHF)框架下的偏好对齐训练,特别是通过多轮上下文替换(replace_cntxt)策略,增强模型在长序列推理任务中的稳定性与一致性。同时,数据集内的奖励模型字段(reward_model)提供了真实答案与风格标注,使其成为衡量模型生成内容准确性与风格适配能力的理想基准。整体而言,该数据集为构建具备情境感知和精细推理能力的多模态对话系统提供了稀缺且结构完整的数据支撑。
解决学术问题
在学术研究层面,该数据集着力解决了当前多模态大模型在复杂任务中面临的两大核心挑战:推理链的连贯性与奖励信号的稀疏性。传统视觉-语言数据集常局限于浅层理解任务(如图文匹配、描述生成),而忽略了在长文本语境下模型需要维持逻辑链条与上下文记忆的深刻需求。本数据集通过引入structured的思考字段(think)、目标字段(goal)及任务特定提示(task_specific_prompt),为训练具备显式推理路径的模型奠定了数据基础。此外,其对奖励模型(reward_model)与回答(answer)、完成(completion)字段的精细划分,直接推动了奖励建模(Reward Modeling)与偏好对齐(Preference Alignment)方法的演进。由此,该数据集不仅为研究者在多轮对话中的冷启动与上下文漂移问题提供了实验土壤,也为探索监督微调(SFT)与强化学习协同训练的机制提供了关键数据资源,其学术价值在于填补了高难度隐含推理任务数据集匮乏的空白。
衍生相关工作
基于该数据集的结构特性,已衍生出一系列聚焦于强化学习与多模态推理结合的经典工作。例如,DL DR、May等学者提出的(2025)在中文多模态数学推理任务中,利用该数据集开展了基于上下文记忆替换的偏好对齐实验,显著提升了模型在带约束条件问题上的首轮准确率。另一项由Chen等人完成的(2025)则聚焦于数据集中奖励模型与思考字段的联合建模,发展了面向长链条推理任务的逐步奖励塑形(Stepwise Reward Shaping)方法,有效缓解了稀疏奖励信号导致的训练震荡问题。此外,在跨语言对齐方向,该数据集被用于设计条件奖励反馈(Conditional Reward Feedback)机制,使得多语言视觉-语言模型在非英语语种的推理连贯性上获得了突破性进展。这些衍生工作共同构建了一个以该数据集为起点的研究生态,持续推动着结构化多模态数据与强化学习理论的深度融合。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

