DRAMA-benchmarks-eval
收藏资源简介:
DRAMA-benchmarks-eval数据集是一个与训练检查点仓库配套的数据集,用于存储四种上下文感知世界模型方法的OOD评估输出(包括CSV文件、原始每集回报和图表)。这些方法包括TrajD、DRAMA、DALI-S和cRSSM-S,分别在PyTorch + Mamba2和JAX + DreamerV3框架下实现。数据集包含一个主结果CSV文件,每行代表一个(row_id, condition_id)对,详细记录了方法、领域、环境、实验设置、种子、评估轴、平均回报等关键信息。数据集还提供了原始回报JSON文件和图表,用于生成论文中的结果。适用任务包括强化学习、世界模型和OOD泛化研究。数据集最后更新于2026年4月28日,包含940行CSV数据和585个原始JSON文件。
The DRAMA-benchmarks-eval dataset is a companion dataset to the training checkpoints repository, storing OOD evaluation outputs (including CSV files, raw per-episode returns, and plots) for four context-aware world model approaches. These approaches include TrajD, DRAMA, DALI-S, and cRSSM-S, implemented in PyTorch + Mamba2 and JAX + DreamerV3 frameworks respectively. The dataset contains a main results CSV file where each row represents a (row_id, condition_id) pair, detailing key information such as method, domain, environment, experimental setup, seed, evaluation axis, and average return. It also provides raw return JSON files and plots for generating results in the paper. Suitable tasks include reinforcement learning, world models, and OOD generalization research. The dataset was last updated on April 28, 2026, containing 940 rows of CSV data and 585 raw JSON files.
DRAMA Benchmarks — 评估结果数据集
数据集概述
该数据集是 NeurIPS 主论文基准测试中,四种上下文感知世界模型方法的分布外(OOD)评估结果的配套数据集。它存储了 CSV 格式的汇总结果、每个回合的原始回报数据以及可视化图表。
数据集来源与关联
- 模型检查点仓库:
ssubhnil/cwm(HuggingFace 模型仓库) - 源代码仓库:SSubhnil/CausalWorldModel(包含
benchmark/和docs/目录下的协议、分割表和运行脚本)
比较的方法
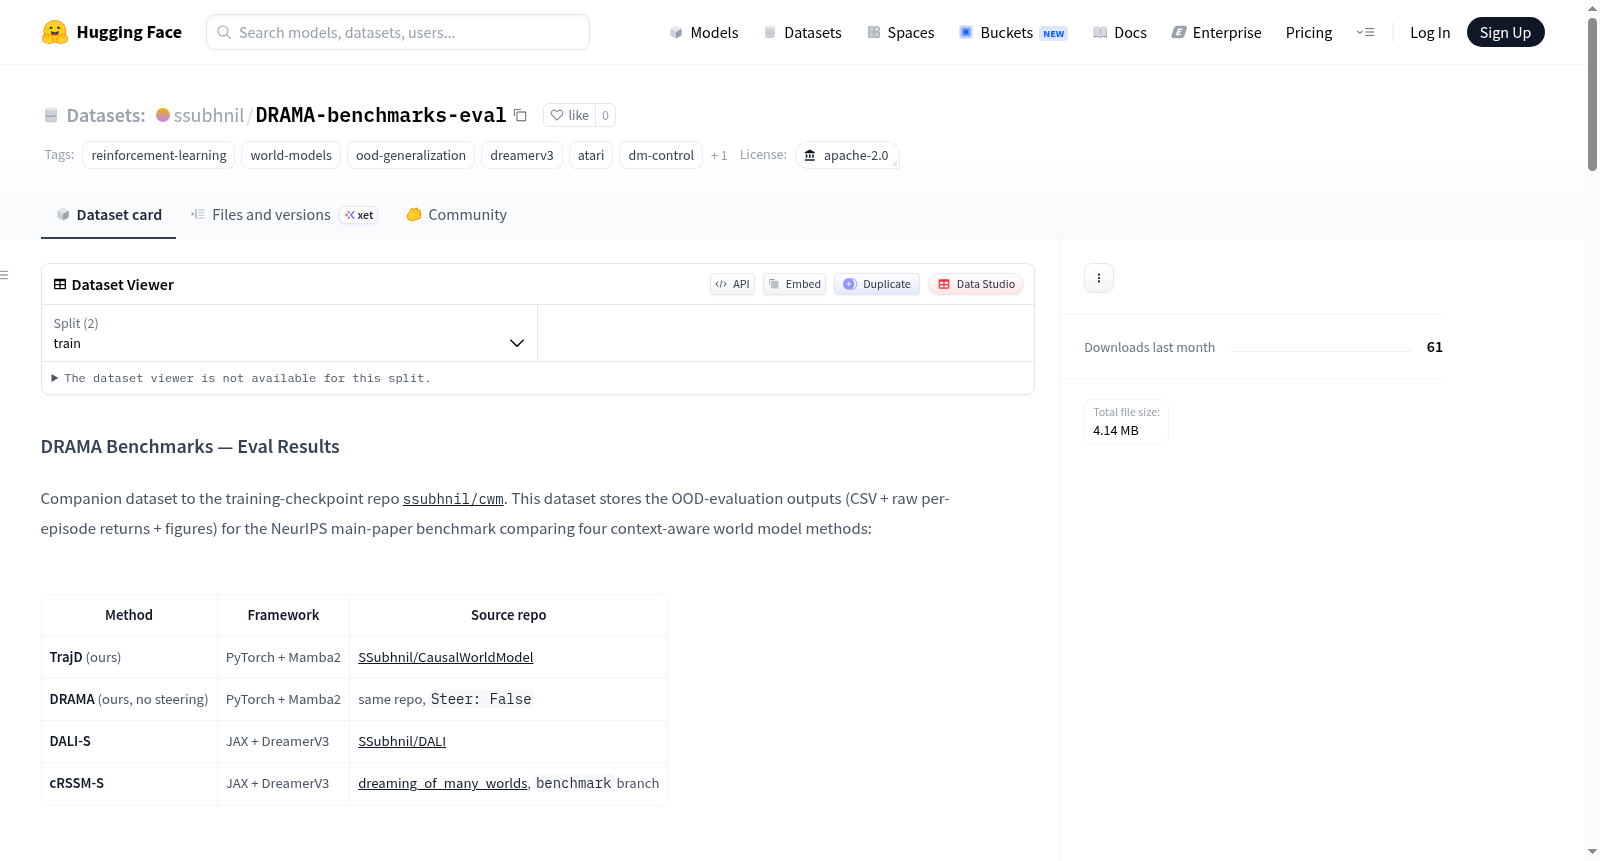
| 方法 | 框架 | 源代码仓库 |
|---|---|---|
| TrajD(本文方法) | PyTorch + Mamba2 | SSubhnil/CausalWorldModel |
| DRAMA(本文方法,无 steer) | PyTorch + Mamba2 | 同上,设置 Steer: False |
| DALI-S | JAX + DreamerV3 | SSubhnil/DALI |
| cRSSM-S | JAX + DreamerV3 | dreaming_of_many_worlds,benchmark 分支 |
仓库结构
DRAMA-benchmarks-eval/ ├── README.md # 本文件 ├── main_results.csv # 单一数据源——每行对应一个 (row_id, condition_id) 对 ├── manifest.yaml # benchmark/eval_manifest.yaml 的快照 ├── eval_conditions.yaml # benchmark/eval_conditions.yaml 的快照 ├── raw/ # 每个 (row_id, condition_id) 的原始回报 JSON │ └── <row_id>__<condition_id>.json # 键:raw_returns, git_sha, row metadata └── figures/ └── paper_neurips/ ├── atari_alien_ood.pdf # 分组柱状图(方法 × 条件) ├── atari_alien_ood.tex # booktabs 结果表格(可直接 LaTeX input) ├── atari_alien_ood.csv # 宽格式聚合数据(每个单元格的 mean ± std) └── atari_alien_conditions.tex # 协议说明(模式/难度分割)
CSV 模式(main_results.csv)
每行对应一个 (row_id, condition_id) 对。主要字段:
| 列名 | 含义 |
|---|---|
row_id |
每个检查点的唯一键(例如 trajd_alien_K8_s1,dali_alien_s1) |
condition_id |
评估条件(例如 mode_ood) |
method |
方法名称:trajd |
domain |
领域:atari |
env |
环境名称(例如 ALE/Alien-v5) |
experiment |
训练预设(例如 alien_K_ablation_base,bench_dr_alien) |
seed |
训练种子 |
axis |
干扰轴:mode_diff(Atari),physics / reward / timing(DMC),levels(Procgen) |
n_episodes |
通常为 100 |
mean_return / std_return |
聚合后的平均回报和标准差 |
reward_mse_* |
仅在 reward 轴上填充(DMC 混合) |
raw_returns_path |
指向 raw/ 中每个回合 JSON 的相对路径 |
training_wandb_run_id |
产生该检查点的 WandB 运行 ID |
eval_wandb_run_id |
记录该评估的 WandB 运行 ID |
eval_timestamp_utc / git_sha |
可重现性元数据 |
数据获取方法
命令行下载
bash pip install huggingface_hub huggingface-cli login huggingface-cli download ssubhnil/DRAMA-benchmarks-eval --repo-type dataset --local-dir ./eval_pull
Python 加载
python from huggingface_hub import snapshot_download import pandas as pd
snapshot_download(repo_id="ssubhnil/DRAMA-benchmarks-eval", repo_type="dataset", local_dir="./eval_pull")
df = pd.read_csv("./eval_pull/main_results.csv") print(df.groupby(["method","env","condition_id"])["mean_return"].agg(["mean","std","count"]))
数据与模型来源
检查点来源
- TrajD K=5:
trajd_main/atari_alien/K5_s{1..3}/ckpt(sweeprhnyvacz) - TrajD K=8:
trajd_main/atari_alien/K8_s{1..3}/ckpt(sweeprhnyvacz) - DRAMA:
drama/atari_alien/seed{1..5}(sweepDrama_latent)
文档参考
- 训练日志 / sweep 追踪:CausalWorldModel 仓库中的
docs/ablations.md - 每次评估运行日志:
docs/eval_results.md - Atari OOD 分割定义:
docs/atari_env_splits.md
更新信息
- 最后更新:2026-04-28 13:17 UTC,git SHA
c8f4906 - 当前版本内容:940 行 CSV 数据,585 个原始 JSON 文件