ccw7463/kollm_multi_turn_dataset_v0.1
收藏资源简介:
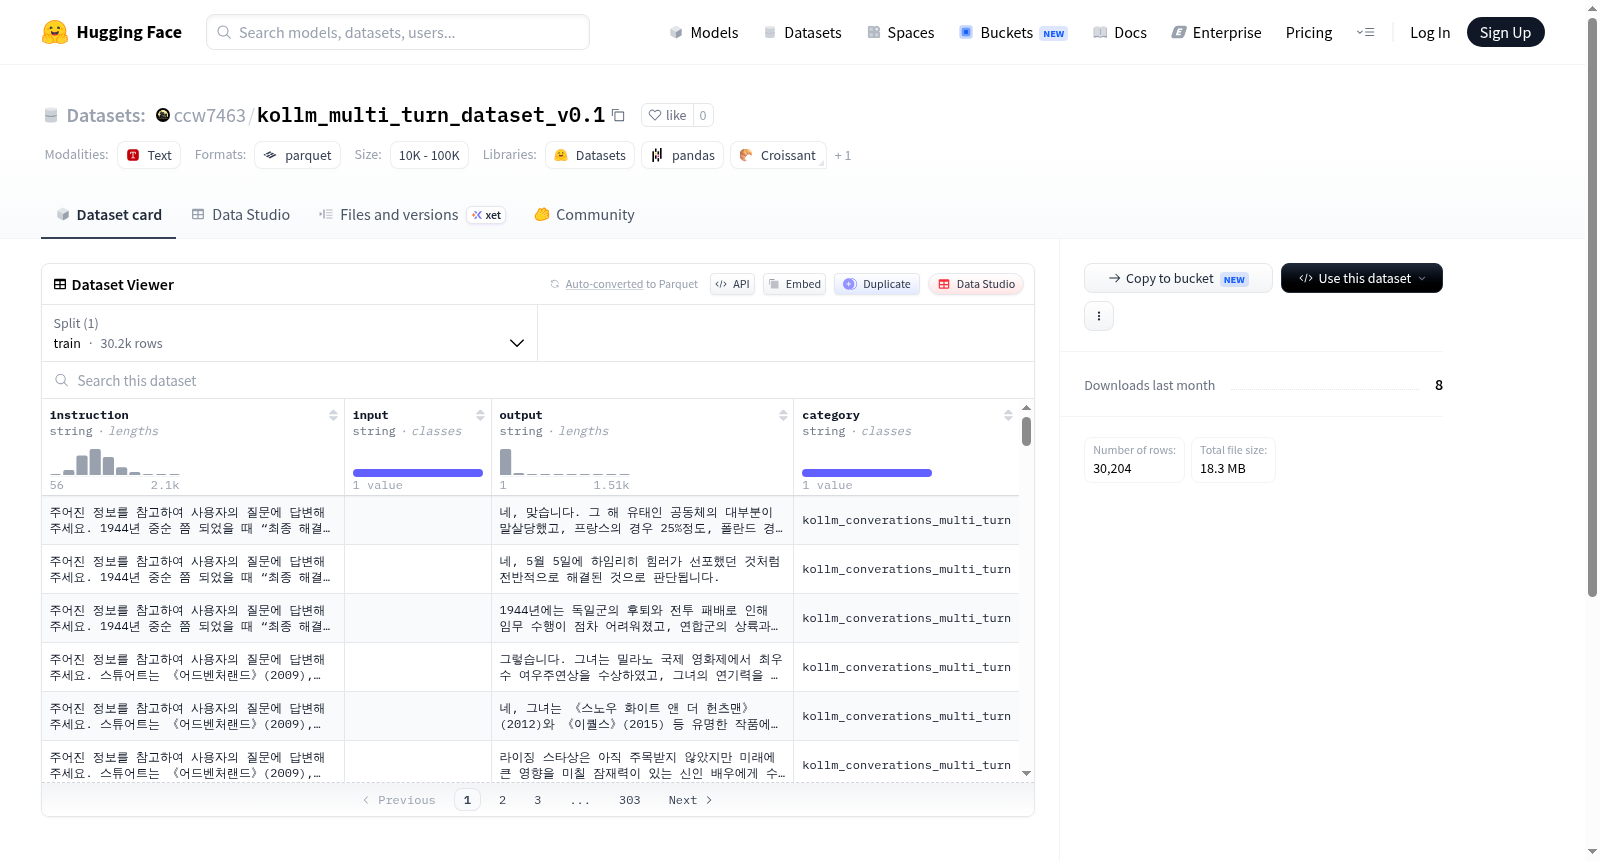
--- dataset_info: features: - name: instruction dtype: string - name: input dtype: string - name: output dtype: string - name: category dtype: string splits: - name: train num_bytes: 65402639 num_examples: 30204 download_size: 18257792 dataset_size: 65402639 configs: - config_name: default data_files: - split: train path: data/train-* --- 🚀 Dataset Info - Ref : davidkim205/kollm-converations - preocessing - extract only Multi turn datasets (contain some single turn dataset from Multi-Turn) - construct Histroy Format
数据集信息: 特征字段: - 字段名:指令(instruction),数据类型:字符串 - 字段名:输入(input),数据类型:字符串 - 字段名:输出(output),数据类型:字符串 - 字段名:类别(category),数据类型:字符串 数据集划分: - 划分集名称:训练集(train),字节数:65402639,样本数量:30204 下载大小:18257792,数据集存储总大小:65402639 配置项: - 配置名称:default,数据文件: - 划分集:train,文件路径:data/train-* 🚀 数据集详情 - 参考来源:davidkim205/kollm-converations - 预处理流程: 1. 仅提取多轮对话数据集(包含部分源自多轮对话的单轮对话样本) 2. 构建对话历史格式
数据集概述
数据集特征
- instruction: 数据类型为字符串
- input: 数据类型为字符串
- output: 数据类型为字符串
- category: 数据类型为字符串
数据集划分
- train:
- 数据大小: 65402639字节
- 示例数量: 30204个
数据集大小
- 下载大小: 18257792字节
- 数据集总大小: 65402639字节
配置信息
- config_name: default
- data_files:
- split: train
- path: data/train-*