
遇见数据集

jablonkagroup/corral-QAs-reports

收藏
Hugging Face2026-06-17 更新2026-05-10 收录
官方服务:

资源简介:

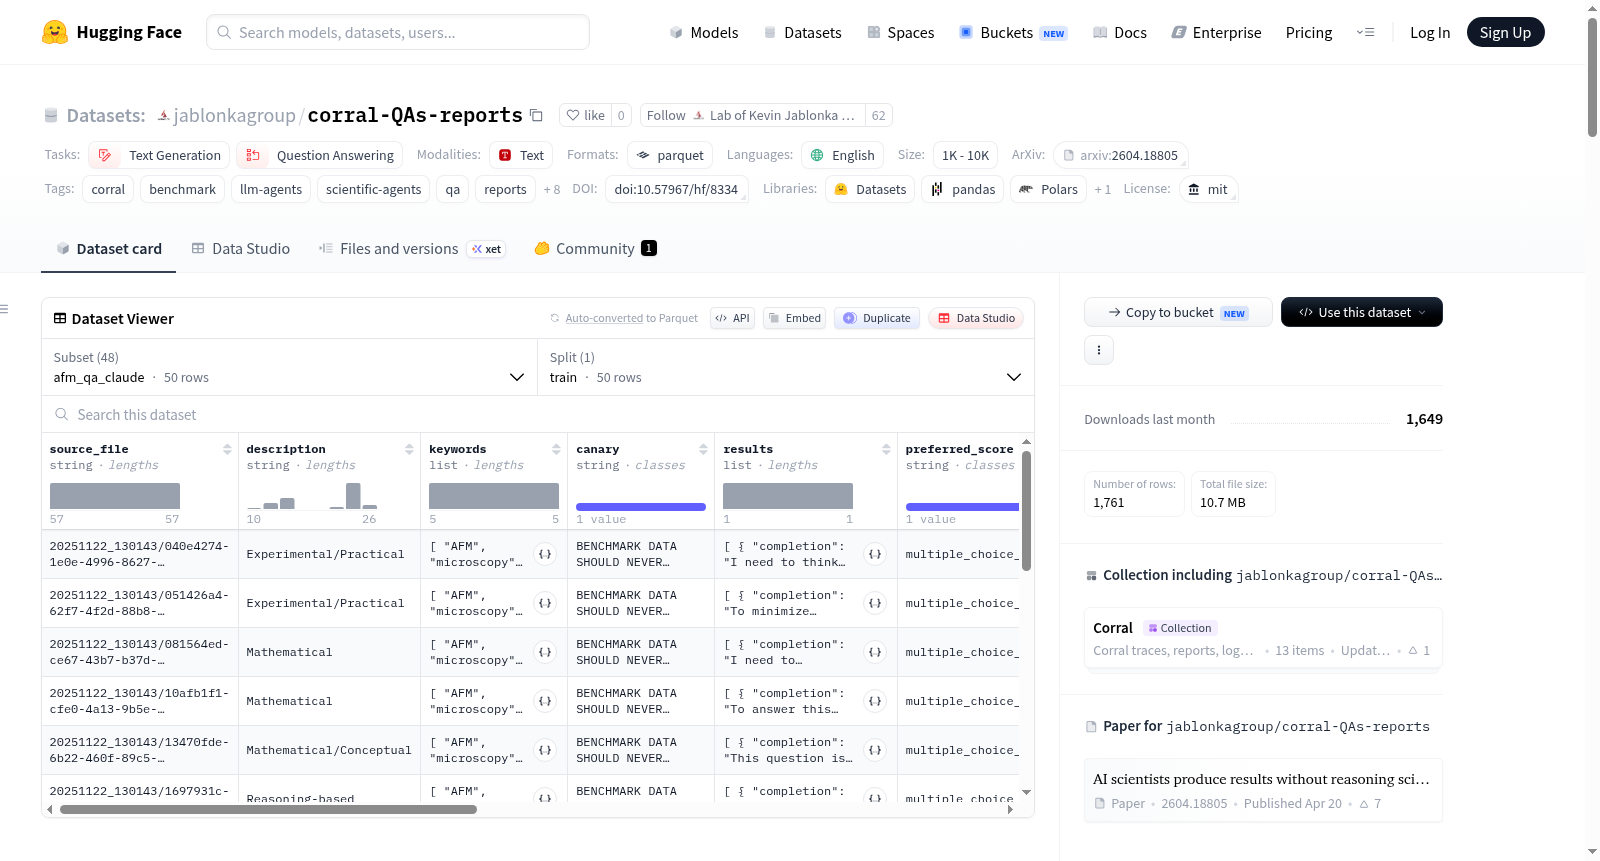
该数据集是Corral – QA Reports,是Corral集合的一部分,随论文《AI科学家在不科学推理的情况下产生结果》发布。它包含了用于测试模型在Corral环境中事实知识和推理能力的问题-答案评估的模型完成情况和报告。数据集组织为50个配置,每个配置对应可用的环境、模型和评估维度(知识或推理)的组合。例如,一个配置编码了某个模型在给定Corral环境的知识聚焦或推理聚焦QA集上生成的报告。这些完成情况对应于Corral研究中报告的项目反应理论(IRT)分析中使用的QA项目,其中基础知识和推理QA作为潜在知识和推理因素的指标。该资源旨在用于评估、心理测量建模和分析科学代理能力,而非用于通用模型预训练。

This dataset is part of the *Corral* collection accompanying the paper [*AI scientists produce results without reasoning scientifically*](https://arxiv.org/abs/2604.18805). It contains the **model completions and reports** for the **question-answer evaluations** used to test the **factual knowledge** and **reasoning ability** of models across *Corral* environments. The dataset is organized into **50 configurations**, with one configuration for each available combination of **environment**, **model**, and evaluation dimension (**knowledge** or **reasoning**). For example, a config encodes the reports generated by one model on either the knowledge-focused or reasoning-focused QA set for a given Corral environment. These completions correspond to the QA items used in the **Item Response Theory (IRT)** analyses reported in the *Corral* study, where the underlying knowledge and reasoning QAs serve as indicators for the latent **knowledge** and **reasoning** factors. This resource is intended for evaluation, psychometric modeling, and analysis of scientific-agent capabilities rather than for general-purpose model pre-training.
提供机构:
jablonkagroup
搜集汇总
数据集介绍
jablonkagroup/corral-QAs-reports 数据集图片
构建方式
在科学智能体评估领域,纯粹以任务完成度为指标的评价体系往往难以揭示模型的内在认知机制。Corral-QAs-reports数据集正是为弥补这一缺陷而构建的产物,它系统性地收集了多种大型语言模型在Corral框架下八个科学环境中的问答输出。数据集的构建基于分层式组织模式,每个配置项由环境标识符、模型名称与评估维度三部分编码而成,覆盖了原子力显微镜、电路推理、光谱解析、逆合成规划、机器学习属性预测、分子动力学模拟、吸附表面构建以及无机定性分析等场景。评测维度被明确区分为事实性知识与科学推理能力两类,模型涵盖了Claude及GPT系列的多种变体,最终形成了50个独立配置。每条记录对应一个模型针对特定问答项目的完整作答,数据以Parquet格式存储并统一提供训练集分割。
特点
该数据集最显著的特征在于其结构化的多维度标签体系与心理测量学导向的设计理念。每一组问答结果均锚定于具体的科学环境与模型,并清晰标注了其所测量的认知维度,从而为区分知识储备与推理能力提供了精细化的分析粒度。数据集内置的50个配置项形成了一张环境-模型-维度的完整对照网格,使得跨模型、跨环境的能力对比成为可能。尤为独特的是,这些问答输出直接服务于项目研究中的项目反应理论分析,将模型作答转化为可量化的潜在特质指标。数据来源于专家设计的科学任务内容,确保了问题的领域权威性与认知挑战性,使其成为评估科学智能体深层认知架构的宝贵资源。
使用方法
本数据集专为科学智能体的认知能力评估与心理测量模型构建而设计。使用者可通过HuggingFace Datasets库按需加载特定配置,例如选择催化剂环境中GPT模型的知识维度问答记录进行单独分析。推荐的典型应用路径包括:复现并扩展论文中报告的IRT分析流程,通过模型在知识题项与推理题项上的作答模式考察其潜在能力结构;构建跨环境的能力图谱,比较同一模型在不同科学领域的表现差异;以及开发元评估基准,用于诊断模型在事实检索与逻辑演绎之间的能力失衡。所有配置均提供统一的训练集分割,便于研究者直接利用已有结果进行统计建模或作为微调任务的评估参照。
背景与挑战
背景概述
在人工智能与科学交叉领域,评估大语言模型驱动的科学代理(scientific agents)的能力已成为研究前沿。然而,现有基准多聚焦于任务完成率,忽视了对模型内在知识储备与推理过程的独立度量。为填补这一空白,Corral QA Reports数据集由Kevin Maik Jablonka团队于2026年发布,旨在通过项目反应理论(IRT)框架,分离并量化科学代理在化学、材料科学等环境中的事实知识与科学推理能力。该数据集包含来自8个Corral环境的50组配置,涵盖Claude与GPT等多种模型的完成报告,为研究模型在复杂科学问题上的知识表征与推理机制提供了结构化资源,对推动科学AI评估方法的发展具有重要影响。
当前挑战
该数据集面临的核心挑战包含双重维度。在领域问题层面,现有评估体系难以精准区分模型输出的答案究竟源自知识记忆还是合理推理,导致对科学代理真正能力的误判,而传统指标也无法揭示其在不同认知层面的隐性缺陷。在构建过程中,数据集需在8个高度异质的科学环境中设计出能有效分离知识与推理因素的问答项目,确保题项既能覆盖领域知识又具备推理辨别力;同时,多模型、多环境、多维度的组合配置极大地增加了数据组织与IRT建模的复杂性,要求对模型输出进行精细标注与结构化处理,以支撑后续的潜变量分析。
常用场景
经典使用场景
在科学智能体与大型语言模型的能力评估领域,Corral-QAs-reports数据集为研究者提供了一个标准化的评测框架,用以探测量化科学与工程智能体在化学与材料科学任务中的事实性知识掌握程度与抽象推理能力。该数据集通常被用作多环境、多模型、多维度的交叉比较测试集,通过覆盖原子力显微镜数据分析、电路推断、光谱结构解析、逆合成规划、机器学习性质预测、分子动力学模拟及催化剂吸附表面构建等八个专业环境,支持系统性地鉴定模型在知识检索和逻辑推演维度上的行为差异。借助项目反应理论的分析范式,研究者能够深入解析模型在复杂科学问题解答中展现的潜在能力结构。
衍生相关工作
该数据集的发布催生了一系列围绕科学智能体心理测量学表征的前沿探索工作。相关衍生研究首先聚焦于基于该数据集对主流语言模型(如GPT及Claude系列)在标准推理链与反思型推理两种行为模式下的能力差异进行细粒度对比分析,揭示了模型在不同环境类型中对推理深度与工具调用策略的选择偏好。部分工作在此基础上构建了轻量级识别器,通过输出层行为的统计特征预测模型潜在的知识与推理因子得分,实现了无需完整环境交互即可实现的快速智能体素质筛查。此外,该数据集的问答条目库被扩展整合至大规模科学推理训练数据管线中,用以生成覆盖更多材料子领域的合成训练样本,有效提升了面向小样本科学问答任务模型的鲁棒性。标注后的推理路径数据亦促使研究者开发更精细的归因图模型,用以追踪模型在跨步骤科学推理中的信息流断裂节点。
数据集最近研究
最新研究方向
当前,该数据集聚焦于运用项目反应理论(IRT)剖析科学智能体在化学与材料科学等多领域中的知识掌握与推理能力,其核心关切在于揭示大型语言模型驱动的智能体在完成复杂科研任务时,是否真正进行了科学推理,抑或仅依赖记忆性知识。前沿研究热点集中于通过该数据集的标准问答评估,构建可量化的潜变量模型,以区分模型的事实记忆与逻辑推导能力,进而为评估科学智能体的深层认知水平提供方法论支撑。这一探索不仅对推动自主实验室与计算材料学的智能化进程具有重要意义,也为反思当前AI在科学研究中的角色,以及构建更具可解释性与可靠性的科学代理系统提供了关键数据基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

