
遇见数据集

media-metadata-anilist-anime

收藏
Hugging Face2026-06-26 更新2026-06-29 收录
官方服务:

资源简介:

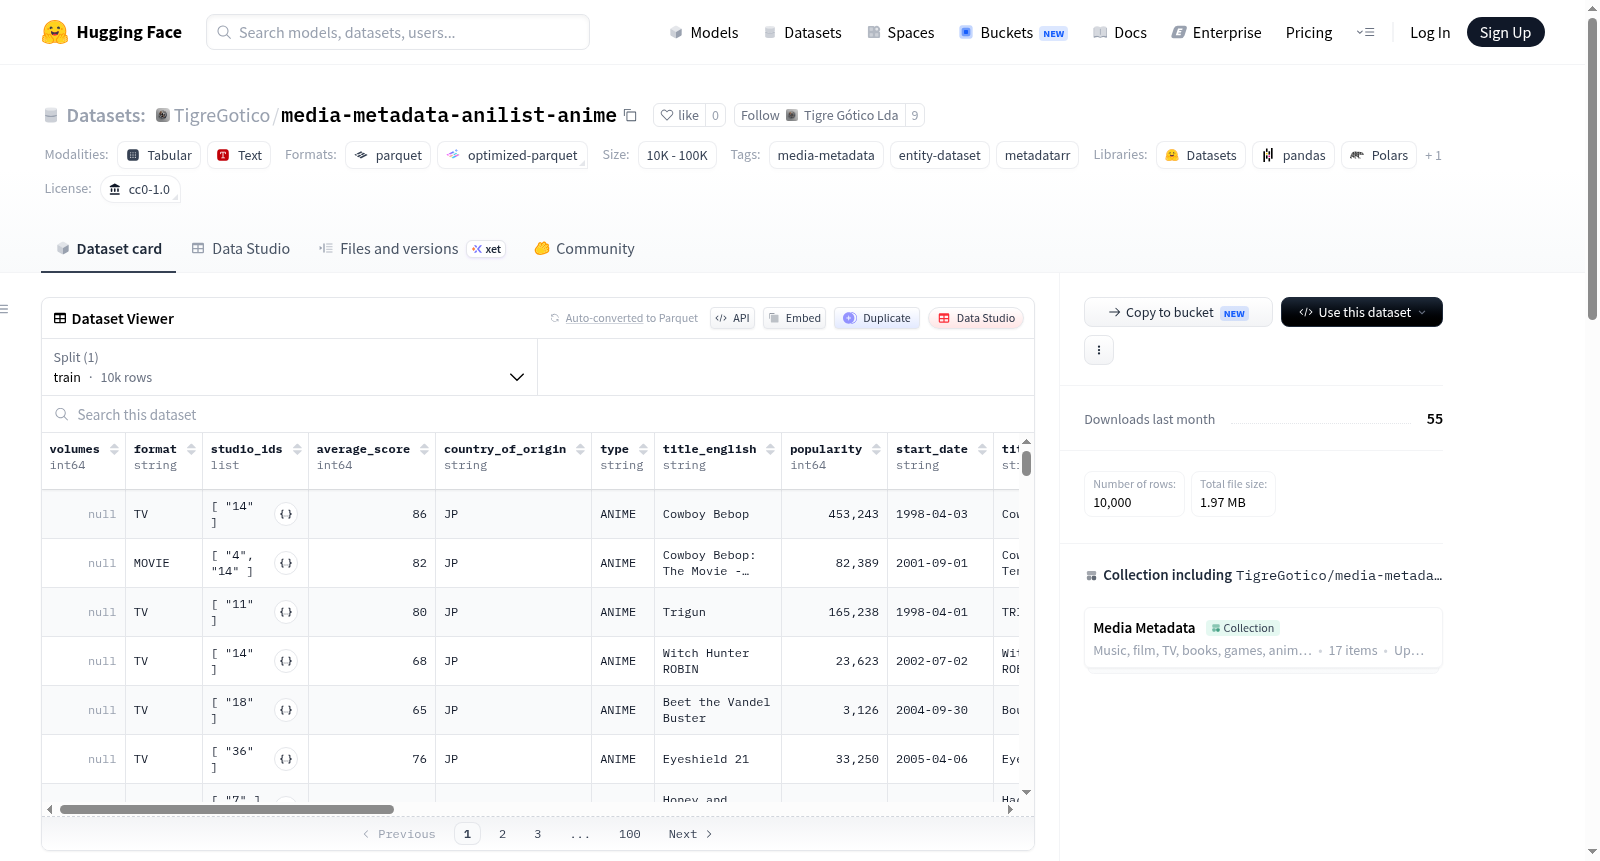
AniList Anime 数据集是一个包含约1万个动漫作品条目的结构化数据集,数据来源于活跃的动漫/漫画追踪平台 AniList 的 GraphQL API。该数据集旨在提供丰富的动漫元数据,适用于内容分析、推荐系统、信息检索等任务。数据集包含每个动漫作品的详细字段,包括:AniList 和 MyAnimeList 的唯一标识符(anilist_id, mal_id);多种语言和形式的标题(罗马字标题、英文标题、原生脚本标题);作品类型(ANIME 或 MANGA)和具体格式(TV、MOVIE、OVA、ONA、SPECIAL、MUSIC);发布状态(已完成、正在发布、尚未发布、已取消);集数(episodes)和单集平均时长(分钟);原产国(ISO 国家代码);原作来源(原创、漫画、轻小说、视觉小说、视频游戏等);播出起止日期(start_date, end_date);播出季度和年份(季节:春、夏、秋、冬);类型列表(genres);带有剧透标记的细粒度社区标签(tags);制作工作室列表(studios);AniList 平均评分(0-100分);以及追踪该作品的用户数(popularity)。数据集以表格形式组织,便于进行数据分析和机器学习应用。

The AniList Anime dataset is a structured collection of approximately 10,000 anime entries, sourced from the GraphQL API of the active anime/manga tracking platform AniList. It aims to provide rich anime metadata suitable for tasks such as content analysis, recommendation systems, and information retrieval. The dataset includes detailed fields for each anime work, covering: unique identifiers for AniList and MyAnimeList (anilist_id, mal_id); titles in multiple languages and forms (romaji, English, native script); work type (ANIME or MANGA) and specific format (TV, MOVIE, OVA, ONA, SPECIAL, MUSIC); release status (completed, currently releasing, not yet released, cancelled); episode count (episodes) and average episode duration in minutes; country of origin (ISO country code); original source material (original, manga, light novel, visual novel, video game, etc.); broadcast start and end dates (start_date, end_date); broadcast season and year (seasons: spring, summer, fall, winter); genre list (genres); fine-grained community tags with spoiler warnings (tags); production studio list (studios); AniList average score (0-100); and the number of users tracking the work (popularity). The dataset is organized in tabular format, facilitating data analysis and machine learning applications.
创建时间:
2026-06-24
搜集汇总
数据集介绍
media-metadata-anilist-anime 数据集图片
构建方式
该数据集源于对AniList平台上动漫实体元数据的系统性采集,依托metadatarr开源工具链中的anilist_anime爬虫脚本,通过自动化管道从AniList API与MyAnimeList等数据源中提取并整合了10,000条动漫条目。每条记录均经过结构化处理,涵盖从基础标识到深层属性的多元字段,形成了层次分明的实体数据集。
使用方法
该数据集以CSV或JSON等标准格式存储,便于通过Pandas、Polars等数据分析库直接导入并进行探索性分析。用户可利用数据集中的关联标识符(如anilist_id与mal_id)与其他媒体元数据集进行横向链接,亦可依据类型、季节、流派等字段过滤子集,为推荐系统训练、流行度建模或内容趋势分析提供结构化的基础素材。
背景与挑战
背景概述
在多媒体内容管理与推荐系统领域,精确且丰富的实体元数据是驱动算法优化的基石。media-metadata-anilist-anime数据集由TigreGotico团队于近期通过metadatarr工具从AniList平台爬取构建,旨在汇聚日本动漫作品的全面结构化信息,涵盖10000条记录,包括标题、类型、评分、制作公司及受众标签等关键字段。该数据集解决了跨平台动漫数据分散、格式不统一的问题,为学术研究中的多模态分析、社交网络效应量化及个性化推荐模型训练提供了标准化资源,对动漫产业数据分析与机器学习应用具有重要推动作用。
当前挑战
当前数据集面临的核心挑战源于动漫领域数据的动态性与异构性。领域问题层面,动漫作品类型多样,包含电视、电影、OVA等不同格式,且存在成人内容与全年龄段内容的分类需求,现有字段虽通过'is_adult'与'genres'区分,但内容层级细分仍不足;同时,跨来源数据关联如MyAnimeList ID的映射对齐可能存在缺失或错误。构建过程中,爬取策略需应对AniList的API速率限制与反爬机制,确保数据完整性;此外,时间信息如起止日期与季度的统一格式化处理,以及多语言标题的兼容性维护,均为数据清洗与一致性保障的难点。
常用场景
经典使用场景
在动画与多媒体研究领域,数据集常被用于构建推荐系统、进行内容分类及趋势分析。media-metadata-anilist-anime数据集汇集了来自AniList平台的10,000部动画作品元数据,涵盖标题、类型、评分、人气及工作室等核心属性。研究者可借助这些结构化信息,训练模型以预测观众偏好、识别潜在热门作品,或挖掘不同地区观众的观看习惯差异,为个性化推荐算法的优化提供坚实的数据基础。
解决学术问题
该数据集有效解决了动画领域缺少大规模、统一格式元数据的问题。传统研究中,数据分散于多个平台且字段定义不一,导致跨平台对比困难。此数据集通过标准化字段如‘平均评分’、‘流行度’和‘收藏数’,使得学者能够量化分析动画质量与市场表现间的关联,探究‘成人内容’标签对受众规模的影响,或验证‘季番长度与评分分布’的统计规律,从而推动媒体计量学与娱乐数据分析的实证研究。
实际应用
实际应用中,数据集支持流媒体平台的内容策略制定。例如,基于‘工作室’与‘类型’的组合分析,平台可精准采购具有高收藏潜力的动画;‘来源材料’字段能帮助出版商预判IP改编作品的市场反应。同时,数据集中的‘状态’和‘集数’信息可用于自动化内容库管理,辅助影视平台动态更新上线计划,并依据‘季节年度’分布优化排播日历,提升用户留存率。
数据集最近研究
最新研究方向
在动漫文化研究领域,media-metadata-anilist-anime数据集为多模态信息检索与媒体元数据分析提供了丰富的数据基础。当前前沿研究方向聚焦于利用大规模动漫元数据推动推荐系统的精确度提升,尤其是结合跨语言标题、类型标签、评级与用户偏好,构建复合语义向量模型。该数据集的发布恰逢AI生成内容与二次元经济深度融合的热点期,研究人员可据此分析作品流行度与媒介出处、制作方等变量间的关联,探讨文化输出效益与受众接受机制的深层规律。其实体化、多维度标注的特性,不仅降低了爬取与清洗数据的成本,还助力于推进从传统内容分类到知识图谱驱动的语义推理的范式跃迁,在数字人文与计算社会科学的交叉语境中具有显著学术价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

