
遇见数据集

T1-Terminal-Bench-2.1-Trajectories

收藏
Hugging Face2026-09-10 更新2026-09-11 收录
官方服务:

资源简介:

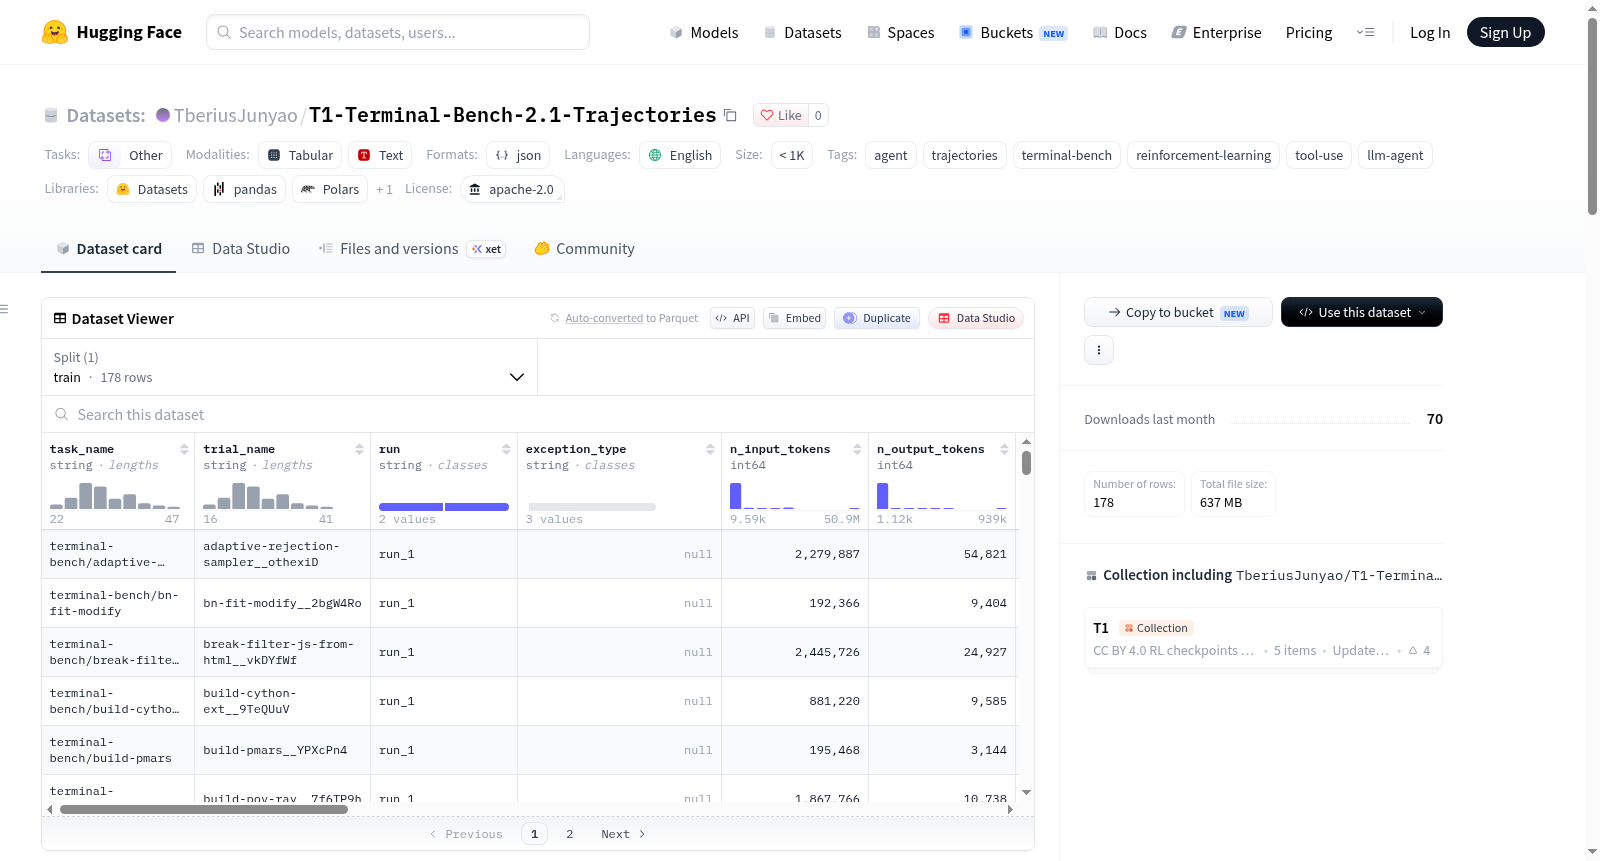
T1 — Terminal-Bench 2.1 Trajectories 数据集记录了使用 Terminus-2 agent scaffold 在 Terminal-Bench 2.1 基准上评估 T1 模型(基于 Qwen3.5、122B 参数)生成的完整 agent 轨迹。数据集包含两次独立的重复运行(run_1 和 run_2),每次运行覆盖 89 个任务,在相同的冻结配置下执行,以揭示运行之间的方差。平均正确率(除以所有 89 次试验,错误试验计为 0)为 64.0%。每个轨迹以目录形式组织,包含 metadata.json(奖励、时间、token 计数、采样配置)、trajectory.json(ATIF-v1.7 格式的完整 agent/用户步骤序列)、上下文压缩相关文件(summarization-N-* 和 trajectory.cont-N.json)以及 asciinema 终端录制 recording.cast 和 final tmux pane 捕获。根目录提供 metadata.jsonl 文件,每行一个试验,便于通过 Hugging Face 数据集查看器浏览。评估配置为:agent 采用 Terminus-2 v2.0.0,JSON 解析器,最大 500 轮;模型本地部署于 SGLang,采样温度 0.1,top_p 0.95,最大 token 32768,禁用思考;输入 token 限制 86016,每试验 agent 超时 18000 秒;环境为每个试验使用一个短暂的 Daytona 云沙箱。数据已进行清理,移除了内部集群路径、URI、推理端点代理主机名/IP、云组织标识符等基础设施细节,但保留了沙箱 ID 和任务相关秘密(如测试用 HuggingFace token)。注意:奖励是二值(0.0 或 1.0),平均值为解决率;同一配置重复运行间差异约 12 个百分点;基础设施错误(如 Daytona 内部错误)不代表模型失败。该数据集可用于研究 agent 行为、可重复性、上下文压缩影响以及工具使用场景。

创建时间:
2026-09-09
搜集汇总
数据集介绍
T1-Terminal-Bench-2.1-Trajectories 数据集图片
构建方式
该数据集源自对1220亿参数规模T1模型在Terminal-Bench 2.1基准上的系统性评估,采用Terminus-2智能体框架驱动完整交互流程。构建过程在完全相同的冻结配置下独立执行两轮89项任务测试,每轮试验均部署于独立的Daytona云沙箱环境,智能体以JSON格式输出分析、规划与命令序列,终端反馈则作为用户步骤回传。所有奖励与指标在数据清洗前已提取至元数据文件,随后移除内部集群路径、推理端点及云组织标识等基础设施信息,最终以ATIF-v1.7轨迹格式完整保留智能体与终端交互的每一步骤。
特点
数据集的核心特征在于其显式呈现的噪声水平与完整可追溯的轨迹结构。两次重复运行的均值虽均落在0.6404,但逐任务通过集合存在差异,揭示出约12个百分点的运行间波动,从而避免单一数值对确定性的误导。轨迹文件中智能体的JSON响应囊括分析、计划与击键命令数组,用户步骤则忠实记录终端输出,上下文压缩机制通过摘要三元组与续接轨迹片段得以完整保留,确保长程任务的重建不致遗漏。此外,经脱敏处理后仍刻意保留智能体自身沙箱内的路径与标识,以维持任务内容的真实语义。
使用方法
使用该数据集时,研究者可通过仓库根目录的metadata.jsonl快速浏览每次试验的奖励、任务名称、令牌计数及异常类型等扁平化信息。加载特定轨迹需读取trajectory.json文件,并依据continued_trajectory_ref链接依次串联后续续接片段,以还原经上下文压缩后的完整回合序列。每步记录包含步骤标识、时间戳、来源及消息内容,便于逐轮分析智能体的推理与终端反馈。需注意奖励为二值语义,均值即求解率,且DaytonaInternalServerError等基础设施异常不应归因于模型能力不足,跨运行比较应聚焦于逐任务奖励字段而非总体均值。
背景与挑战
背景概述
随着大语言模型逐步演化为可自主调用工具并执行多步操作的智能体,评估其在真实计算机终端环境中的任务完成能力已成为学术界与工业界关注的焦点。Terminal-Bench系列基准为此提供了标准化测试床,而T1-Terminal-Bench-2.1-Trajectories数据集由Junyao Yang于2026年构建,记录了基于122B参数Qwen3.5架构的T1模型在Terminus-2智能体框架下于Terminal-Bench 2.1上完成的全部轨迹。该数据集覆盖89项任务、两次独立重复运行,完整保留了命令行交互、上下文压缩与终端录屏等多模态信息,为研究智能体行为稳定性、工具使用模式及奖励噪声提供了珍贵的细粒度素材,对提升终端智能体的鲁棒性与可复现性具有重要参考价值。
当前挑战
该数据集所对应的领域问题在于如何在高度开放且状态多变的终端环境中实现可靠的任务求解,其核心挑战体现为:终端命令具有不可逆性与强副作用,智能体须在缺乏显式状态反馈的条件下精准权衡探索与利用。构建过程中同样面临多重挑战:基础设施层面的沙箱错误与超时异常会与模型自身失败相互混淆,需仔细甄别;推理过程中的上下文压缩要求对历史信息进行摘要与续接,增加了轨迹重建的难度;两次重复运行间约12个百分点的任务通过率波动表明噪声底限显著,单一数值难以可靠反映模型能力;此外,原始日志需在移除内部路径、密钥与端点信息的同时保留任务本身所需的敏感内容,对数据脱敏策略提出了精细化的平衡要求。
常用场景
经典使用场景
在智能体与工具调用研究的浪潮中,该数据集以完整轨迹的姿态承载了Terminal-Bench 2.1基准上的经典评测场景。其核心用途在于对T1模型在Terminus-2脚手架下执行89项终端任务的全过程进行细粒度复盘,每一步均记录来源、时间戳与终端输出,并配备可回放的asciinema录像。研究者可借此逐轮审视模型的分析、规划与命令生成,直观判断其在长程交互中的决策质量与错误模式,从而为智能体能力评估提供具备时间纵深的行为样本。
解决学术问题
针对智能体评测中长期存在的可复现性与噪声归因难题,该数据集以两次独立重复运行回应了单一均值掩盖方差的困境。它使研究者能够区分模型真实失败与沙箱基础设施异常,并显式呈现上下文压缩对轨迹连续性的影响。通过对全部89次试验取均值的奖励口径,错误试验以零分计入,避免了选择性汇报。这一设计为强化学习与工具使用研究提供了可比较、可审计的经验基础,推动了评测方法学的严谨化。
衍生相关工作
该数据集衍生出一系列围绕智能体轨迹分析、上下文压缩策略与评测协议改进的后续工作。研究者以其为基准,探索从原始轨迹中学习工具使用策略、训练奖励模型或进行过程监督的方法;上下文压缩三件套的结构亦启发对长程记忆机制的专门研究。同时,其关于重复运行噪声与基础设施归因的披露,推动了基准评测报告规范的讨论,并催生对Terminal-Bench系列任务更细粒度的难度与错误分类研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

