pinecone/core-2020-05-10-deduplication
收藏资源简介:
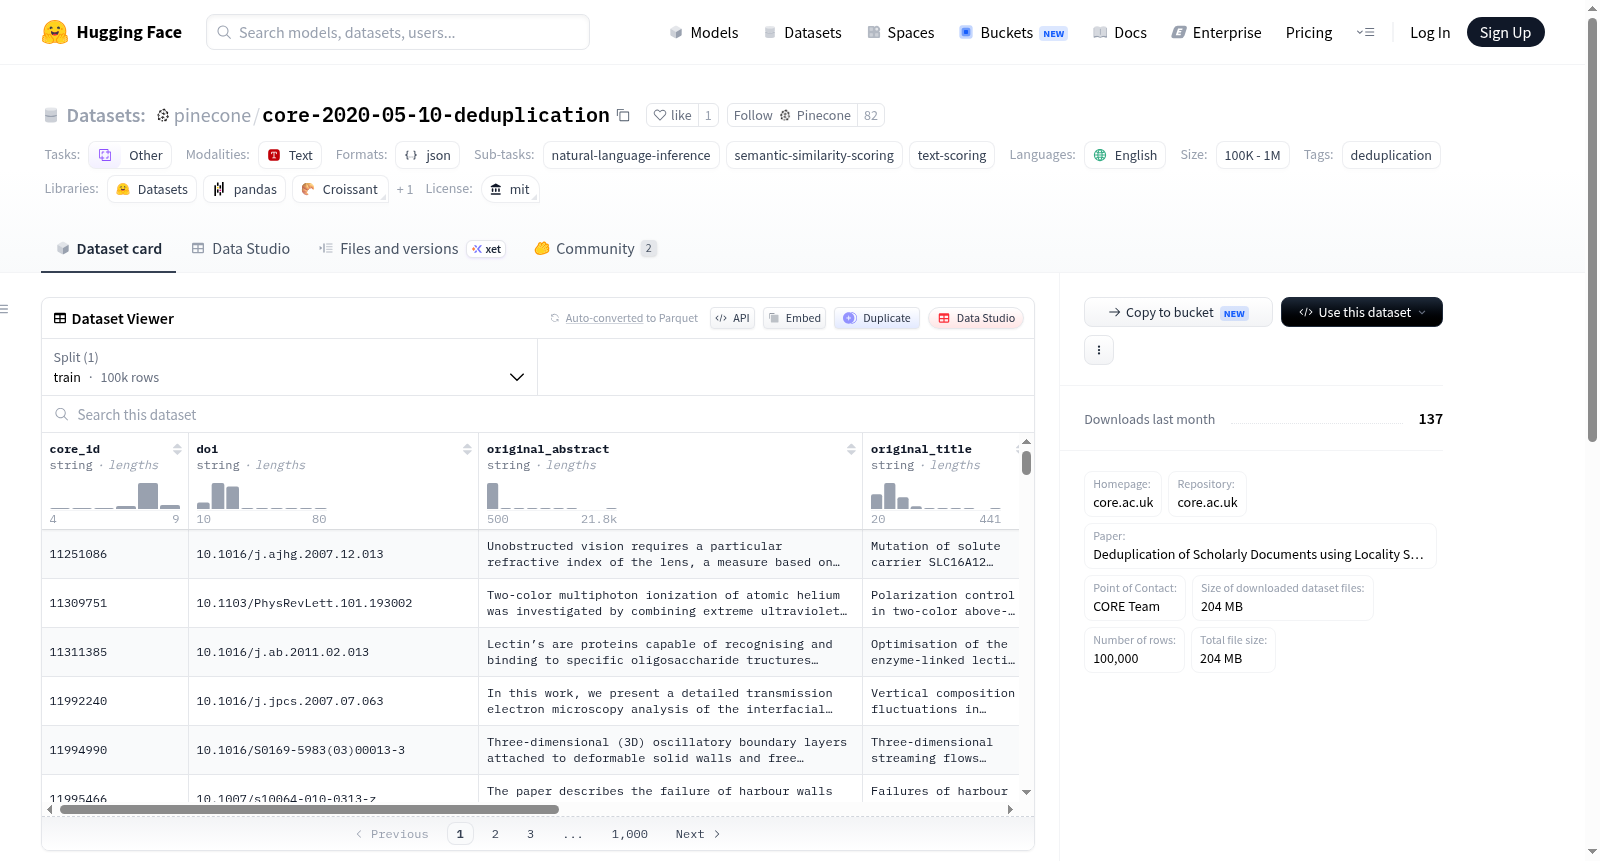
--- annotations_creators: - unknown language_creators: - unknown language: - en license: - mit multilinguality: - monolingual size_categories: - 100K<n<1M source_datasets: - unknown task_categories: - other task_ids: - natural-language-inference - semantic-similarity-scoring - text-scoring pretty_name: CORE Deduplication of Scholarly Documents tags: - deduplication --- # Dataset Card for CORE Deduplication ## Dataset Description - **Homepage:** [https://core.ac.uk/about/research-outputs](https://core.ac.uk/about/research-outputs) - **Repository:** [https://core.ac.uk/datasets/core_2020-05-10_deduplication.zip](https://core.ac.uk/datasets/core_2020-05-10_deduplication.zip) - **Paper:** [Deduplication of Scholarly Documents using Locality Sensitive Hashing and Word Embeddings](http://oro.open.ac.uk/id/eprint/70519) - **Point of Contact:** [CORE Team](https://core.ac.uk/about#contact) - **Size of downloaded dataset files:** 204 MB ### Dataset Summary CORE 2020 Deduplication dataset (https://core.ac.uk/documentation/dataset) contains 100K scholarly documents labeled as duplicates/non-duplicates. ### Languages The dataset language is English (BCP-47 `en`) ### Citation Information ``` @inproceedings{dedup2020, title={Deduplication of Scholarly Documents using Locality Sensitive Hashing and Word Embeddings}, author={Gyawali, Bikash and Anastasiou, Lucas and Knoth, Petr}, booktitle = {Proceedings of 12th Language Resources and Evaluation Conference}, month = may, year = 2020, publisher = {France European Language Resources Association}, pages = {894-903} } ```
annotations_creators: - 未知 language_creators: - 未知 language: - 英语 license: - MIT许可证 multilinguality: - 单语种 size_categories: - 100K<n<1M(数据量介于10万至100万之间) source_datasets: - 未知 task_categories: - 其他 task_ids: - 自然语言推理 - 语义相似度评分 - 文本评分 pretty_name: CORE学术文档去重数据集 tags: - 去重 --- # CORE学术文档去重数据集卡片 ## 数据集说明 - **主页:** [https://core.ac.uk/about/research-outputs](https://core.ac.uk/about/research-outputs) - **代码仓库:** [https://core.ac.uk/datasets/core_2020-05-10_deduplication.zip](https://core.ac.uk/datasets/core_2020-05-10_deduplication.zip) - **相关论文:** [《基于局部敏感哈希(Locality Sensitive Hashing)与词嵌入(Word Embeddings)的学术文档去重》](http://oro.open.ac.uk/id/eprint/70519) - **联系人:** [CORE团队](https://core.ac.uk/about#contact) - **下载数据集总大小:** 204 MB ### 数据集概览 CORE 2020去重数据集(官方文档地址:https://core.ac.uk/documentation/dataset)包含10万篇被标记为重复/非重复的学术文档。 ### 语言说明 本数据集采用英语编写,符合BCP-47标准编码`en`。 ### 引用信息 @inproceedings{dedup2020, title={基于局部敏感哈希(Locality Sensitive Hashing)与词嵌入(Word Embeddings)的学术文档去重}, author={Gyawali, Bikash与Anastasiou, Lucas与Knoth, Petr}, booktitle = {第12届语言资源与评估会议论文集(Proceedings of 12th Language Resources and Evaluation Conference)}, month = 5月, year = 2020, publisher = {法国欧洲语言资源协会(France European Language Resources Association)}, pages = {894-903} }
数据集概述
基本信息
- 名称: CORE Deduplication of Scholarly Documents
- 语言: 英语 (
en) - 许可证: MIT
- 多语言性: 单语种
- 大小: 100K<n<1M
- 任务类别: 其他
- 任务ID:
- natural-language-inference
- semantic-similarity-scoring
- text-scoring
- 标签: deduplication
数据集描述
- 摘要: CORE 2020 Deduplication dataset 包含100K学术文档,标记为重复/非重复。
- 下载大小: 204 MB
引用信息
@inproceedings{dedup2020, title={Deduplication of Scholarly Documents using Locality Sensitive Hashing and Word Embeddings}, author={Gyawali, Bikash and Anastasiou, Lucas and Knoth, Petr}, booktitle = {Proceedings of 12th Language Resources and Evaluation Conference}, month = may, year = 2020, publisher = {France European Language Resources Association}, pages = {894-903} }