
walter133/address-ner
收藏原始信息汇总
数据集概述
许可证信息
- 许可证类型: Apache-2.0
搜集汇总
数据集介绍
构建方式
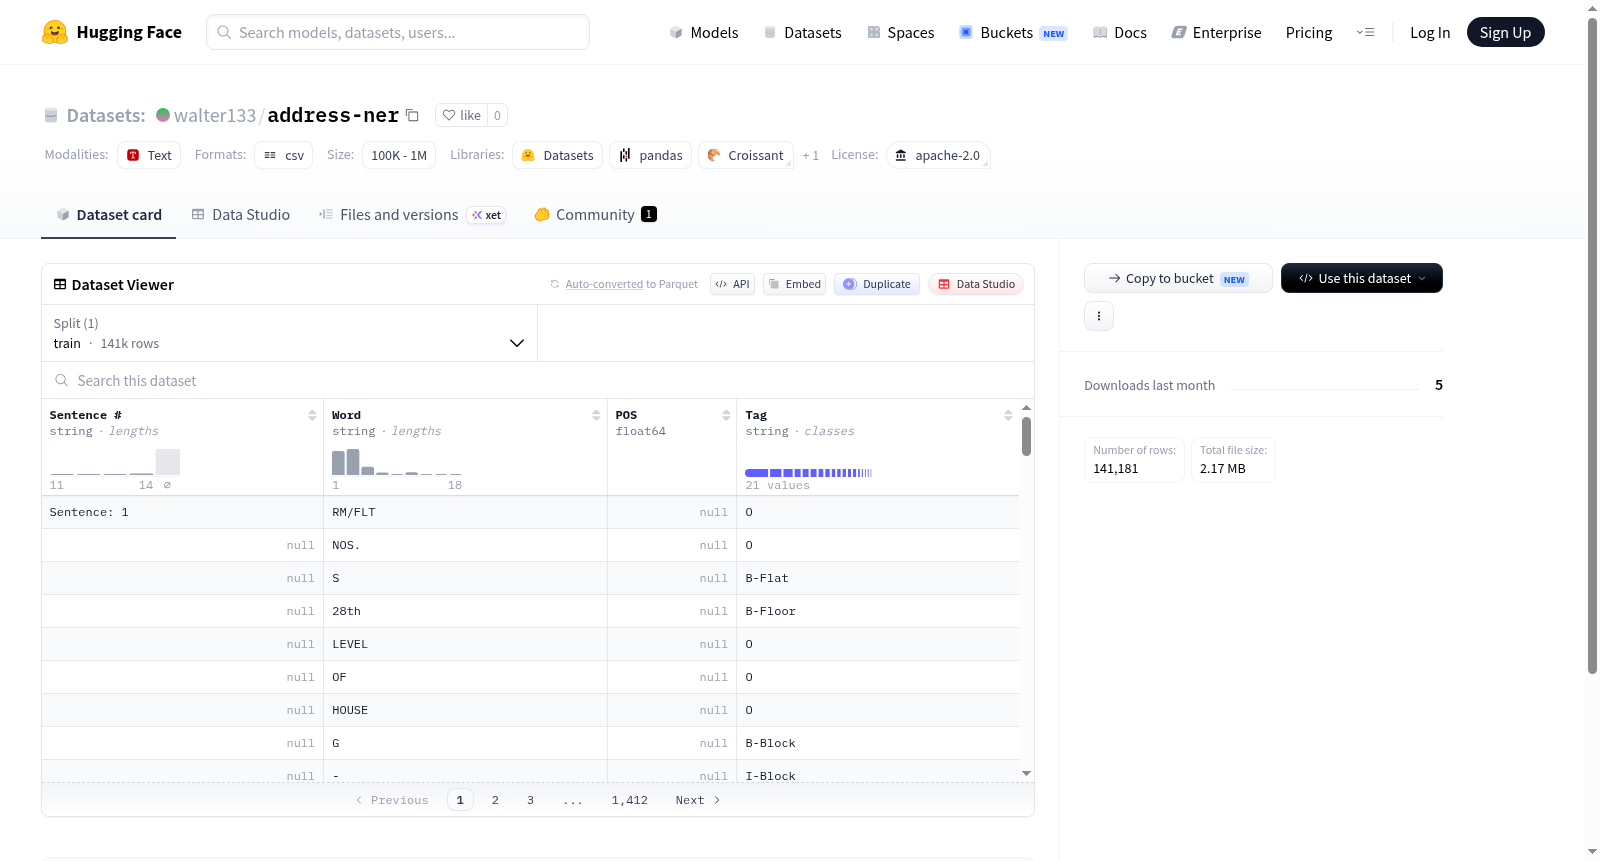
在命名实体识别(NER)领域,地址信息作为非结构化文本中的关键要素,其精准提取对地理信息系统、物流配送及智能客服等应用具有重要价值。walter133/address-ner数据集基于Apache-2.0开源协议发布,旨在为地址实体识别任务提供标准化训练资源。该数据集通过系统化采集网络公开文本中的地址相关语料,经人工标注与多轮校验构建而成,确保了实体边界与类别标签的准确性。标注体系聚焦于地址核心组成单元,如行政区划、街道名、门牌号等,形成了层次分明的标签结构,为模型学习地址的语义与语法模式提供了坚实的数据基础。
使用方法
使用该数据集时,研究者可将其直接用于训练基于Transformer的序列标注模型,如BERT或RoBERTa,通过加载预训练权重并在该数据集上进行微调,实现地址实体的高效识别。具体操作中,数据集以标准格式提供,便于集成至HuggingFace的datasets库,用户仅需通过简单的API调用即可完成数据加载与预处理。建议按照常见的训练-验证-测试划分策略进行模型评估,并利用条件随机场(CRF)作为解码层以提升实体边界预测的鲁棒性。对于实际应用,微调后的模型可部署至地址标准化、地理编码等下游任务中,发挥其精准抽取能力。
背景与挑战
背景概述
在自然语言处理领域,命名实体识别(NER)是一项基础而关键的任务,旨在从非结构化文本中识别出具有特定意义的实体,如人名、地名、机构名等。地址信息作为地理实体的一种重要表现形式,在物流、政务、金融等多个行业具有广泛的应用价值。walter133/address-ner数据集由研究人员于近期构建,专注于地址命名实体的识别任务,旨在解决中文地址文本中复杂结构、层级关系以及多粒度实体标注的难题。该数据集以Apache-2.0许可证发布,为学术界和工业界提供了一个开放、可复用的资源,推动了地址解析与智能信息提取技术的发展。
当前挑战
该数据集所面临的挑战主要体现在两个方面。其一,地址命名实体识别本身具有高度复杂性,中文地址通常包含行政区划、道路名称、门牌号、邮政编码等多层级信息,实体边界模糊且存在嵌套结构,传统序列标注模型难以精准捕捉其层级依赖关系。其二,数据集的构建过程面临标注一致性与覆盖率的平衡难题,由于地址表达方式多样,不同地区、不同书写习惯导致标注标准难以统一,且高质量标注需要大量领域知识,人工成本高昂。此外,数据集规模有限,可能无法覆盖所有地址变体,模型泛化能力面临严峻考验。
常用场景
经典使用场景
在自然语言处理领域,命名实体识别(NER)是信息抽取的核心任务之一,而地址实体识别因其复杂的层级结构和多变的表达方式,成为NER研究中的难点。walter133/address-ner数据集专注于中文地址实体的标注与识别,为训练和评估地址NER模型提供了高质量的语料资源。该数据集最经典的使用场景是作为序列标注任务的基准数据,研究人员可借助条件随机场(CRF)、双向长短期记忆网络(BiLSTM)或预训练语言模型(如BERT)等框架,训练模型精准识别地址中的省、市、区、街道、门牌号等细粒度实体,从而推动地理信息抽取技术的进步。
解决学术问题
该数据集有效缓解了地址NER研究中标注数据匮乏与领域适配性不足的困境。传统NER数据集多聚焦于通用实体(如人名、地名),缺乏对地址结构深层语义的建模,而walter133/address-ner通过精细化的标签体系,解决了地址实体边界模糊、嵌套关系复杂等学术难题。研究者得以探索多粒度地址解析算法,验证跨域迁移学习与少样本学习策略的效能,并推动基于注意力机制的模型对地址层级依赖关系的捕获。这一贡献不仅丰富了NER领域的评价基准,也为地理文本挖掘、智慧城市信息整合等研究方向奠定了数据基础。
实际应用
在实际应用中,walter133/address-ner数据集训练出的模型可赋能物流配送、电商平台、地图导航与政务系统等场景。例如,自动解析用户填写的非结构化地址信息,将其转化为标准化结构数据库,提升快递分拣与路径规划的效率;在智能客服中快速提取对话文本中的位置关键词,辅助应急响应与位置服务推荐。此外,该数据集还可用于城市管理中的地址纠错与补全,助力不动产登记、人口统计等民生领域的自动化处理,显著降低人工校验成本,加速数字化转型进程。
数据集最近研究
最新研究方向
在自然语言处理领域,命名实体识别(NER)作为信息抽取的核心任务,正日益聚焦于细粒度与领域特定实体的精准识别。walter133/address-ner数据集专注于地址实体的标注与识别,这一研究方向与智慧城市、物流配送、地理信息系统等热点应用紧密相连。前沿研究正利用此类数据集,结合深度学习与预训练语言模型,探索复杂地址结构中的层级化实体抽取,如街道、楼栋、邮编等元素的联合建模。该数据集的出现推动了地址解析技术的标准化进程,有助于提升地理位置服务的智能化水平,尤其在处理非结构化文本中的地址信息时,展现出显著的实用价值与学术影响力。
以上内容由遇见数据集搜集并总结生成


