terminal_bench_2_a1_staqc_20260808_162054
收藏资源简介:
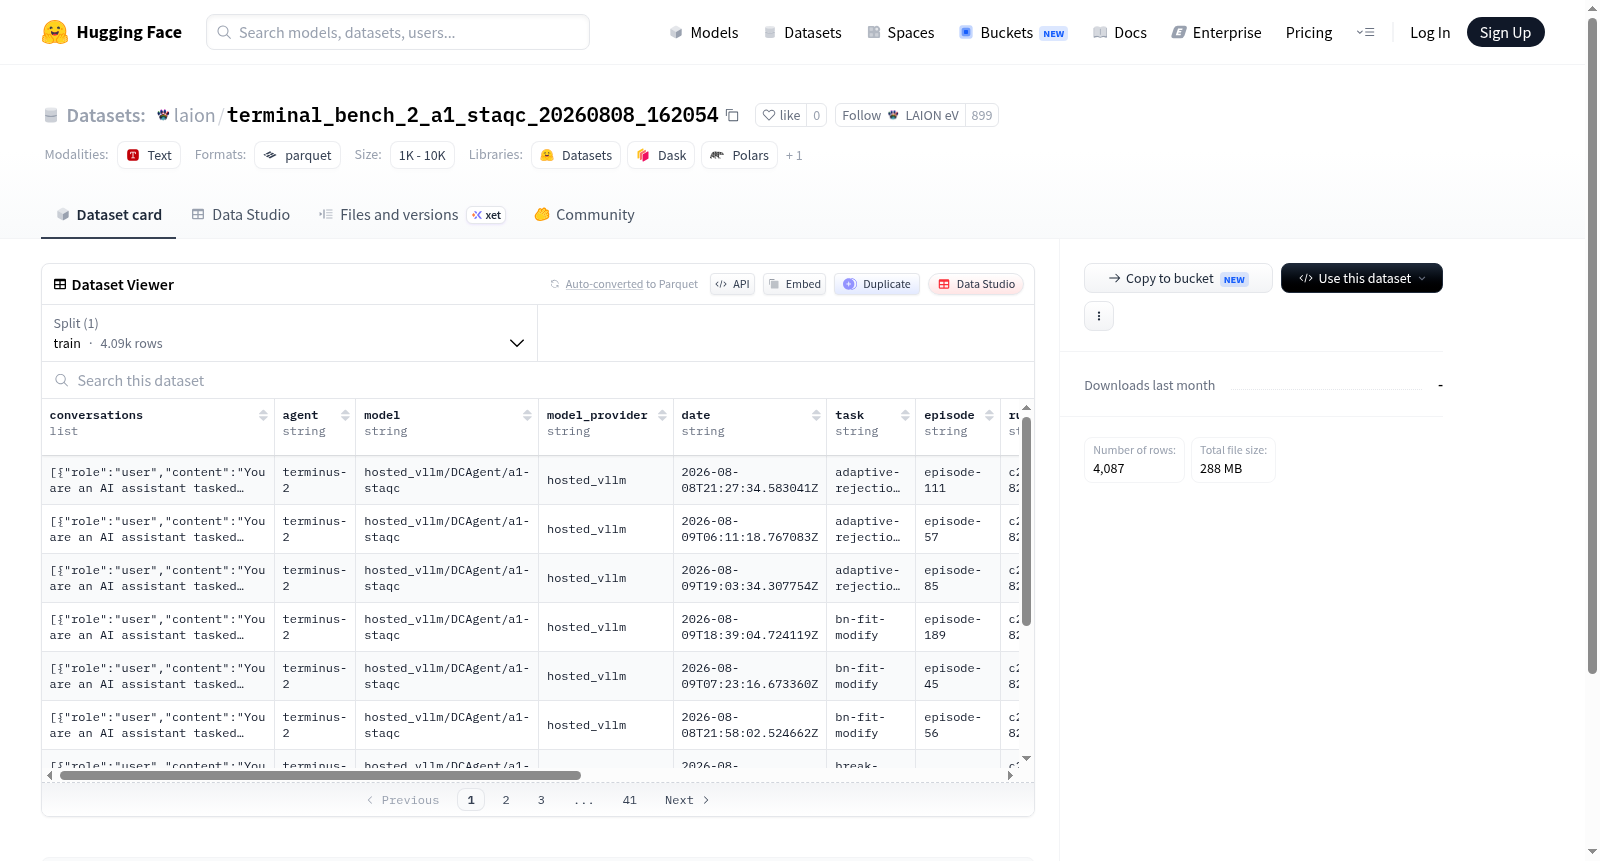
该数据集包含4087个训练样本,每个样本记录了一次多轮对话轨迹。对话以列表形式存储,每个对话回合包含角色(role)和内容(content)。此外,每个样本还附带了agent标识、使用的模型名称、模型提供商、日期、任务描述、episode编号、运行ID(run_id)、实验名称(trial_name)、最终结果(result)、验证器输出(verifier_output)以及轨迹来源(trace_source)。数据集可用于训练或评估对话代理、多轮对话系统、任务型对话模型,以及分析agent决策过程。
This dataset contains 4087 training samples, each recording a multi-turn dialogue trajectory. The dialogue is stored as a list, with each turn containing a role and content. Additionally, each sample includes agent identifier, model name, model provider, date, task description, episode number, run ID, trial name, final result, verifier output, and trace source. The dataset can be used for training or evaluating dialogue agents, multi-turn dialogue systems, task-oriented dialogue models, and analyzing agent decision processes.
数据集概述
该数据集名为 laion/terminal_bench_2_a1_staqc_20260808_162054,由 LAION 发布,主要面向终端(Terminal)交互场景的评测基准(Benchmark),记录智能体(Agent)在终端任务中的多轮对话与运行结果。
基本信息
- 数据集地址:https://huggingface.co/datasets/laion/terminal_bench_2_a1_staqc_20260808_162054
- 数据集大小:约 854 MB(dataset_size: 854,430,413 字节)
- 下载大小:约 287 MB(download_size: 287,554,265 字节)
- 数据划分:仅包含
train分割,共 4,087 条样本
数据字段
每条样本包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
列表(包含 role 和 content,均为字符串) |
多轮对话记录,role 代表角色(如用户/助手),content 为对话内容 |
agent |
字符串 | 智能体名称或标识 |
model |
字符串 | 使用的模型名称 |
model_provider |
字符串 | 模型提供商 |
date |
字符串 | 记录日期 |
task |
字符串 | 任务描述或标识 |
episode |
字符串 | 回合编号 |
run_id |
字符串 | 运行标识符 |
trial_name |
字符串 | 试验名称 |
result |
字符串 | 任务结果(如成功/失败) |
verifier_output |
字符串 | 验证器输出,用于结果校验 |
trace_source |
字符串 | 追踪来源(trace 的文件源) |
数据格式与配置
- 数据集包含一个默认配置(config_name:
default) - 数据文件存储于
data/train-*路径下(支持分片读取) - 数据格式为 Hugging Face Datasets 的标准格式,可直接加载使用
用途说明
该数据集适用于:
- 终端环境下的智能体任务评测
- 多轮对话建模与终端指令执行分析
- 验证模型在真实终端操作中的表现(基于
verifier_output与result字段) - 分析不同模型、提供商、日期及任务类型的运行差异
注意:数据集仅划分了训练集,未提供其他分割(如验证/测试)。数据集中没有图像、音频等多模态内容,全部为文本型结构化数据。