PursuitOfDataScience/openmath-reasoning-medley
收藏资源简介:
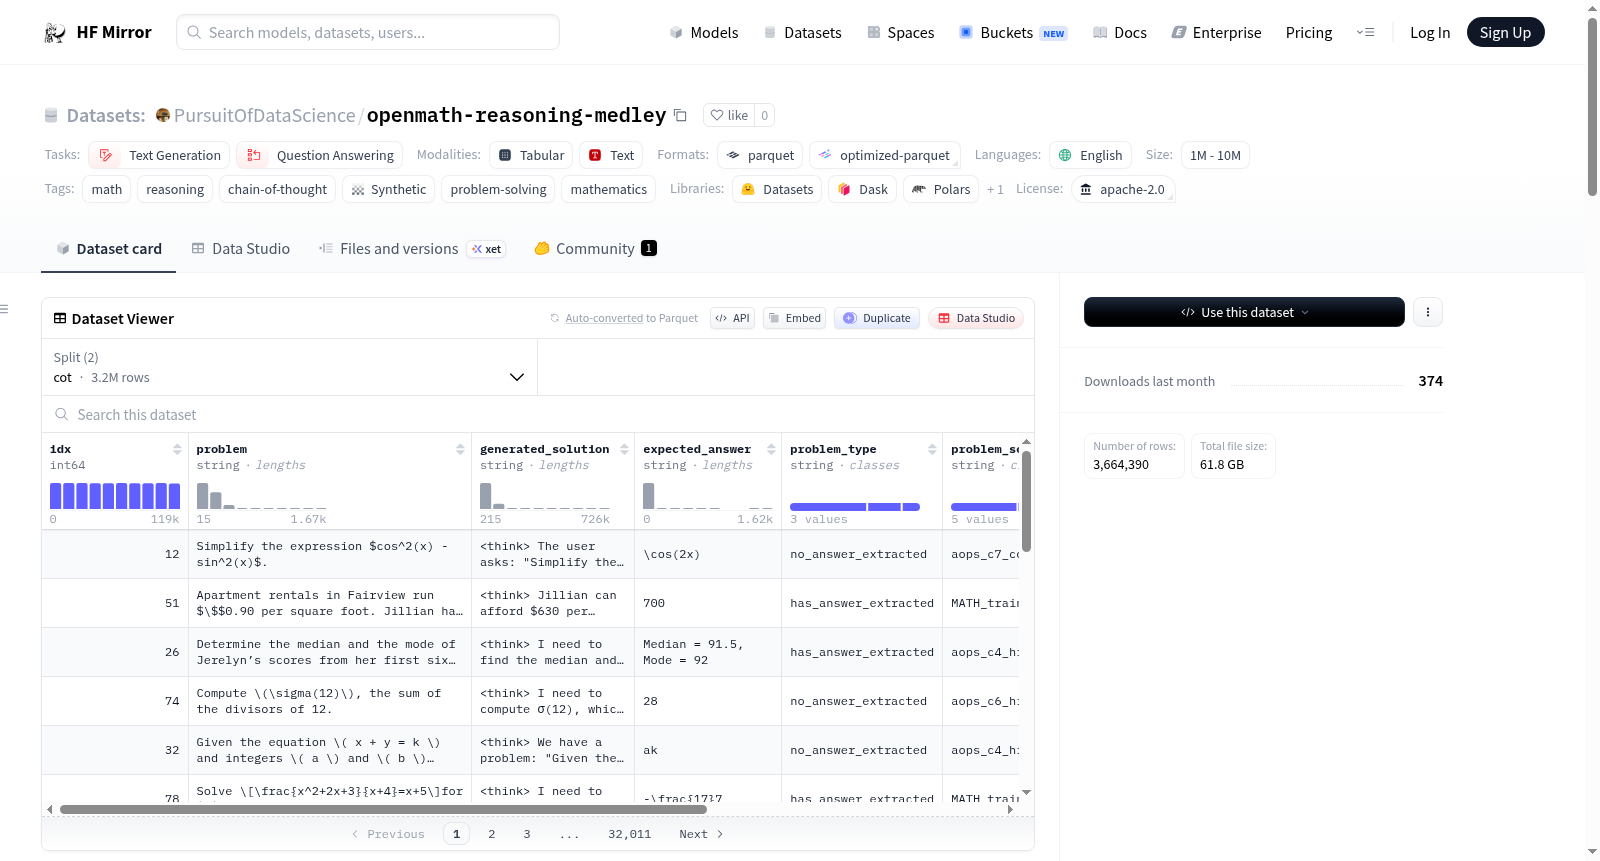
OpenMath Reasoning Curated数据集是一个经过整理的数学问题解决方案生成数据集,来源于nvidia/OpenMathReasoning。该数据集保留了源数据集中的问题和预期答案,并添加了在整理过程中生成的解决方案。数据集包含多个分片,如链式思考推理示例(cot)和工具集成推理示例(tir),每个示例包含原始数学问题、生成的解决方案、预期答案、问题类型、问题来源、生成模型和令牌数量等信息。数据集还提供了详细的统计信息、生成模型的详细信息、数据格式、示例代码、分片描述、引用和许可证信息。
The OpenMath Reasoning Curated Dataset contains curated math-solution generations for problems from nvidia/OpenMathReasoning. The dataset preserves the problems and expected answers from the source dataset and adds generated solutions during curation runs. It includes multiple splits such as chain-of-thought reasoning examples (cot) and tool-integrated reasoning examples (tir). Each example contains the original math problem, generated solution, expected answer, problem type, problem source, generation model, and token count. The dataset also provides detailed statistics, generation model information, data format, example code, split descriptions, citations, and license information.
数据集概述
数据集名称: OpenMath Reasoning Curated Dataset
数据集标识: PursuitOfDataScience/openmath-reasoning-medley
数据集来源
- 源数据集为 nvidia/OpenMathReasoning。
- 保留源数据集中的问题和预期答案。
数据集规模
| 指标 | 数值 |
|---|---|
| 数据总行数 | 4,097,950 |
| 总文件大小 | 62.8 GB |
| 最近一月下载量 | 1,371 |
数据集构成
数据集包含以下子集(Split):
| 子集名称 | 描述 | 数据行数 | 总Token数 | 平均Token数 |
|---|---|---|---|---|
| cot | 链式思维推理示例(Chain-of-thought) | 3,201,343 | 46,264,123,688 | 14,451 |
| tir | 工具集成推理示例(Tool-integrated reasoning) | 896,889 | 2,175,644,610 | 2,426 |
| genselect | 生成并选择的示例 | - | - | - |
| additional_problems | 额外多样化数学问题 | - | - | - |
总计: 4,098,232 条示例,48,439,768,298 个Token,平均 11,820 个Token/条。
数据字段
每条数据包含以下字段:
| 字段名 | 类型 | 描述 |
|---|---|---|
idx |
int | 源数据集中的索引 |
problem |
str | 原始数学问题 |
generated_solution |
str | 经过策展的模型输出,包含推理过程和最终解答 |
expected_answer |
str | 源数据集中的标准答案 |
problem_type |
str | 问题分类 |
problem_source |
str | 原始来源元数据 |
generation_model |
str | 生成该解答的具体模型标签 |
num_tokens |
int | 生成API报告的总Token使用量 |
数据格式
- 文件格式: parquet、optimized-parquet
- 数据模态: 表格(Tabular)、文本(Text)
- 语言: 英语(English)
- 数据量级: 1M - 10M 行
生成模型
用于生成解答的模型包括:
- MiniMax-M2.1、MiniMax-M2.5、MiniMax-M2.7
- deepseek/deepseek-v4-flash
- inclusionai/ling-2.6-1t
- mimo-v2.5-pro
- mistral-large-latest(已解析为 mistral-large-2512)
- nvidia/NVIDIA-Nemotron-3-Nano-30B
输出格式
- 解答采用
<think>...</think>包裹逐步推理过程,后接最终解答。 - MiMo-v2.5-pro 记录使用原生
thinking块(预算 120K Token),在策展时序列化为<think>...</think>标签。
任务标签
- 任务: 文本生成(Text Generation)、问答(Question Answering)
- 标签: math、reasoning、chain-of-thought、Synthetic、problem-solving、mathematics
许可证
Apache 2.0 License。源问题和预期答案保留归属于 NVIDIA 的 OpenMathReasoning 数据集。
引用
bibtex @misc{openmath-reasoning-curated, title = {OpenMath Reasoning Curated Dataset}, author = {PursuitOfDataScience}, year = {2026}, publisher = {HuggingFace}, howpublished = {url{https://hf-mirror.com/datasets/PursuitOfDataScience/openmath-reasoning-medley}} }
@misc{nvidia-openmathreasoning, title = {OpenMathReasoning}, author = {NVIDIA}, year = {2024}, publisher = {HuggingFace}, howpublished = {url{https://hf-mirror.com/datasets/nvidia/OpenMathReasoning}} }