tripmatch-ai-daily-plan-alternatives
收藏资源简介:
TripMatch AI Rich Daily Plan Alternatives 是一个公开的学术数据集,旨在通过大型语言模型(Gemma 3 或 Qwen 3)生成比原始旅行计划更丰富的每日计划替代方案。该数据集为 TripMatch AI 的升级版本,由教授分配任务产生。数据集包含 40 个样本(试点阶段),每个样本包括原始每日计划(daily_plan_original)和由 LLM 生成的丰富替代计划(daily_plan_alternative_rich),以及丰富的元数据,如目的地、持续时间、同伴、预算、节奏、主题、难度、推荐季节、主要想法、模型信息、生成参数、验证结果等。数据集的生成遵循严格的质量合同:替代计划必须保留原计划的关键属性(目的地、精确天数、同伴、预算、节奏、主题、难度、季节),与原始计划有显著差异,每天提供早上、下午、晚上和实用备注部分,详细程度至少是原计划的 2.2 倍,形成连贯的到达至离开行程,避免虚构实时价格、预订、可用性、营业时间、天气或安全保证,并通过自动结构、丰富度、多样性和相似性检查。该数据集适用于文本生成、旅行计划生成、LLM 比较和评估等任务。数据来源为 HuggingFace 上的 tripmatch-ai-dataset。生成的计划仅供旅行灵感参考,不构成预订或专业建议,用户需自行验证当前的可访问性、价格、法规、天气、可及性和官方安全指南。Gemma 的使用受 Google 的 Gemma 条款约束。
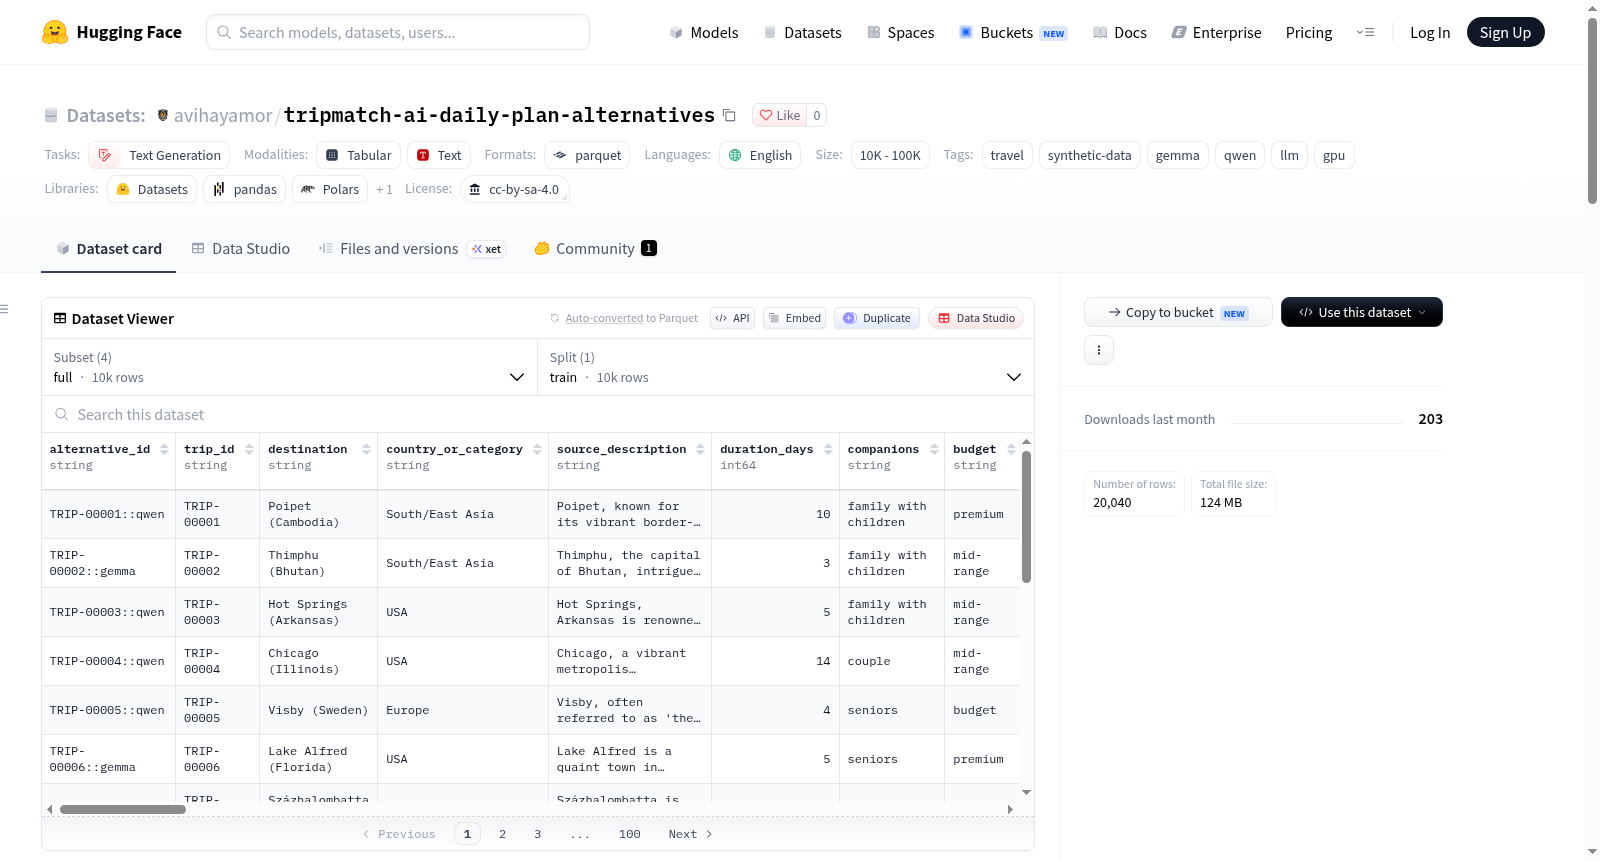
TripMatch AI Rich Daily Plan Alternatives is a public academic dataset designed to generate richer daily plan alternatives than the original travel plans using large language models (Gemma 3 or Qwen 3). This dataset is an upgraded version of TripMatch AI, produced from a professor-assigned task. It contains 40 samples (pilot phase), each including the original daily plan (daily_plan_original) and a rich alternative plan generated by the LLM (daily_plan_alternative_rich), along with rich metadata such as destination, duration, companions, budget, pace, theme, difficulty, recommended season, main idea, model information, generation parameters, validation results, etc. The dataset generation follows a strict quality contract: the alternative plan must retain the key attributes of the original plan (destination, exact number of days, companions, budget, pace, theme, difficulty, season), be significantly different from the original plan, provide morning, afternoon, evening, and practical notes for each day, have a level of detail at least 2.2 times that of the original plan, form a coherent arrival-to-departure itinerary, avoid fictional real-time prices, reservations, availability, opening hours, weather, or safety guarantees, and pass automatic structure, richness, diversity, and similarity checks. This dataset is suitable for tasks such as text generation, travel plan generation, LLM comparison and evaluation. The data source is the tripmatch-ai-dataset on HuggingFace. The generated plans are for travel inspiration only and do not constitute booking or professional advice; users should verify current accessibility, prices, regulations, weather, accessibility, and official safety guidelines. Use of Gemma is subject to Googles Gemma terms.
数据集概述
TripMatch AI — Rich Daily Plan Alternatives 是一个公开的学术数据集,属于 TripMatch AI 项目的教授指定升级版本。该数据集的核心目标是通过在 GPU 上运行的 Gemma 3 或 Qwen 3 模型,为原始旅行计划生成内容更丰富、结构更完整的替代每日行程。
基本信息
- 名称: TripMatch AI Rich Daily Plan Alternatives
- 许可证: cc-by-sa-4.0
- 语言: 英语
- 任务类别: 文本生成
- 数据规模: 少于 1K 条样本(当前 pilot 配置含 40 条训练样本)
- 标签: 旅行、合成数据、Gemma、Qwen、LLM、GPU
数据集配置
- 唯一配置: pilot
- 数据划分: 仅包含 train 划分,共 40 条示例,数据集大小为 227,004 字节,下载大小为 127,031 字节。
数据字段
数据集共包含 35 个字段,涵盖以下类别:
- 标识与元数据: alternative_id、trip_id、source_dataset、source_config、source_revision
- 行程属性: destination、country_or_category、duration_days、companions、budget、pace、route_type、primary_theme、secondary_theme、difficulty、recommended_season
- 内容字段: main_ideas、daily_plan_original(原始计划)、daily_plan_alternative_rich(新生成的丰富替代计划)
- 生成信息: alternative_model、model_family、prompt_version、prompt_techniques、generation_seed、generation_parameters、gpu_hardware、generation_seconds_batch_share
- 质量控制: repair_attempted、validation_passed、validation_errors
- 评估指标: original_word_count、alternative_word_count、richness_ratio、original_alternative_similarity、days_with_all_required_sections
质量要求
每个生成的替代计划必须满足以下条件:
- 保留原始计划的目的地、精确时长、同行者、预算、节奏、主题、难度和季节
- 与原始计划有显著差异
- 每天包含上午、下午、晚间和实用提示四个板块
- 详细程度至少是原始计划的 2.2 倍
- 形成连贯的从到达至离开的完整行程
- 避免虚构实时价格、预订信息、开放时间、天气或安全承诺
- 通过自动化的结构、丰富度、多样性和相似度检查,必要时进行一次 LLM 修复
生成模型
- google/gemma-3-4b-it
- Qwen/Qwen3-4B-Instruct-2507
Pilot 阶段使用相同的 20 个分层采样的原始行程分别由两个模型生成,以便公平对比。经过质量与运行时间评估后,生产版本将包含 10,000 个原始行程,每个模型各生成 5,000 个替代计划。
数据来源
原始数据来源于 TripMatch AI Dataset。
使用声明
生成的计划仅用于旅行灵感参考,不构成预订建议或专业咨询。用户需自行核实当前的开放情况、价格、法规、天气、无障碍设施及官方安全指南。使用 Gemma 模型需遵守 Google 的 Gemma 使用条款。