
遇见数据集

tahoebio/tahoe-de-rhaister

收藏
Hugging Face2026-06-01 更新2026-06-14 收录
官方服务:

资源简介:

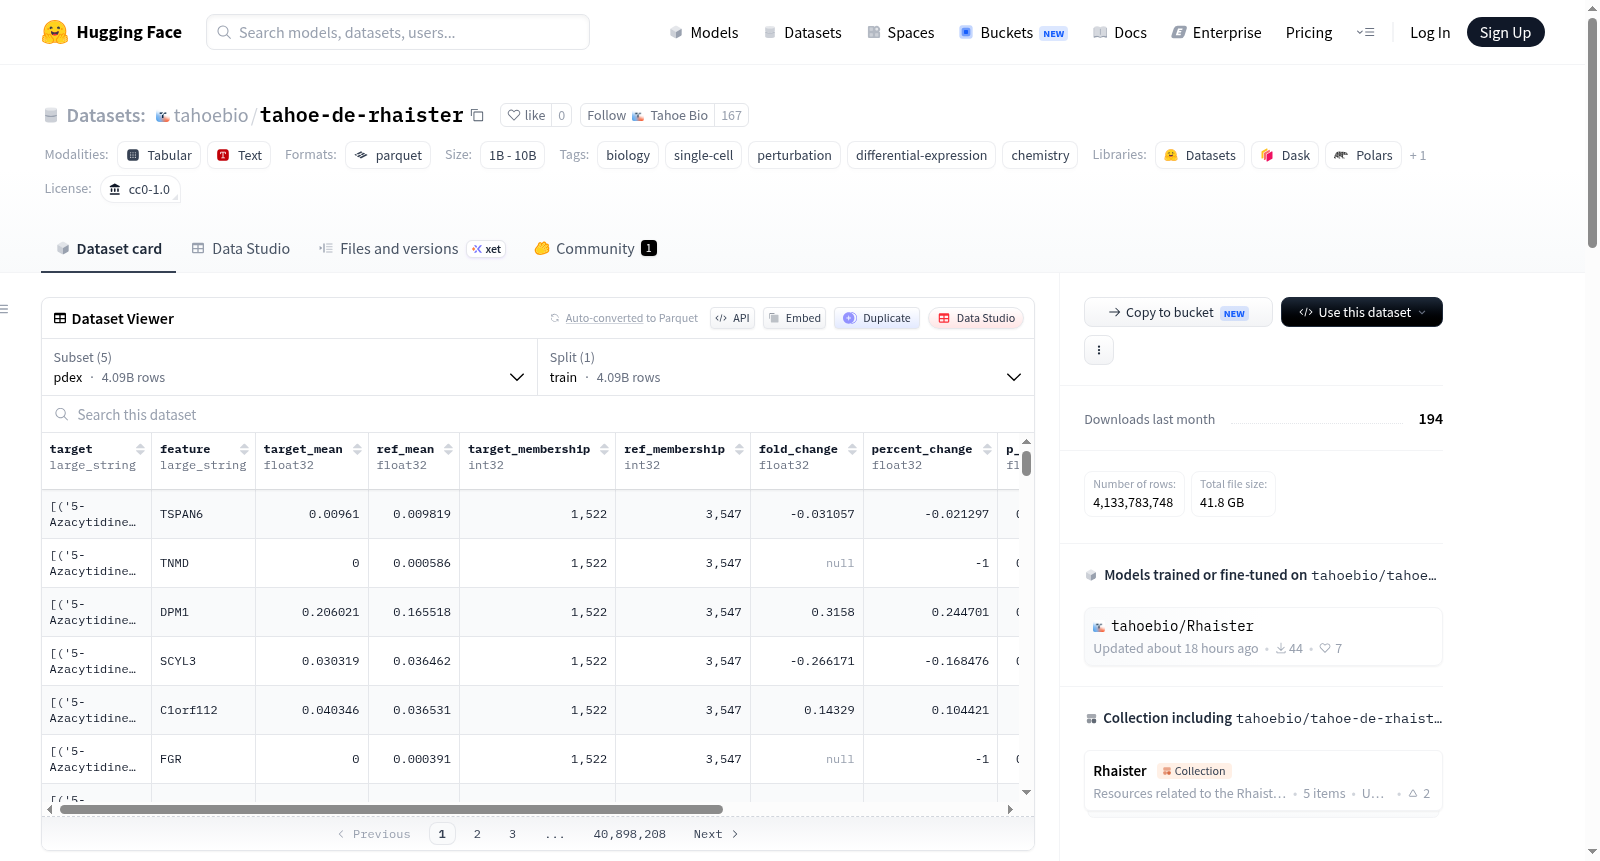
Tahoe-100M药物筛选差异表达汇总统计数据,包含50个癌细胞系×384种药物×3个剂量的差异表达摘要,是Rhaister模型的训练数据集之一。这些统计数据基于约1亿个原始单细胞(来自tahoebio/Tahoe-100M数据集)计算得出,包括每基因的折叠变化、显著性以及每个(细胞系,处理)的伪批量差异。数据集包含两个表格(pdex和cell_eval)以及用于零样本评估的对照状态参考,还有数据集定义文件(过滤/拆分标准)。

Differential-expression summary statistics for the Tahoe-100M drug screen including 50 cancer cell lines × 384 drugs × 3 doses, one of the training datasets for Rhaister. These are the statistics computed from the ~100M raw single cells of tahoebio/Tahoe-100M, including per-gene fold changes, significance, and pseudobulk deltas per (cell line, treatment). The repo includes two tables (pdex and cell_eval) plus the control-state references used for zero-shot evaluation, and the dataset-definition files (filtering / split criteria).
提供机构:
tahoebio
搜集汇总
数据集介绍
tahoebio/tahoe-de-rhaister 数据集图片
构建方式
Tahoe-100M Drug Screen Differential Expression Summary Statistics(简称tahoe-de-rhaister)数据集源自Tahoe-100M大规模单细胞药物筛选实验,覆盖50种癌细胞系、384种药物及3个剂量梯度,通过对约1亿个原始单细胞数据进行差异表达分析构建而成。数据集包含两种主要表结构:长格式的pdex表,每行记录特定细胞系、处理条件、基因和孔板组合的差异表达统计量,如log2倍数变化、Mann–Whitney U检验p值和Benjamini–Hochberg校正后的FDR值;宽格式的cell_eval表,每行对应一个细胞系-处理条件组合,以伪批量表达增量形式呈现约2000个基因的表达变化。此外,数据集还提供了DMSO对照状态下的表达均值、细胞系质心嵌入等参考表,用于零样本评估场景。
特点
该数据集的核心特点在于其规模宏大且信息丰富,总计约41亿行数据,涵盖了从单基因到全基因组的多种差异表达指标,包括倍数变化、百分比变化、显著性水平及细胞计数等。数据集采用分层结构,以96孔板作为匹配对照的基本单位,确保了统计比较的准确性。特别地,数据集中嵌入了精心设计的留出划分策略,通过TOML文件定义训练与测试集的拆分规则,确保每个测试细胞系和处理条件在训练集中均有单独出现,从而支撑更严谨的模型泛化能力评估。此外,数据集还提供了高度可变基因的质心嵌入,为下游的零样本预测任务奠定了坚实基础。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集,支持流式读取以处理大规模数据。具体加载时需指定配置名称,如使用'pdex'或'cell_eval'选项获取差异表达表,或使用'control_expression'、'cell_centroids'等配置获取零样本参考数据。数据以Parquet格式存储,每张表可独立加载为数据集对象,便于与现有单细胞分析框架(如Scanpy或PyTorch)集成。对于需要复现论文实验或进行个性化数据筛选的研究者,定义目录下的TOML文件提供了完整的过滤与拆分逻辑,可据此自定义训练-测试划分。此外,数据集的构建方法及统计细节已在相关预印本中详细阐明,为科研引用提供了明确来源。
背景与挑战
背景概述
单细胞转录组扰动实验为理解基因功能和细胞状态调控提供了前所未有的分辨率,然而大规模系统性扰动数据的稀缺性限制了深度学习模型在细胞生物学中的泛化能力。Tahoe-100M Drug Screen Differential Expression Summary Statistics数据集(简称Tahoe-DE-Rhaister)由张杰(Jesse Zhang)及其合作者于2025年创建,依托博德研究所等机构,旨在解决跨细胞系与药物组合的差异表达分析难题。该数据集整合了50种癌细胞系、384种药物及3个剂量下的约1亿个单细胞扰动转录组数据,通过计算每基因的log2差异倍数、曼-惠特尼U检验p值及伪批量表达变化,为Rhaister等基础模型提供了标准化训练基准。其发布填补了亿级规模单细胞扰动差异表达统计资料的空白,极大推动了上下文依赖性基因功能解码与药物反应预测研究。
当前挑战
该数据集面临的核心挑战在于:一是领域内如何在高维稀疏的单细胞数据中有效分离药物特异性信号与批次效应、细胞异质性噪声,当前依赖板匹配DMSO对照的差异检验虽控制部分变量,但跨细胞系和药物组合的联合建模仍受限于统计效力;二是构建过程中需处理约41亿行差异检验结果的存储与计算效率,研究者通过Parquet列式存储与流式加载设计缓解了内存瓶颈,但每细胞系-处理对下2000个基因的伪批量计算及板级聚合策略仍需在多轮筛选与质量控制间权衡假阳性率,而零样本评估所依赖的对照状态参考表也高度依赖原始单细胞数据的归一化一致性。
常用场景
经典使用场景
在单细胞生物学与药物基因组学的交叉领域,tahoe-de-rhaister数据集作为Tahoe-100M大规模药物筛选的差异表达汇总统计,为探究化合物扰动下的基因调控规律提供了标准化资源。其经典应用贯穿于差异表达分析的完整流程:研究者可借助pdex子集,针对特定癌细胞系与药物组合,提取每个基因的log2倍数变化、曼-惠特尼U检验p值及Benjamini-Hochberg校正后的假发现率,从而精准识别受显著影响的转录本;同时,cell_eval子集以伪批量表达差异的宽格式呈现,便于直接比较不同细胞系对同一处理的转录响应强度。该数据集还包含对照状态下(DMSO处理)的基因表达参考与细胞系质心嵌入,为基于迁移学习的零样本预测提供了基线,尤其适用于评估模型在未见过的药物-细胞系组合上的泛化能力。上述设计使得tahoe-de-rhaister成为连接原始单细胞测序数据与高通量功能验证之间的桥梁,推动了解析复杂扰动下基因表达动态变化的方法学进展。
衍生相关工作
基于tahoe-de-rhaister数据集的统计特性,学术界已衍生出一系列标志性工作。首先,该数据集是Rhaister模型(一种专为单细胞扰动响应设计的深度学习架构)的核心训练资源之一,其伪批量表达差异被用作回归目标,使模型学会在给定细胞系与药物信息时预测基因组尺度的表达变化,进而推广到其他稀缺药物组合。其次,研究者利用pdex中的FDR校正结果,开发了整合曼-惠特尼检验与贝叶斯层次模型的差异基因筛选工具,显著提升了在低表达基因上的发现率。此外,围绕零样本预测场景,涌现了多项关于跨细胞系迁移学习与领域适应方法的研究——例如利用cell_centroids嵌入进行对抗性域对齐,以消除批次效应并增强模型对未见细胞系的响应预测能力。在系统生物学领域,tahoe-de-rhaister还被用于验证基于网络传播的药物重定位算法,通过统计显著的差异表达基因推断药物的脱靶效应和作用通路模块。这些衍生工作不仅巩固了该数据集作为基准测试平台的地位,也推动了单细胞药物响应建模从描述性分析向预测性科学的范式转变。
数据集最近研究
最新研究方向
Tahoe-100M药物筛选差异表达汇总统计数据集(tahoe-de-rhaister)是单细胞扰动组学领域的前沿资源,聚焦于50种癌细胞系、384种药物及3种剂量下的表达扰动效应。该数据集揭示了基因表达的上下文依赖性调控机制,为药物靶点发现和耐药性研究提供了大规模统计基准。其零样本评估策略通过预训练模型推断未见细胞系—药物组合的响应,推动了可泛化的基因功能预测与精准医学建模。结合Rhaister框架,该数据集在解释复杂细胞状态转变及化学扰动谱系方面展现了关键价值,为理解肿瘤异质性和开发新型靶向疗法奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

