
遇见数据集

tenurehq/precisionmembench

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

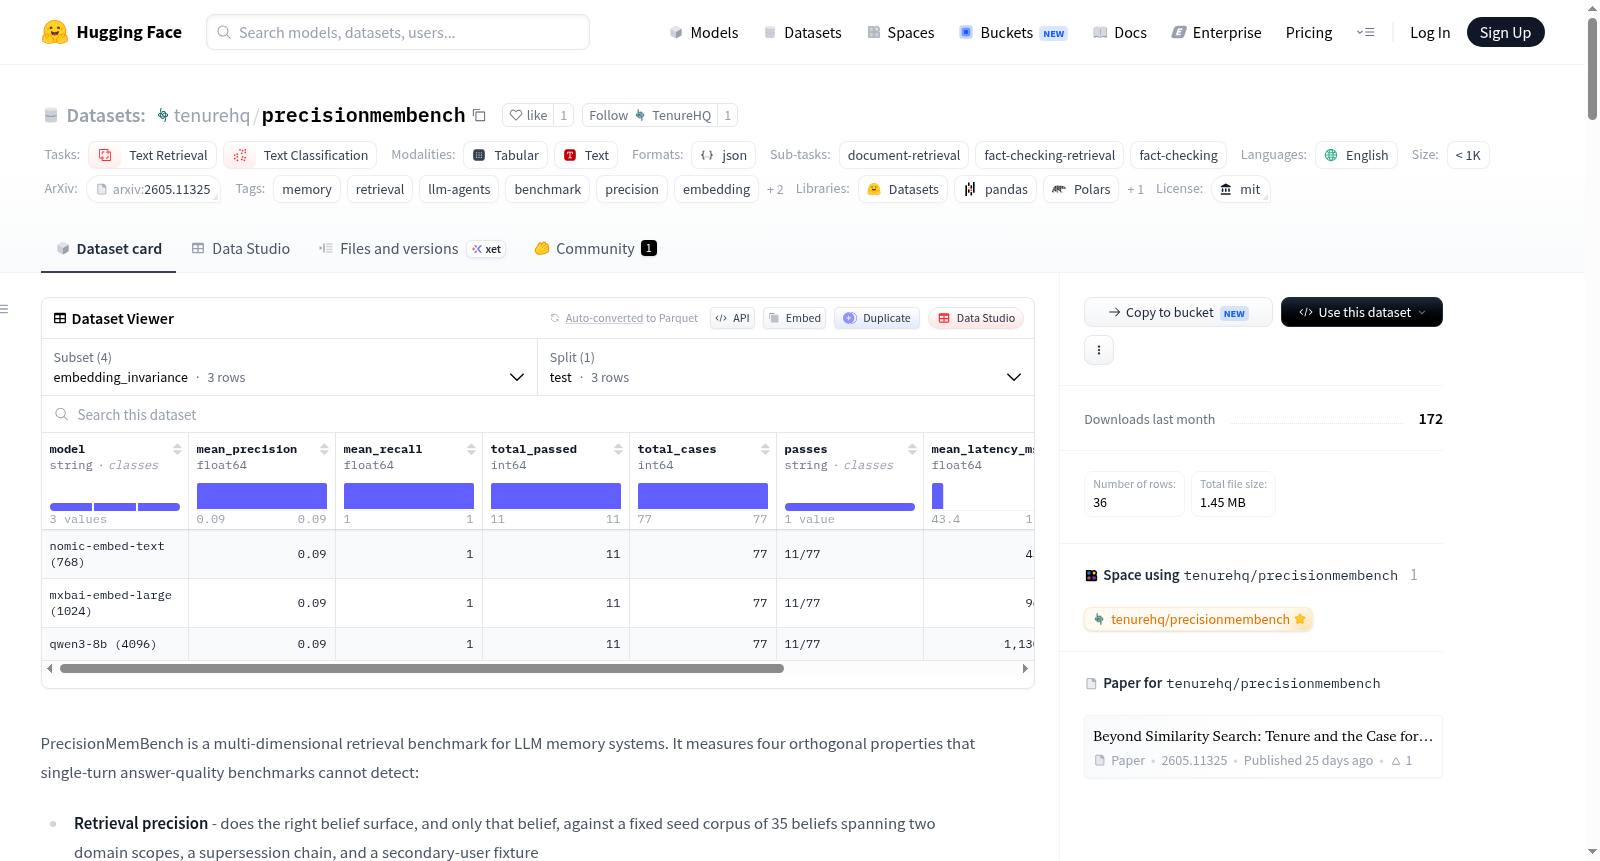
PrecisionMemBench是一个用于大型语言模型(LLM)内存系统的多维度检索基准。它测量了四个正交属性,这些属性是单轮答案质量基准无法检测的:1. 检索精度:在固定的35个信念种子语料库中,正确的信念是否浮现,且仅浮现该信念,涵盖两个领域范围、一个超链替换链和一个次要用户固定装置;2. 噪声隔离:在10轮会话中,离题漂移轮次引入的信念是否污染后续无关轮次的检索;3. 会话轮次延迟:在会话负载下,检索延迟是否相对于单轮基线下降;4. 信念可变性:在会话中更新的信念是否通过别名丰富飞轮在同一会话中立即浮现。这些属性是独立的,系统可能在某个属性上通过而在另一个上失败。基准包含89个案例,覆盖别名解析、范围消歧、超链替换链排除、模糊匹配、跨用户隔离、预算驱逐、排名稳定性、多轮主题漂移下的会话级噪声隔离等方面。数据集旨在评估LLM内存系统的检索性能,特别关注精度和噪声控制,适用于文本检索、文本分类、事实核查等任务。

PrecisionMemBench is a multi-dimensional retrieval benchmark for LLM memory systems. It measures four orthogonal properties that single-turn answer-quality benchmarks cannot detect: retrieval precision, noise isolation, session-turn latency, and belief mutability. These properties are independent. A system can pass on precision and fail on drift. A system can have clean single-turn latency and degrade 4x under session load. A system with no write-time mutation primitive cannot be scored on the fourth property at all, it is an architectural absence, not a performance difference. Every case specifies not just what the memory system must return, but what it must not. Noise is a hard failure, not an invisible inference cost. 89 cases covering: alias resolution, scope disambiguation, supersession chain exclusion, fuzzy matching, cross-user isolation, budget eviction, ranking stability, session-level noise isolation under multi-turn topic drift.
提供机构:
tenurehq
搜集汇总
数据集介绍
tenurehq/precisionmembench 数据集图片
构建方式
PrecisionMemBench 是一个专为评估大语言模型记忆系统检索能力而设计的多维基准测试集。该基准通过精心构建的89个测试用例,系统性地测量了四个独立属性:检索精度、噪声隔离能力、会话轮次延迟以及信念可变性。其种子语料库包含35条信念,横跨两个领域范围、一个超集链以及一个辅助用户固定配置,并通过10轮会话模拟来评估噪声隔离效果。每个测试用例不仅明确规定了记忆系统必须返回的内容,还严格界定了必须避免的内容,将噪声视为硬性失效而非不可见的推理成本。该基准还提供了嵌入模型不变性评估,验证不同规模与延迟的嵌入模型在精度上的稳定性。
使用方法
研究者可通过克隆GitHub仓库并使用npm运行评估命令,针对不同记忆提供者执行检索与会话评估。使用方式简洁灵活,只需设置MEMORY_PROVIDER环境变量并运行对应的测试文件,即可获得包括检索精度、召回率、延迟时间及噪声漂移分数在内的详细评估报告。新提供者只需在providers.config.json中添加配置对象即可参与评估,无需修改运行器代码。评估结果以JSONL格式存储,包含用例标识、类别、召回信念ID、成功标志及失败信息等字段,便于深入分析与基准排名。此外,提供导出脚本可将结果转换为HuggingFace格式以更新排行榜。
背景与挑战
背景概述
PrecisionMemBench是由Tenure团队于2026年创建的专门用于评估大语言模型记忆系统检索能力的多维度基准数据集。其核心研究问题在于,现有单轮答案质量的评测指标无法有效检测记忆系统在检索精度、噪音隔离、会话延迟和信念可变性等正交属性上的真实表现。该数据集通过89个精心设计的测试案例,涵盖别名解析、作用域消歧、超限链排除和跨用户隔离等场景,为记忆系统的结构化评估提供了全新的方法论框架。其开创性在于揭示了传统基于生成模型的评估方式会掩盖检索噪音问题,对推动LLM记忆系统从‘能检索’向‘精准检索’的转化产生了深远影响。
当前挑战
该数据集所解决的领域核心挑战在于,当前主流LLM记忆提供虽可实现接近1.0的召回率,但其平均检索精度低至0.04-0.11,且这一缺陷在生成模型环境封装下难以暴露——一旦移除生成层,噪音信息将直接导致下游结构化管道失效。构建过程中的主要挑战包括:如何设计互不干扰的正交评测维度(如进动与漂移隔离),如何构造必须精确区分信念而非仅靠语义相似度的测试用例,以及如何确保89个案例严格覆盖别名、作用域、超限链等复杂边界条件而不产生交叠。此外,跨会话噪音隔离测试需要构建长达10轮的对话流,每一轮都需精确标记噪音引入点与验证点,这对数据标注的粒度与一致性提出了极高要求。
常用场景
经典使用场景
PrecisionMemBench为评估大语言模型(LLM)记忆系统的检索质量提供了多维基准。其经典使用场景聚焦于量化记忆系统在四个正交维度上的性能:检索精度确保正确信念被唯一召回且无噪声;噪声隔离衡量在跨主题会话漂移中引入的无关信念是否污染后续检索;会话轮次延迟检测会话负载下的检索延迟退化;信念可变性验证信念在对话中更新后能否被及时检索。该基准涵盖89个案例,涉及别名解析、范围消歧、超级替换链排除、模糊匹配、跨用户隔离等任务。
解决学术问题
该基准解决了现有单轮回答质量评估无法捕捉的深层学术问题:检索噪声在LLM判别模式下被生成模型隐藏,但面向分类器等非生成式下游任务时,噪声会导致结构失效。研究揭示所有共享领域的信念在语义空间中聚集,余弦相似度无法有效区分,且此现象在嵌入模型维度差异下保持稳定(精度0.09不变)。PrecisionMemBench通过主动检索通过率、结构通过率和空通过率分类,首次提供了系统化的噪声隔离与精度验证方法,推动记忆系统从依赖生成补偿转向结构可靠的精准检索范式。
实际应用
实际应用中,PrecisionMemBench被用于评估和比较主流LLM记忆服务提供商的检索性能。例如,Tenure系统在该基准上取得了43/43的主动检索通过率和1.00的精度,而其他如Supermemory、gbrain等系统的主动通过率显著降低。该基准可嵌入持续集成流程,通过单一命令(如`MEMORY_PROVIDER=mem0 npx ava retrieval.external.eval.test.ts`)对任意支持的提供者进行检索评估,从而帮助开发者在部署前识别记忆系统的噪声容忍度和延迟瓶颈,特别适用于构建需要精确事实检索的客服、知识管理和医疗诊断系统。
数据集最近研究
最新研究方向
当前大语言模型记忆系统研究正从传统的单轮问答质量评估范式,转向对检索精度、噪声隔离能力、会话时延及信念可变性等多维正交属性的深度剖析。PrecisionMemBench基准的提出,揭示了现有主流记忆提供商在非生成式下游任务中的结构性缺陷——尽管在高召回率下表现尚可,但极低的平均精度(0.04-0.11)与跨嵌入模型的精度不变性(0.09)表明,余弦相似度在语义近邻区分上存在根本局限。该基准的89个测试案例(涵盖别名消解、超期链排除、会话级漂移噪声隔离等前沿场景)为构建真正可靠的长期记忆系统提供了精确的度量标尺,正推动该领域从“检索存在性”向“检索纯净性”的关键跃迁。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

