
遇见数据集

SupraLabs/supra-wild-titles-130k

收藏
Hugging Face2026-06-20 更新2026-06-21 收录
官方服务:

资源简介:

Wild Title是一个由SupraLabs策划的数据集系列,专门用于聊天标题生成的训练和评估。它包含从小众和高度专业化的对话样本中特意划分出来的数据,这些样本来自主要的标题数据集。这种分离使研究人员和开发者能够在更广泛、更全面的标题生成任务范围内稳健地训练和评估模型。与主要捕捉通用、高频对话的标准聊天标题数据集不同,Wild Title隔离了那些在传统基准测试中通常代表性不足的不常见、特定领域和边缘情况的交互。该数据集基于allenai/WildChat的用户交互日志,具有高度可变的序列长度,用户输入范围从简短的1-2字符短语到长达1000-2500词的提示。这种设计引入了结构多样性和分布方差,有助于小型语言模型(SLMs)和大型语言模型(LLMs)实现更优的泛化能力,同时通过减少对稀有或长尾令牌的参数分配来优化令牌效率。

Wild Title is a dataset series curated by SupraLabs designed specifically for training and evaluation in chat title generation. It comprises niche and highly specialized conversation samples intentionally partitioned from our primary title datasets. This separation enables researchers and developers to robustly train and evaluate models across a more diverse, comprehensive spectrum of title-generation tasks. Unlike standard chat title datasets that primarily capture general-purpose, high-frequency conversations, Wild Title isolates uncommon, domain-specific, and edge-case interactions that are typically underrepresented in conventional benchmarks. The dataset features highly variable sequence lengths, with user inputs ranging from brief 1–2 character phrases to extensive 1,000–2,500 word prompts. This design introduces explicit structural diversity and distribution variance, enabling Small Language Models (SLMs) and Large Language Models (LLMs) to achieve superior generalization capabilities while optimizing token efficiency by mitigating parameter allocation on rare or long-tail tokens.

提供机构:
SupraLabs
原始信息汇总

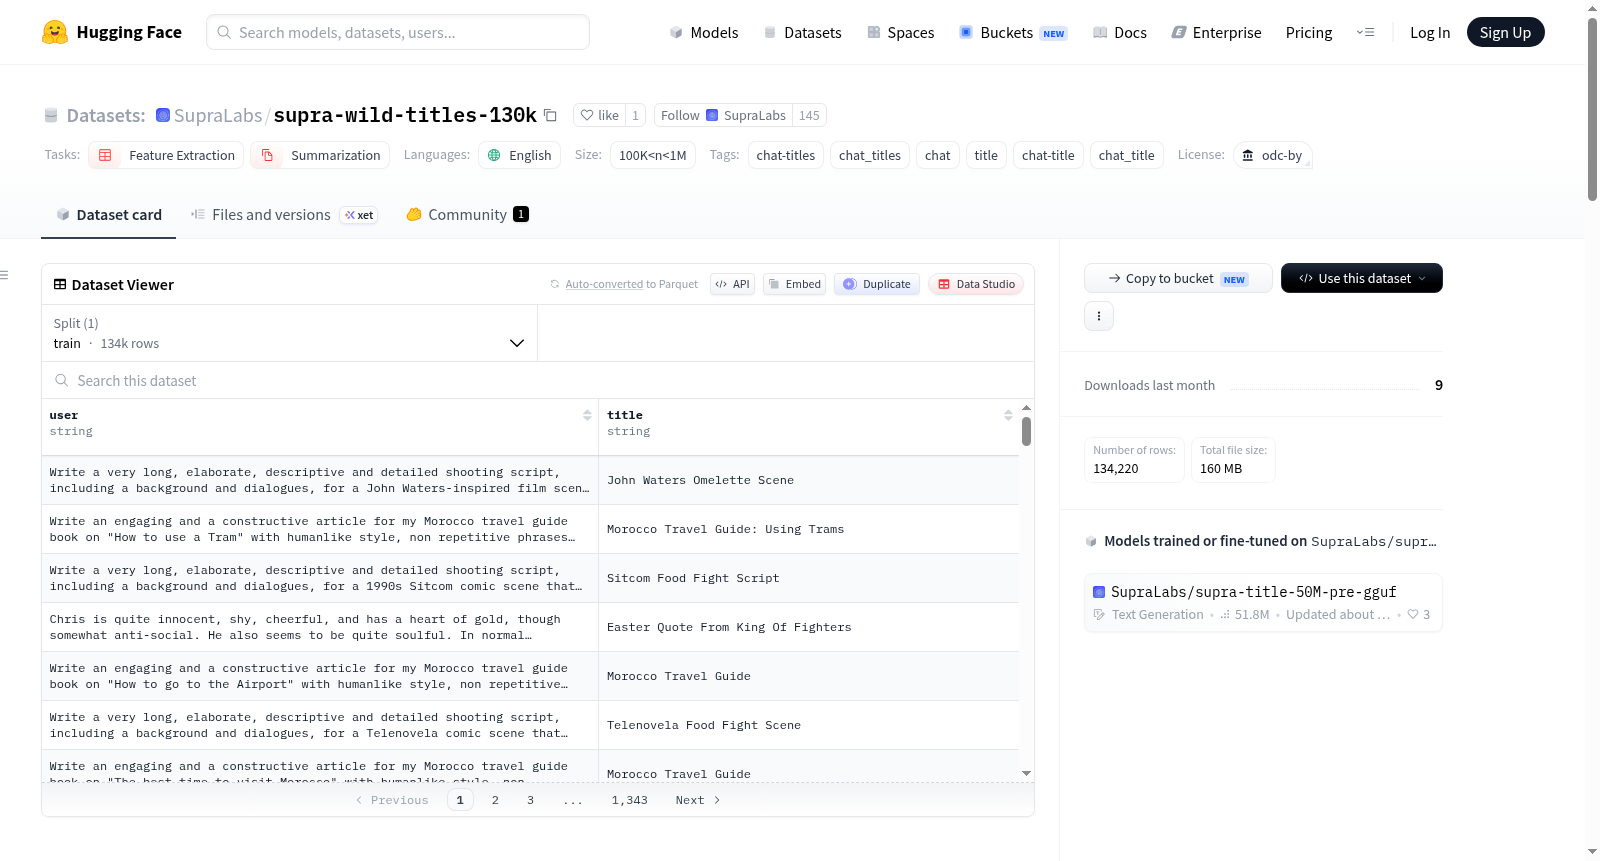
数据集概述:SupraLabs/supra-wild-titles-130k

  • 数据集来源:由 SupraLabs 提供,位于 Hugging Face 平台。
  • 任务类型:特征提取(Feature Extraction)、摘要生成(Summarization)。
  • 语言:英语(English)。
  • 数据集规模:100K 至 1M 条记录,具体为 134k 行。
  • 标签:chat-titles, chat_titles, chat, title, chat-title, chat_title。
  • 许可证:odc-by(Open Data Commons Attribution License)。
  • 数据集结构
    • 子集:default,包含 train 分割,共 134k 行。
    • 数据字段:user(字符串,用户查询内容)、title(字符串,生成的标题)。
  • 数据示例:包含各种用户查询及其对应标题,例如用户指令“Write a very long, elaborate, descriptive and detailed shooting script...”对应的标题为“John Waters Omelette Scene”,以及其他类似配对。
搜集汇总
数据集介绍
SupraLabs/supra-wild-titles-130k 数据集图片
构建方式
Wild Title系列数据集由SupraLabs精心打造,旨在服务于聊天标题生成任务的训练与评估。其构建核心在于从主要标题数据集中人为划分出小众、高度专业化的对话样本。这些样本源于allenai/WildChat仓库的用户交互日志,涵盖了在传统基准测试中罕见且鲜有体现的非常规、领域特定及边缘案例交互。通过这一分离策略,数据集专门捕获了复杂的长尾用户交互,从而弥补了标准语料库在覆盖细粒度、高度特定助手交互方面的分布缺口。
特点
该数据集具有高度的结构多样性与分布方差性。用户输入的序列长度变化极大,范围从仅1-2个字符的简短短语到长达1000-2500词的详尽提示,这与常规的统一语料库形成鲜明对比。这种设计引入了正则化效果,使小语言模型和大语言模型都能在优化令牌效率的同时,通过减轻对稀有或长尾令牌的参数分配,实现卓越的泛化能力。作为专门用于参数高效微调(如LoRA适配器训练)的理想候选,它有助于模型在专业化分布转移上对齐而不损害通用性能。
使用方法
研究者可利用该数据集进行聊天标题生成任务的定制化训练与评估。鉴于其长尾与专业化特性,推荐将其作为核心训练数据(如Supra-Titles-150K)的补充,用于参数高效微调方法,例如训练LoRA适配器,以增强模型在特定领域的表现。该数据集在Hugging Face上以宽松的ODC-BY许可协议发布,使用时需遵循其条款,并建议在研究中引用SupraLabs的归属声明。数据加载可直接通过Hugging Face的数据集库进行集成。
背景与挑战
背景概述
在对话式人工智能领域,为多轮交互生成精准、富有语义的标题是一项重要但尚未充分解决的课题。现有基准数据集多聚焦于通用高频对话,难以覆盖长尾、专业化的用户意图,限制了模型在真实场景中的泛化能力。为此,SupraLabs团队于2026年发布了Supra Wild Titles-130k数据集,依托Allen AI维护的WildChat语料库(Zhao等,2024),旨在填补这一分布间隙。该数据集汇聚了约13万条精心筛选的对话样本,其用户输入长度从简短问候到长达数千词的详尽指令不等,呈现出高度异质的结构和内容特性。通过引入这种固有多样性,该数据集成为训练和评估聊天标题生成模型的关键资源,尤其在参数高效微调(如LoRA)框架下,为小型与大型语言模型的泛化性提升提供了新的研究支点。
当前挑战
该数据集所面临的挑战首先体现在领域问题的复杂性上:聊天标题生成不仅需要模型精准捕捉对话的核心主题,还需应对用户意图的模糊性与多变性,例如从简单问候到复杂脚本撰写等极端不同的场景,现有模型在处理这种分布极不均匀的长尾交互时往往表现欠佳。其次,在数据集构建过程中,研究人员面临显著难点,包括从原始WildChat日志中高效识别并筛选出那些罕见且高度专业化的对话片段,同时确保未引入去重操作以保留原始分布特征,这虽然增强了多样性和正则化效果,但也对后续模型的训练稳定性和评估公平性提出了更高要求。此外,不同样本间的序列长度和语义密度的巨大差异,也为模型在不同任务间的迁移学习带来了额外障碍。
常用场景
经典使用场景
在自然语言处理领域,对话标题生成是一项兼具实用性与挑战性的任务。SupraLabs推出的supra-wild-titles-130k数据集,专为训练和评估聊天标题生成模型而设计,其独特之处在于聚焦于长尾、高专业化的对话样本。这些样本涵盖了从简短问候到超长、复杂指令的多样化交互,序列长度跨度极大,从而为模型提供了丰富的结构多样性。研究者常利用该数据集进行参数高效微调,如训练LoRA适配器,以在不牺牲通用性能的前提下适应专门分布偏移。这种特性使其成为检验和增强大语言模型泛化能力的理想工具。
实际应用
在实际应用中,该数据集极大地赋能了聊天机器人、虚拟助手和内容管理系统的标题自动生成功能。例如,在客服场景中,模型可基于用户详尽的咨询内容自动提炼出精准的摘要标题,提升工单处理效率;在教育领域,它能够为复杂的教学对话生成简洁明了的标识,便于知识库检索。此外,该数据集对极短输入(如单字问候)的涵盖能力,使其在实时消息应用中的上下文感知标题生成方面表现出色,显著优化了用户交互体验。其高度灵活的序列适应特性,也为资源受限场景下的小型语言模型部署提供了可行方案。
衍生相关工作
衍生自supra-wild-titles-130k的经典工作主要集中在参数高效微调与分布偏移适应领域。例如,研究者利用该数据集训练专门的LoRA适配器,以在不改变基础模型核心参数的情况下,精准提升模型对长尾对话标题目录的生成能力。该数据集还催生了一系列关于标题生成中序列长度建模的研究,推动了针对异步长度输入的解码策略优化。此外,由于原始数据来源于WildChat语料库,相关工作亦涉及对话日志的结构化提取与弱监督标注方法,为更广泛的对话理解与生成任务提供了借鉴与基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

