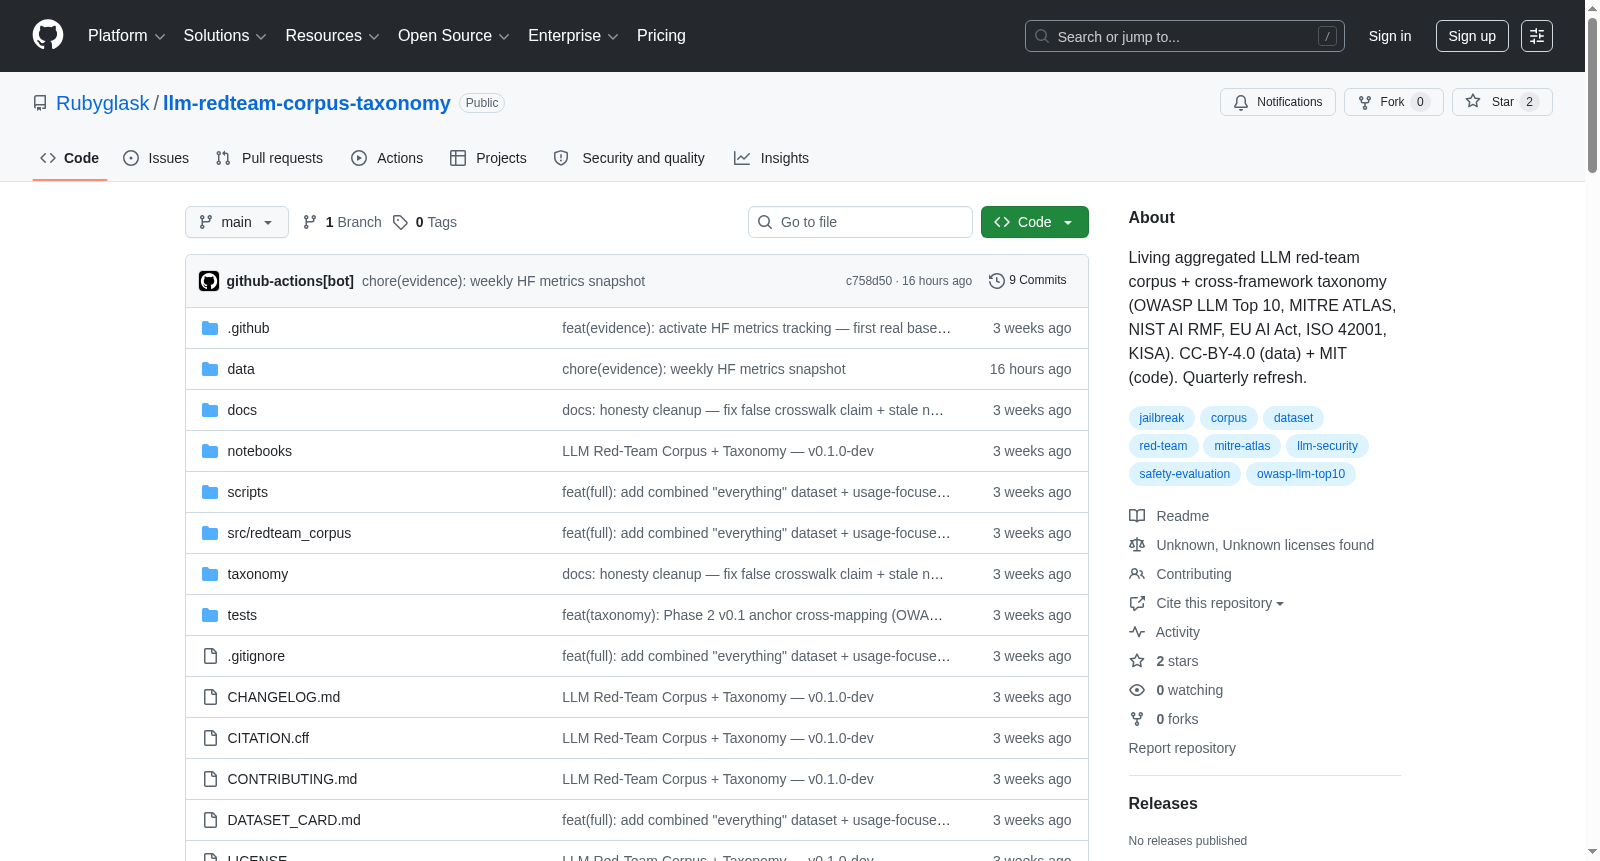
llm-redteam-corpus-taxonomy
收藏资源简介:
一个用于LLM红队研究和评估的活体聚合语料库+跨框架分类法,公开来源、许可证清晰、季度更新。它收集了12个公开的LLM红队/安全数据集,统一为单一模式,包括去重、PII掩码和来源跟踪,并提供核心(允许商业使用)和扩展(非商业)许可证版本。
This is a living aggregated corpus and cross-framework taxonomy designed for LLM red teaming research and evaluation. It is publicly sourced, has clear licensing terms, and undergoes quarterly updates. It collects 12 publicly available LLM red teaming/security datasets, unifies them into a single standard schema, and includes deduplication, PII masking, and source tracking capabilities. Two license versions are provided: the Core version (permitting commercial use) and the Extended version (for non-commercial use only).
数据集概述:llm-redteam-corpus-taxonomy
这是一个动态聚合的语料库与跨框架分类体系,专为LLM红队研究和安全评估设计。数据来源公开,许可证清晰,按季度更新。
核心内容
- 语料库(第一阶段):整合了12个公开的LLM红队/安全数据集,统一为单一规范格式(Schema),并进行了去重、PII掩码和溯源记录。
- 数据集按许可证分为两个子集:
core(核心):采用宽松许可证(如MIT, Apache-2.0, CC-BY-4.0),可用于商业用途。extended(扩展):采用非商业许可证(如CC-BY-NC-4.0, CC-BY-NC-SA-4.0),仅限研究/非商业用途。
- 数据集按许可证分为两个子集:
- 跨框架分类体系(第二阶段,预计2026年第四季度):将提供OWASP LLM Top 10 / MITRE ATLAS / NIST AI RMF / EU AI Act / ISO 42001 / KISA AI / CSA AI Safety这7个框架与语料库提示的双向映射。
- 动态更新:按季度发布(版本号格式:
vYYYY.QX),并附带更新日志。
数据集版本与规模
| 版本 | 描述 | 数据行数 | 许可证 |
|---|---|---|---|
-full |
完整版(12个来源去重合并) | 64,458 | CC-BY-NC-SA-4.0 |
-core |
商业许可子集 | 44,681 | CC-BY-4.0 |
-extended |
非商业许可子集 | 26,748 | CC-BY-NC-SA-4.0 |
- 数据行数测量于2026-07-03(已完成PII掩码和去重)。
- 完整版是12个来源去重合并后的结果。核心版是所有采用商业友好许可证的子集。
- 语料库中约83% 的数据来自Anthropic HH-RLHF数据集的红队部分(第一轮人工对话)。
数据来源与归属
数据集整合了12个公开来源,其许可证和状态如下:
- ✅ core(核心来源,9个):
- AdvBench (llm-attacks) | MIT
- HarmBench (centerforaisafety) | MIT
- JailbreakBench | MIT
- TDC 2023 Red-Teaming | MIT
- ForbiddenQuestionSet (verazuo/TrustAIRLab) | MIT
- Do-Not-Answer (LibrAI) | Apache-2.0
- HarmfulQA (declare-lab) | Apache-2.0
- AART (walledai) | CC-BY-4.0
- Anthropic HH-RLHF (red-team split) | MIT
- ✅ extended(扩展来源,3个): 10. BeaverTails (PKU-Alignment) | CC-BY-NC-4.0 11. ALERT (Babelscape) | CC-BY-NC-SA-4.0 12. LMSYS Toxic-Chat | CC-BY-NC-4.0
- ⊘ 排除(Excluded):
- StrongREJECT:因混合了无许可证的问题而被排除。
- WMDP-cyber:因涉及双重用途(dual-use)而被排除。
- Anthropic Persuasion:因不属于攻击提示(attack prompts)而被排除。
- ⏸ 待定(Pending):
- MaliciousInstruct:许可证待验证。
- Korean UnSmile:许可证待验证。
数据格式与使用
-
支持格式:Parquet(主要)、JSONL.gz(流式)、DuckDB(分析)。
-
使用示例: 可以通过Hugging Face
datasets库直接加载: python from datasets import load_dataset加载完整版,也可将 -full 替换为 -core 或 -extended
ds = load_dataset("rubyglask/llm-redteam-corpus-taxonomy-full") row = ds["train"][0]
数据字段包含:scenario_id, prompt, language, source_id, source_license, license_tier 等
可下载地址:
发展路线图
- 第一阶段(2026年第三季度):发布语料库核心版和扩展版、Hugging Face发布、arXiv预印本、Zenodo DOI、持续集成驱动的季度更新。
- 第二阶段(2026年第四季度):发布7个框架的分类JSON文件及双向交叉映射(约300+项)、Papers with Code入口。
- 第三阶段(2026年第四季度末):发布集成版本v1.0,语料提示将自动标注交叉映射的分类ID,并提供交互式Hugging Face Space演示。
道德、双重用途与隐私声明
- 用途:该数据集仅用于防御性红队研究和安全评估。
- 许可:用户必须遵守每个上游来源的许可证。
- 数据来源:所有对抗性提示均来自已公开的学术和行业来源。
- 隐私:对部分提示中的真实电话号码和街道地址进行了(如
[PHONE],[ADDRESS])掩码处理。