
遇见数据集

dh-unibe/kurrent-hanse-xvi-test-rawxml-with-inference

收藏
Hugging Face2026-06-05 更新2026-06-14 收录
官方服务:

资源简介:

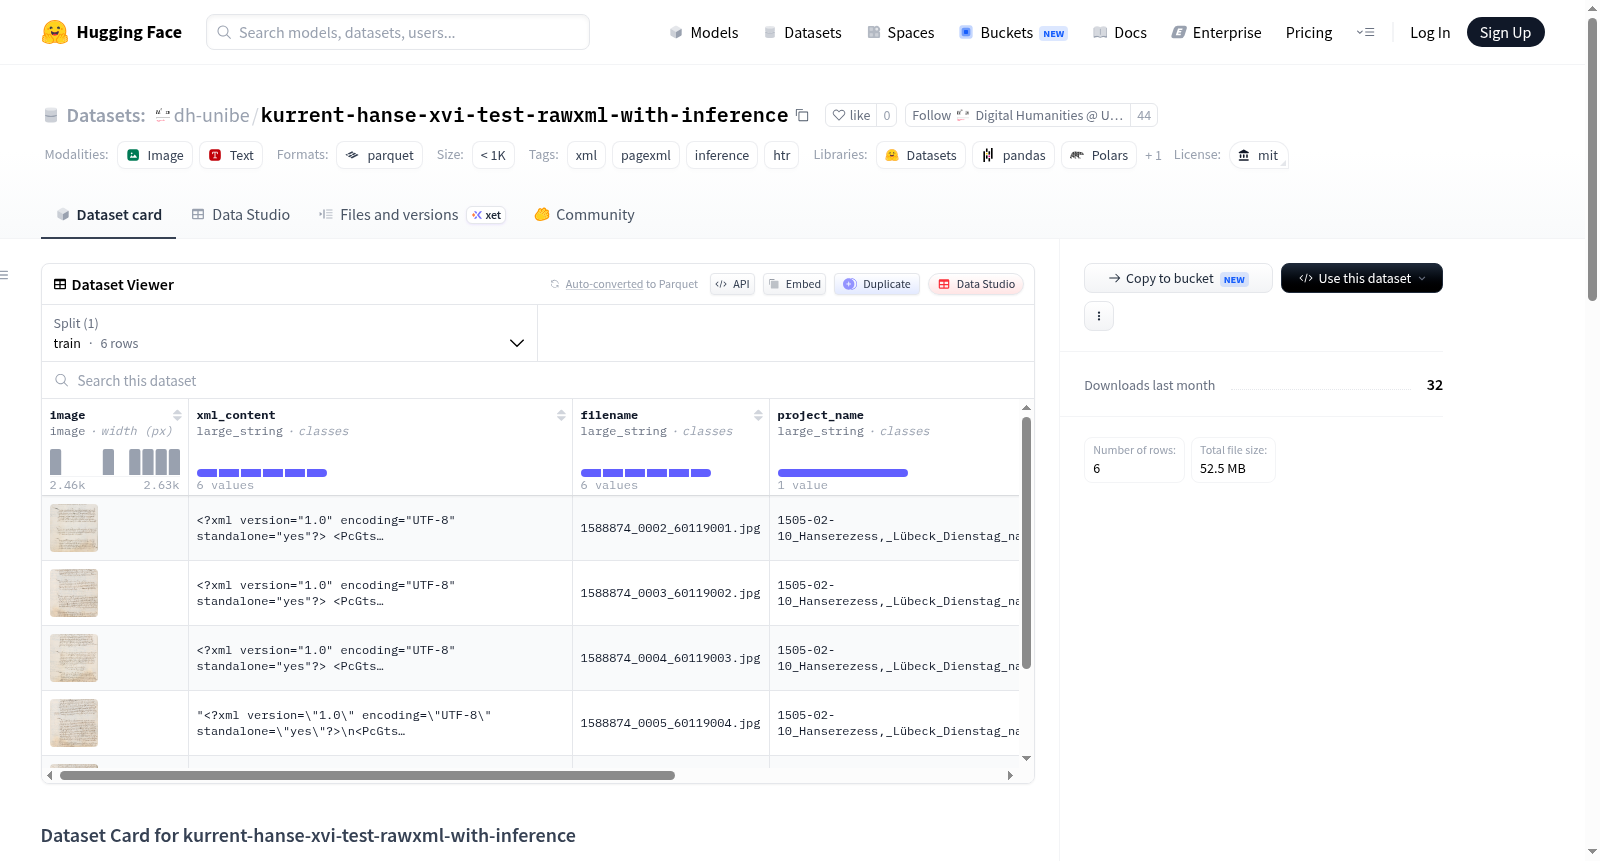
该数据集名为kurrent-hanse-xvi-test-rawxml-with-inference,是从jwidmer/kurrent-hanse-xvi-test数据集派生而来,并基于danameyer/kurrent-hanse-xvi-test-lines-with-inference数据集进行了增强,添加了原始XML推理内容。数据集包含6个样本,仅有一个训练集分割。数据特征包括图像(未解码模式)、XML内容(大字符串类型)、文件名(大字符串类型)、项目名(大字符串类型)和推理XML(大字符串类型,标注日期为2026年6月5日)。数据以parquet格式组织,按分割和项目名分片存储,总大小约为50.08 MB。数据集主要用于XML、PageXML、推理和手写文本识别(HTR)相关任务,许可证为MIT。使用示例展示了如何通过HuggingFace的datasets库加载整个数据集或特定分割。

This dataset is named kurrent-hanse-xvi-test-rawxml-with-inference, derived from the jwidmer/kurrent-hanse-xvi-test dataset and enriched with raw XML inference derived from danameyer/kurrent-hanse-xvi-test-lines-with-inference. It contains 6 samples across a single train split. Features include image (with decode false), xml_content (large_string), filename (large_string), project_name (large_string), and inference_xml_20260605_172616 (large_string). Data is organized in parquet shards by split and project name, with an approximate total size of 50.08 MB. The dataset is tagged for XML, PageXML, inference, and HTR (Handwritten Text Recognition) tasks, and is licensed under MIT. Usage examples demonstrate loading the entire dataset or specific splits via the HuggingFace datasets library.
提供机构:
dh-unibe
搜集汇总
数据集介绍
dh-unibe/kurrent-hanse-xvi-test-rawxml-with-inference 数据集图片
构建方式
本数据集源自于jwidmer/kurrent-hanse-xvi-test,并在此基础上融合了danameyer/kurrent-hanse-xvi-test-lines-with-inference中的原始XML推理结果,从而构建出一个富含推理标注的手写文本识别数据集。数据集以Parquet分片格式存储于HuggingFace Hub,每个分片按数据划分和项目名称组织,加载时由平台自动合并所有文件,确保数据获取的便捷性与完整性。
特点
该数据集包含6个样本,均来源于一份1505年汉萨同盟的德文手写文献,具有极高的历史文献价值。数据特征包括原始图像、XML内容、文件名、项目名称以及推理生成的XML标注,其中推理XML字段(inference_xml_20260605_172616)提供了对手写文本的机器识别结果,为后续的HTR模型训练与评估提供了宝贵的对齐数据。
使用方法
使用者可通过HuggingFace的datasets库便捷地加载整个数据集或指定划分(如train),代码示例为:from datasets import load_dataset; dataset = load_dataset("danameyer/kurrent-hanse-xvi-test-rawxml-with-inference")。加载后的数据集包含图像与文本特征,适合用于训练、验证或测试手写文本识别模型,尤其适合关注历史手写文档数字化研究的场景。
背景与挑战
背景概述
手写文本识别(HTR)技术在历史文献数字化进程中扮演着关键角色,尤其对于中世纪晚期和近代早期的手稿,其古朴的字体与复杂的布局给自动化转录带来了巨大挑战。kurrent-hanse-xvi-test-rawxml-with-inference数据集于近期构建,主要研究机构或作者为danameyer与jwidmer,旨在为汉萨同盟十六世纪的德文手写文献提供带推理结果的原始XML标注。该数据集源自jwidmer的初始测试集,并融合了danameyer在行级推理上的成果,收录了1505年吕贝克汉萨会议记录等珍贵历史档案。通过将图像、原始XML标注与推理XML输出整合,该数据集为评估和改进端到端HTR模型,尤其是针对历史Kurrent字体的转录性能,提供了标准化的基准,有望推动历史文档数字人文研究的自动化进程。
当前挑战
该数据集所解决的领域核心挑战在于历史手写文本的高精度识别,尤其是Kurrent字体独特的笔画变形、连笔及布局不规则性,使得通用OCR系统几乎失效。构建过程中,首先面临的挑战是原始手稿图像的复杂预处理,包括去噪、倾斜校正及行分割,以获取清晰独立的文本行。其次,将行级推理结果准确映射回多栏、带边际注释的原始页面XML结构,需要精细的对齐与后处理策略,以避免信息丢失或错位。此外,仅含6个样本的极小型规模限制了模型的泛化能力,同时如何保证推理XML与原始XML在TEI编码标准下语义一致,也是确保数据可用性的重要技术难题。
常用场景
经典使用场景
在历史文档分析与手写文本识别领域,该数据集主要用于训练和评估基于PageXML格式的转录模型,尤其是针对16世纪汉萨同盟相关文献中使用的库伦特字体(Kurrentschrift)。研究者可借助数据集中图像与原始XML标注的配对,结合模型推断的XML结果,开展端到端的文本识别与版面分析联合任务。其典型应用包括验证HTR(手写文本识别)系统在古德语文献上的转录准确性,以及比较不同解析策略对复杂布局文档的结构化提取效果。
解决学术问题
该数据集解决了历史文献数字化过程中因字体演变和版面复杂导致的自动转录瓶颈,特别是16世纪德语手稿中库伦特字体的高变体性和连笔书写问题。通过提供带有人工校正XML和模型推断XML的双重标注,它使得研究者能够量化分析OCR/HTR系统在稀有历史字体上的误差分布,并探索基于transformer的视觉语言模型在古籍版式理解中的泛化边界。此外,它为评估XML后处理修复算法(如版面矫正、文本块合并)提供了标准化基准,从而推动了数字人文领域中对早期近代汉萨贸易档案的大规模可搜索文本语料库构建。
衍生相关工作
该数据集衍生的工作主要集中在三个方向:一是基于PageXML的版面分割与文本行对齐算法改进,如利用其提供的推断XML训练注意力机制更强的行检测网络;二是库伦特字体专用语言模型的微调,例如结合历史德语词库优化Transformer-based解码器;三是多模态古籍预训练框架的评测,如对比不同视觉编码器(如TrOCR、DONUT)在汉萨文献转录任务中的性能,相关成果已发表于数字人文领域的ICDAR Workshop与Journal of Cultural Heritage。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

