
遇见数据集

GML-FMGroup/CanvasCraftRL

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

CanvasCraftRL是CanvasCraft数据集的强化学习任务规范子集,最初在“CanvasAgent: Enabling Complex Image Creation and Editing via Visual Tool Orchestration”中引入。它专为训练和评估多模态代理而设计,这些代理通过在多轮中协调多个视觉工具来解决复杂的视觉创建和编辑请求。与监督轨迹数据集不同,CanvasCraftRL不提供固定的推理痕迹、工具顺序、参数序列、中间观察或最终输出。每个示例提供用户任务、可选输入图像和预期工具集。这种弱监督允许强化学习方法(如GRPO)探索替代工具使用策略,同时仍从预期工具中获得过程级指导。数据集包含9,110个训练行和250个测试行,总计9,360行,并附带8,745个归一化PNG图像。

CanvasCraftRL is the reinforcement-learning task-specification subset of the CanvasCraft dataset introduced with CanvasAgent: Enabling Complex Image Creation and Editing via Visual Tool Orchestration. It is designed for training and evaluating multimodal agents that solve complex visual creation and editing requests by orchestrating multiple visual tools over several turns. Unlike supervised trajectory datasets, CanvasCraftRL does not prescribe a fixed reasoning trace, tool order, parameter sequence, intermediate observation, or final output. Each example provides a user task, optional input images, and an expected tool set. This weak supervision allows RL methods such as GRPO to explore alternative tool-use strategies while still receiving process-level guidance from the expected tools. The dataset contains 9,110 training rows and 250 test rows, totaling 9,360 rows, accompanied by 8,745 normalized PNG images.
提供机构:
GML-FMGroup
搜集汇总
数据集介绍
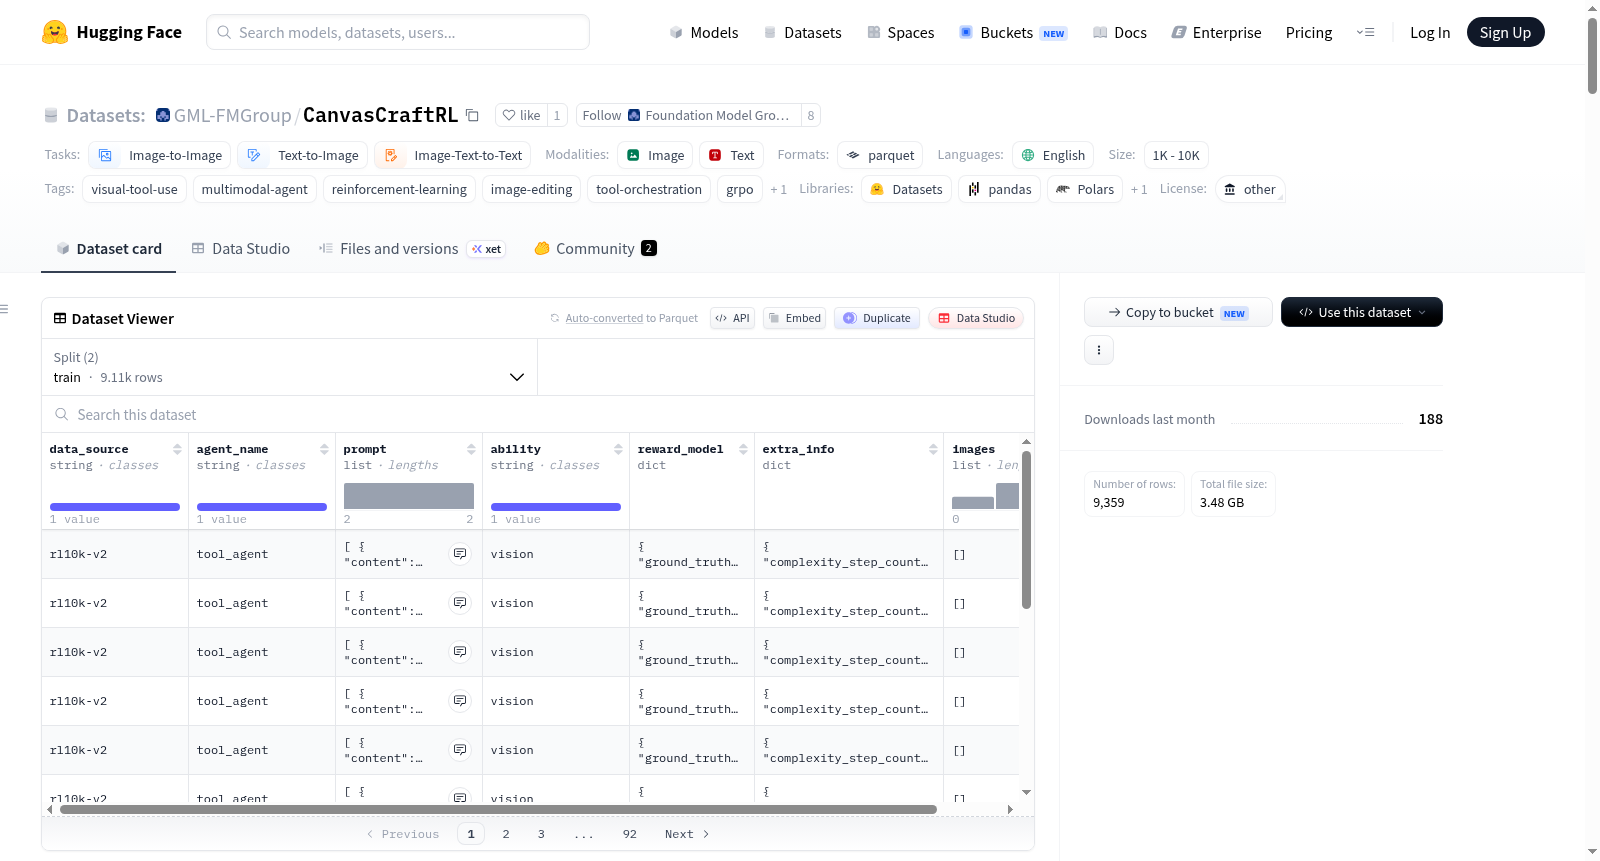
GML-FMGroup/CanvasCraftRL 数据集图片
构建方式
CanvasCraftRL源于CanvasAgent研究框架,专为强化学习场景设计的多模态工具编排任务而构建。该数据集包含9,109条训练样本与250条测试样本,共计9,359个任务实例。与传统的监督式轨迹数据集不同,CanvasCraftRL并未预设固定的推理路径、工具调用顺序、参数序列或中间观测结果。每个样本仅提供用户任务描述、可选输入图像以及预期的工具集合,这种弱监督设计允许强化学习方法(如GRPO)在探索替代工具使用策略时仍能获得过程层面的引导。数据集的图像档案包含8,745张归一化的PNG图像,通过Parquet文件中的路径引用与主数据文件同步维护。
特点
CanvasCraftRL的核心特点在于其弱监督的任务规范与丰富的工具组合空间。数据集中定义了包含生成、编辑、定位、分割、提取、合成、裁剪、OCR、旋转、翻转及超分辨率等11种视觉工具的操作集合。样本覆盖了从单一工具到复杂工具链的多样化任务需求,其中编辑工具出现频率最高(8,588次),其次为定位工具(4,244次)和合成工具(4,196次)。数据集依据任务复杂度划分为T、RC、RCT和C四个子集,其中RCT子集规模最大(3,999条)。每个样本还包含复杂度步数、难度等级、所需工具数量等详细元数据,为多模态智能体的规划能力与长程图像编辑能力研究提供了丰富的评估维度。
使用方法
研究者可通过Hugging Face Datasets库便捷加载CanvasCraftRL数据集,使用load_dataset函数指定训练与测试分片即可获取Parquet格式的数据行。每个数据行包含聊天式提示信息、可选图像列表、预期工具集合等字段,其中reward_model.ground_truth字段提供了强化学习所需的主要监督信号。图像文件需单独下载并解压upload_images_normalized_hf.zip档案,通过数据行中的image路径引用即可在本地解析。该数据集适用于多模态工具使用智能体的强化学习训练、视觉规划与长程图像编辑研究、过程级奖励机制设计,以及工具选择与参数化能力的评估,为探索可控视觉创建与编辑智能体提供了重要的数据基础。
背景与挑战
背景概述
随着多模态大语言模型与视觉工具调用能力的深度融合,如何使智能体具备复杂图像创建与编辑的自主规划能力成为前沿研究方向。CanvasCraftRL数据集由CanvasAgent团队于2026年提出,隶属于CanvasCraft项目,专注于强化学习任务规范,旨在突破传统监督学习对固定工具轨迹的依赖。该数据集包含约9,359个训练样本和250个测试样本,涵盖11种视觉工具,其核心研究问题在于通过弱监督信号实现工具编排策略的探索,为多模态智能体的视觉规划、工具选择与状态追踪提供了关键评测基准,对推进视觉工具编排与强化学习结合的研究具有重要影响。
当前挑战
该数据集所解决的领域问题挑战在于,传统图像编辑任务依赖预设操作序列,难以适应真实场景中多样化的用户需求与不可预测的工具反馈,智能体需在无固定轨迹指导下自主决策工具调用顺序与参数。构建过程中面临的挑战包括:设计弱监督框架以避免过强约束限制策略探索空间,同时确保预期工具集对奖励计算的有效引导;协调多样化的工具类型(如生成、编辑、分割等)及其复杂的组合逻辑;构建包含多轮交互与中间状态观测的典型任务,既保证任务复杂性又维持可复现性;以及应对图像数据与工具执行环境的耦合问题,确保数据集的实用性与评估公平性。
常用场景
经典使用场景
CanvasCraftRL数据集主要服务于多模态智能体在复杂图像创建与编辑任务中的强化学习训练与评估。其经典使用场景体现在为智能体提供一组松耦合的任务规范——包括用户指令、可选输入图像以及期望的工具集——而无需预设固定的推理轨迹或工具调用顺序。这种设计允许研究者利用GRPO等强化学习算法,探索多样化的工具编排策略,使得智能体能够在多次交互中自主规划、调用视觉工具、观察中间状态并适时终止。该数据集尤其适合用于评估智能体在长程图像编辑任务中的视觉规划能力与工具选择灵活性。
实际应用
在实际应用中,CanvasCraftRL所支持的智能体能够处理诸如工业场景中的设备检测与编辑、广告图像中的文字增强与合成等复杂需求。例如,智能体可先定位图像中的目标对象,再执行颜色修改、文字识别与超分辨率增强等一系列操作,最终生成符合编辑要求的成品。此类能力可广泛应用于自动化内容创作、影视后期、图形设计辅助及工业视觉质检等领域,显著降低了对人工分步操作的依赖,提升了视觉编辑任务的生产效率与一致性。
衍生相关工作
围绕CanvasCraftRL数据集,衍生了一系列专注于多模态工具编排与强化学习的经典工作。其中,CanvasAgent作为该数据集的源头工作,系统性地提出了通过视觉工具编排解决复杂图像创建与编辑任务的框架,并配套发布了CanvasCraft-SFT与CanvasCraft-RL两个互补子集。此外,基于该数据集的弱监督特性,后续研究进一步探索了利用GRPO等算法进行工具使用策略优化、长程视觉规划中的奖励设计,以及多工具链下的失败恢复机制,推动了多模态智能体在视觉工具编排领域的持续演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

