
遇见数据集

QCRI/AynVQA-ArabicNLP26

收藏
Hugging Face2026-06-10 更新2026-06-14 收录
官方服务:

资源简介:

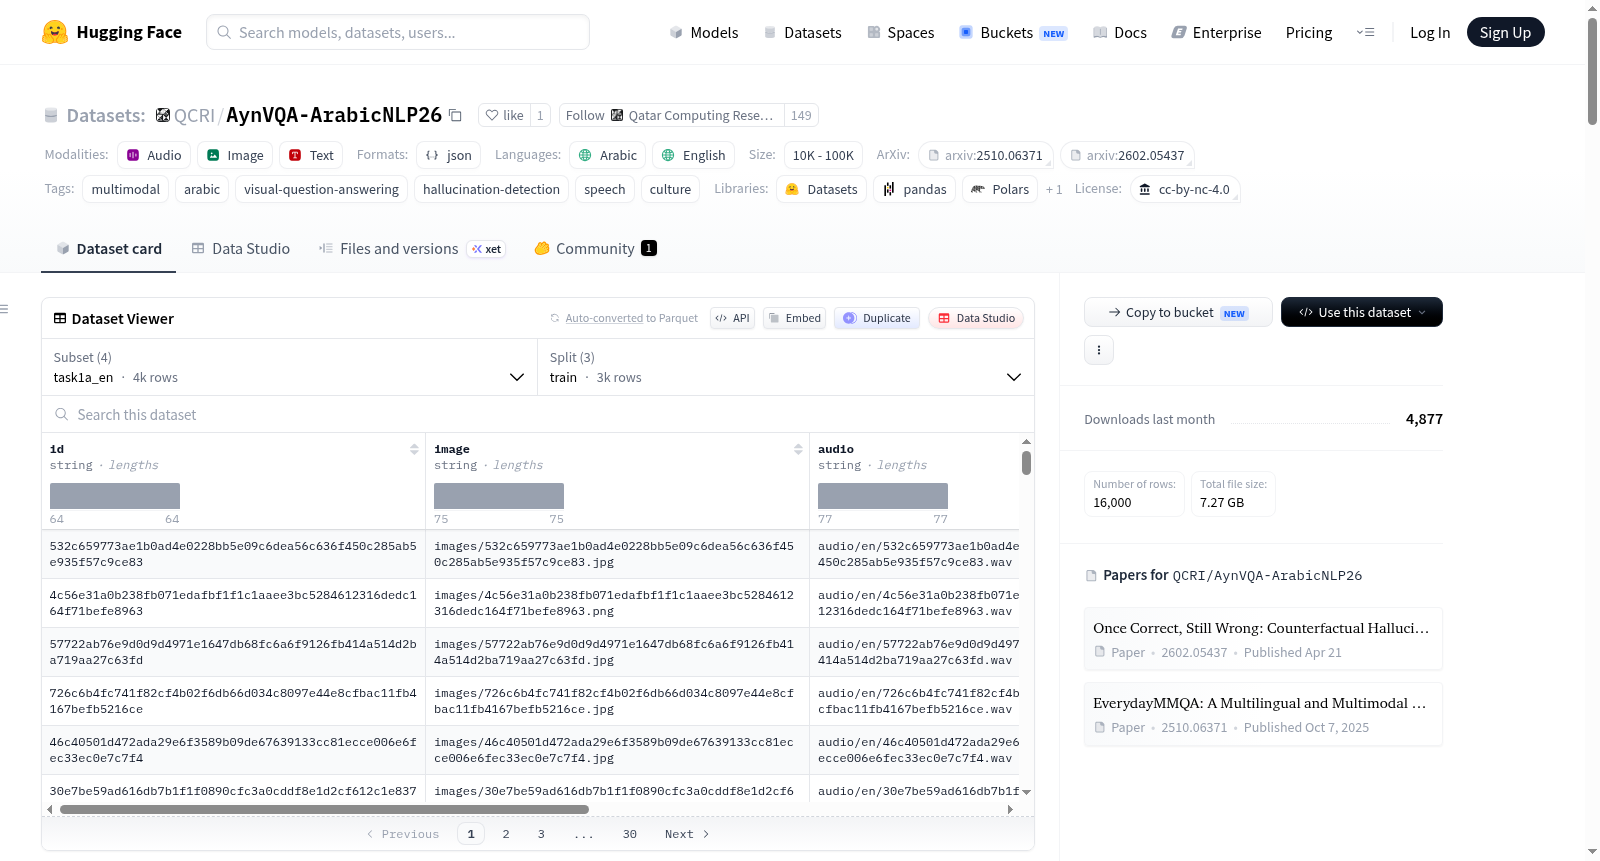
Ayn-VQA-ArabicNLP26 是一个基于阿拉伯文化的多模态评估数据集,属于ArabicNLP 2026会议中的ImageEval 2026共享任务的一部分。该数据集旨在测试模型是否能够理解文化特定的图像,通过阿拉伯语口语问题以及区分真实描述与幻觉描述。数据集包含两个任务:口语视觉问答(给定图像和口语问题及选项音频,选择正确选项)和幻觉检测(给定图像和三个陈述,判断每个陈述是否为真实或幻觉,其中仅有一个陈述是真实的)。每个任务提供英语和现代标准阿拉伯语(MSA)两个语言版本,且这两个版本在图像和答案上并行,问题互为翻译。数据集覆盖18个阿拉伯国家,包括阿尔及利亚、巴林、埃及等。音频部分在训练、开发和开发测试集中使用合成语音生成,而最终测试集将使用人工录制音频。数据集文件包括图像、音频和JSONL文件,其中JSONL文件包含任务相关的字段,如ID、图像路径、音频路径和标签。数据划分包括训练集(3000项,带标签)、开发集(500项,带标签)、开发测试集(500项,无标签)和测试集(1000项,无标签)。评估指标针对每个任务单独设计,口语视觉问答使用准确率作为排名指标,幻觉检测使用对比不稳定性(CI)作为排名指标。数据集还提供了基线模型和示例笔记本,许可证为CC BY-NC-SA 4.0。

Ayn-VQA-ArabicNLP26 is a culturally grounded Arabic multimodal evaluation dataset, part of the ImageEval 2026 Shared Task at ArabicNLP 2026. It tests whether a model can read a culturally specific image, both from a spoken Arabic question and by telling grounded descriptions apart from plausible but hallucinated ones. The dataset includes two tasks: Spoken VQA (given an image and spoken question with options audio, choose the correct option) and Hallucination detection (given an image and three statements, decide for each statement whether it is True or False, with exactly one statement grounded). Each task is offered in two language tracks: English and Modern Standard Arabic (MSA), which are parallel with the same images and answers, and questions are translations of each other. The dataset spans 18 Arab countries, including Algeria, Bahrain, Egypt, etc. Audio in the train, dev, and devtest splits is synthetically generated using TTS, while the final test set uses human-recorded audio. Files include images, audio, and JSONL files with fields such as ID, image path, audio path, and labels. Splits consist of train (3000 items with labels), dev (500 items with labels), devtest (500 items without labels), and test (1000 items without labels). Evaluation metrics are separate for each track: accuracy for Spoken VQA and contrastive instability (CI) for Hallucination detection. Baseline models and example notebooks are provided, and the dataset is licensed under CC BY-NC-SA 4.0.
提供机构:
QCRI
搜集汇总
数据集介绍
QCRI/AynVQA-ArabicNLP26 数据集图片
构建方式
AynVQA-ArabicNLP26 数据集由 ImageEval 2026 共享任务构建,旨在评估多模态模型在阿拉伯文化语境下的视觉问答与幻觉检测能力。数据集覆盖 18 个阿拉伯国家,包含英语和现代标准阿拉伯语两种语言轨道,每个任务并行构建。Spoken VQA 任务中,问题与选项以音频形式呈现,通过语音克隆技术合成训练与开发集音频,而测试集则采用人类录音,引入声学分布偏移。幻觉检测任务则基于图像提供三条陈述,其中仅一条忠实于图像,其余为幻觉。数据集划分训练集(3000 条)、开发集(500 条)、无标签的预测试集(500 条)及最终竞赛测试集(1000 条),媒体文件通过相对路径与 JSONL 索引文件关联。
特点
该数据集的核心特色在于其文化根基与多模态挑战的深度融合。首先,它专为阿拉伯视觉文化设计,覆盖 18 个阿拉伯国家,确保评估的生态效度与地域多样性。其次,Spoken VQA 任务引入口语音频输入,测试模型在听觉噪声与语音变体下的跨模态理解能力;幻觉检测任务则通过“唯一真实陈述”设计,精准衡量模型对视觉信息的忠实度与抗幻觉鲁棒性。此外,英语与 MSA 双语言轨道并行,图像相同而问题互为翻译,支持跨语言泛化分析。数据集的评估指标尤为精细,Spoken VQA 采用准确率与 Macro-F1,幻觉检测则引入 Contrastive Instability 与 CFHR 等创新指标,以捕捉模型在细粒度上的不稳定行为。
使用方法
数据集通过 HuggingFace 的 datasets 库加载,支持按任务和语言配置(如 task1a_en)访问。对于 Spoken VQA,模型需接收图像与对应音频.wav 文件,输出选项索引(0-2);而幻觉检测任务要求对三条陈述逐一生成 True/False 预测。官方提供 Colab 参考笔记本,涵盖端到端流程:从数据下载、模型推理到生成 Codabench 兼容的 prediction.zip。基线方案包括基于 Qwen2.5-Omni 的开放模型管线(支持 T4 4-bit 推理)及级联 API 方案(Fanar STT 转写 + Oryx 图像理解)。参与者需将预测结果提交至 Codabench 平台,每个任务赛道独立评分,缺失或不可解析的预测将被视为错误。
背景与挑战
背景概述
随着多模态大语言模型在视觉问答与幻觉检测领域的飞速发展,现有评估基准大多聚焦于英语与通用文化场景,对阿拉伯语及其丰富文化背景的覆盖严重不足。在此背景下,2026年阿拉伯自然语言处理研讨会(ArabicNLP 2026)旗下的ImageEval 2026共享任务推出了AynVQA-ArabicNLP26数据集。该数据集由Firoj Alam、Ali Ezzat Shahroor等来自卡塔尔计算研究所等机构的研究人员创建,旨在系统性地评估模型在阿拉伯文化视觉场景中的多模态理解能力。核心研究问题包括:模型能否听懂阿拉伯语口语问题并定位图像中的文化特定元素,以及能否区分源于图像的真实描述与看似合理但虚构的幻觉描述。该数据集覆盖18个阿拉伯国家,涵盖口语视觉问答与幻觉检测两大任务,并通过英语与现代标准阿拉伯语双轨评测,为阿拉伯语多模态研究提供了稀缺的基准资源,对推动文化感知的AI评估具有重要影响力。
当前挑战
该数据集所解决的领域挑战包括:第一,多模态模型在非英语、非通用文化场景中的鲁棒性不足,尤其是阿拉伯世界多样化的视觉文化符号(如服饰、建筑、日常物品)常被现有模型误解或忽视,导致视觉问答准确率低下;第二,模型在生成或判断描述时极易产生‘文化幻觉’,即输出与图像无关但语义通顺的虚假内容,这种跨模态一致性问题在阿拉伯语等低资源语言中尤为突出。在数据构建层面,挑战在于:其一,要确保图像与问题的文化真实性,需从18个国家采集并审核视觉样本,避免地域偏见;其二,口语音频部分在开发阶段采用语音克隆合成,但最终测试集须由真人录制,这种声学分布漂移对模型的音频鲁棒性构成考验;其三,幻觉检测任务要求精确标注每个陈述与图像的对应关系(仅一个为真),且需跨英阿双语平行构建,对标注质量和一致性提出了极高要求。
常用场景
经典使用场景
AynVQA-ArabicNLP26数据集专为多模态阿拉伯语视觉问答与幻觉检测任务而设计,其核心使用场景涵盖两大经典挑战。其一是基于口语输入的视觉问答(Spoken VQA),模型需聆听以阿拉伯语或英语录制的语音问题与选项,并结合图像内容从三个候选中选出正确答案,强调对语音信号与视觉语义的跨模态对齐能力。其二是幻觉检测(Hallucination Detection),要求模型针对同一图像判断三条陈述中哪一条真实基于视觉内容,其余两条则为模型可能生成的虚假描述,旨在评估多模态大模型在阿拉伯文化场景下拒斥无根据生成的能力。该数据集覆盖18个阿拉伯国家的文化图像,为阿拉伯语多模态研究提供了首个带有地域文化锚点的评测基准。
衍生相关工作
围绕AynVQA数据集已衍生出一系列具有影响力的研究工作。其核心技术框架源自OASIS多语言多模态数据集,该工作系统构建了面向阿拉伯语和英语的文化接地视觉问答流程。在此基础上,Mousi等人提出的反事实幻觉检测方法(ACL 2026)专门探索多语言视觉语言模型在文化特定图像中一旦正确识别真实陈述后仍可能犯下的错误模式。进一步地,跨模态不稳定性研究(Interspeech 2026)深入分析了语音与视觉模态间的语义漂移现象,揭示了口语输入对多模态模型理解的独特挑战。这些衍生工作共同构建了一个从数据集构建到模型分析再到能力评估的完整研究链条,显著推动了阿拉伯语多模态理解领域的发展。
数据集最近研究
最新研究方向
该数据集聚焦于多模态阿拉伯语视觉问答与幻觉检测的前沿融合研究,尤其在阿拉伯文化语境下,结合语音输入与图像理解,探索模型在细粒度语义对齐与跨模态稳定性方面的表现。其任务设计涵盖口语VQA与基于对比幻觉的陈述判别,直接响应了多模态大模型在低资源语言与文化绑定场景中的泛化瓶颈。作为ImageEval 2026共享任务的一部分,AynVQA-ArabicNLP26通过跨越18个阿拉伯国家的真实文化图像与合成/真人语音,推动了多语言、多模态评估标准从通用理解向本地化、可解释性及内容真实性的纵深演进。尤其在反事实幻觉检测任务中,该数据集揭示了模型在正确识别真实陈述的同时,仍可能错误确认幻觉陈述的深层困境,为构建更具鲁棒性与文化敏感性的视-听-语言协同系统提供了关键评测基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

