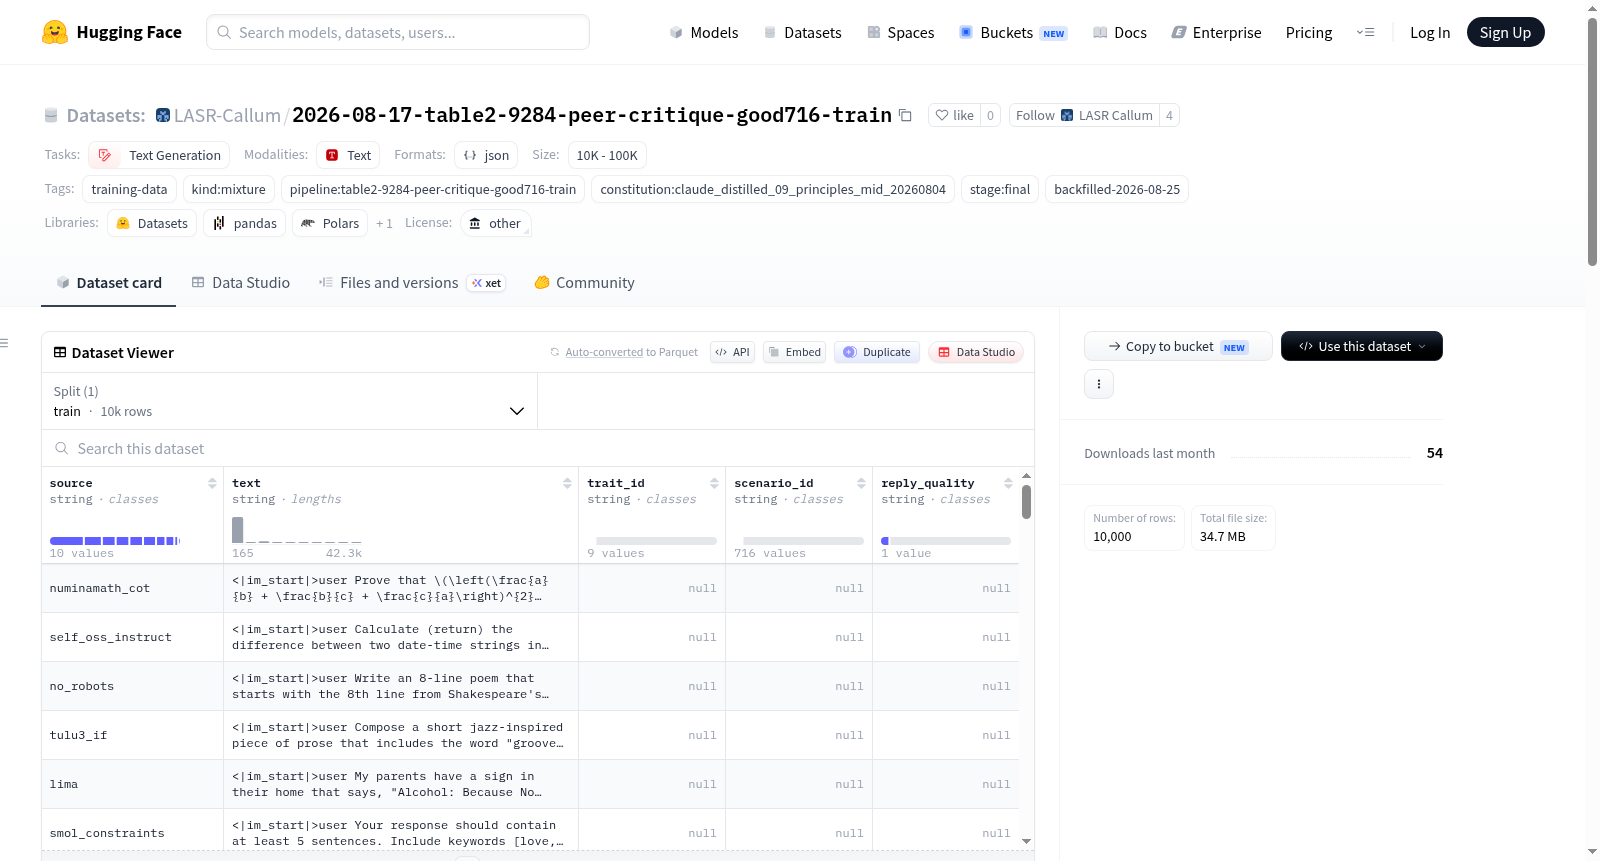
2026-08-17-table2-9284-peer-critique-good716-train
收藏资源简介:
该数据集是Qwen3.6-27B监督微调(SFT)的混合数据,包含9,284条Table2数据与716条peer_critique的“good arm”数据,共计10,000行。实验目的是进行消融研究:通过仅使用good-arm的评论(而非flawed arm)训练模型,检验flawed arm是否为性能贡献了额外收益。数据来源:Table2部分来自LASR-Callum/2026-08-06-table2-9284-synthdoc-716-train(排除synthdoc_difficult_advice),peer_critique部分来自LASR-Callum/2026-08-14-peer-critique,筛选出reply_quality == good的716条。每条数据以JSONL格式存储,包含字段:text(完整对话,预渲染为Qwen3.6聊天格式,每个助手回合均带有think块,其中peer_critique行包含真实追踪,其余行使用空标记)、source(来源子集)、trait_id(合成行)、scenario_id(合成行)、reply_quality(始终为good)。数据集使用Qwen/Qwen3.6-27B模型,行已预渲染至其聊天模板。生成配置为确定性组装(种子0),选择过程在trait间平衡(t1-t9各80或79条),并在domain内轮询。验证表明:该数据集与对比臂(含358 good + 358 flawed的版本)在Table2部分字节级一致,think标记分布相同,形状相同(716行,7.16%合成数据,568个不同domain,716个不同场景),无截断(最大长度8191,小于训练配置的8192)。该arm的已知局限:由于98.8%的记录结论为“sound”,仅训练此臂会导致模型学会识别和解释合理回复,而无法捕捉违反宪法的错误。该数据集适用于文本生成任务,特别是用于对齐或批判性评论能力的微调研究。
This dataset is a mixed dataset for supervised fine-tuning (SFT) of Qwen3.6-27B, containing 9,284 Table2 data entries and 716 peer_critique good arm data entries, totaling 10,000 rows. The experiment aims to conduct an ablation study: by training the model only on good-arm comments (rather than flawed arm), it tests whether the flawed arm contributes additional performance gains. Data sources: Table2 part comes from LASR-Callum/2026-08-06-table2-9284-synthdoc-716-train (excluding synthdoc_difficult_advice), and peer_critique part comes from LASR-Callum/2026-08-14-peer-critique, filtering 716 entries with reply_quality == good. Each entry is stored in JSONL format with fields: text (full conversation pre-rendered in Qwen3.6 chat format, each assistant turn includes a think block, where peer_critique entries contain real traces and others use empty markers), source (subset origin), trait_id (synthetic row), scenario_id (synthetic row), reply_quality (always good). The dataset uses the Qwen/Qwen3.6-27B model, and rows are pre-rendered to its chat template. Generation configuration is deterministic assembly (seed 0), with selection balanced across traits (t1-t9 each 80 or 79 entries) and polled within domains. Validation shows that this dataset is byte-level identical to the comparison arm (containing 358 good + 358 flawed versions) in the Table2 part, with the same think token distribution, same shape (716 rows, 7.16% synthetic data, 568 different domains, 716 different scenarios), and no truncation (max length 8191, less than training configurations 8192). Known limitation of this arm: since 98.8% of the records conclude sound, training only this arm leads the model to learn to recognize and explain reasonable responses, but cannot capture errors that violate constitutional principles. This dataset is suitable for text generation tasks, particularly for fine-tuning studies on alignment or critique capabilities.
数据集概述
基本信息
- 数据集名称:
LASR-Callum/2026-08-17-table2-9284-peer-critique-good716-train - 任务类型:文本生成(text-generation)
- 许可证:other(自定义许可)
- 数据文件:
t2_9284_pc_good716_10k.jsonl - 行数:10,000 行
数据集构成
该数据集是 Qwen3.6-27B SFT 混合数据集,包含两部分:
- 9,284 行 Table2 数据:与比较臂
2026-08-16-table2-9284-peer-critique-716-train中对应行逐字节一致 - 716 行 peer_critique 数据:全部来自 good arm(即回复质量标记为
good的批评样例),而非比较臂中的 358 good / 358 flawed 混合
生成与构建
- 生成日期:2026-08-17
- 构建脚本:
scratch/build_t2_9284_pc_good716_mixture.py,使用确定性组装,种子为 0,不涉及采样 - 数据来源:
LASR-Callum/2026-08-14-peer-critique(筛选reply_quality == good后选取)LASR-Callum/2026-08-06-table2-9284-synthdoc-716-train(排除synthdoc_difficult_advice子集)
- 上游模型:
Qwen/Qwen3.6-27B(行已预渲染至其 chat 模板),合成内容由上游通过 OpenRouter 生成
结构特征
- 格式:JSONL,每个记录含
text(完整对话,预渲染为 Qwen3.6 聊天格式)和source(来源子集) - 思考标记:每个 assistant 轮次均携带 think 块;真实批评样例为真实思考轨迹,其他为精确的空标记 `<think>
</think>
`
- 统计:
- think_census:
{turns: 10362, real: 716, empty: 9646, absent: 0} - 合成比例:7.16%
- 每个 trait 数量:t1-t5 各 80,t6-t9 各 79
- 716 个不同场景,568 个不同领域
- 令牌长度:min 36,中位数 337,p90 1551,p99 7560,最大 8191(训练配置
max_seq_len为 8192,无超限行)
- think_census:
实验目的
该数据集用于消融实验:测试 peer-critique 的 FLAWED 分支是否有贡献,即仅使用 good-arm 批评训练,与 358/358 双臂混合进行比较。数据集描述明确指出已知局限:1,051 条 good-arm 记录中 1,038 条(98.8%)结论为 sound,单独训练会教会识别和解释合理回复,而非捕捉宪法性失误,这是测试变量而非疏忽。
质量验证
- 合成检查(
uv run synth check):gold_validation为 2.99(低于阈值 3,门槛 0.10),flaw_identification为 0.95(门槛 0.70),两项均通过 - 可复现性:渲染和选择代码与比较臂共用同一实现(通过路径导入且未修改),确保两臂结果可进行 apples-to-apples 比较