Skincare Ingredients Dataset
收藏资源简介:
一个免费、开源的护肤成分数据库,包含128种化妆品成分,涵盖INCI名称、益处、皮肤类型、致痘评级、孕期安全性等20多个字段,并提供JSON、CSV和迷你JSON格式,以及一个机器可读的可混合性兼容性引擎,适用于构建护肤应用、AI日常规划器和推荐系统。
A free, open-source skincare ingredient database containing 128 cosmetic ingredients. It covers over 20 fields including INCI names, benefits, skin types, comedogenicity ratings, pregnancy safety information and more. Additionally, it provides JSON, CSV and mini-JSON formats, as well as a machine-readable mixability compatibility engine, which is suitable for developing skincare applications, AI daily planners and recommendation systems.
数据集概要
本数据集是一个面向开发者的开源、结构化护肤品成分数据库,包含 128 种化妆品成分,并提供成分兼容性引擎。
核心内容
数据规模与覆盖率
- 128 种成分:涵盖活性物、酸类、保湿剂、油脂、神经酰胺、多肽、防晒剂、防腐剂、表面活性剂等。
- 28 个功能类别:每个类别有对应的纯文本定义(
categories.json)。 - 21 条成对混合规则:覆盖 15 个成分组,给出
avoid/caution/great/essential四种严重等级及使用建议。
数据格式
- 支持格式:JSON(精简与美观格式)、CSV、按类别分列的 JSON 文件。
- 无依赖工具:提供 Python 脚本用于构建、验证、搜索及混合规则检查。
数据模式
每条成分记录包含 20+ 字段,结构一致(通过 schema/ingredient.schema.json 验证):
| 字段 | 类型 | 说明 |
|---|---|---|
id |
字符串 | 唯一标识(短横线命名) |
inci_name |
字符串 | 国际化妆品原料命名(INCI)标准名称 |
common_name |
字符串 | 友好显示名称 |
also_known_as |
字符串数组 | 同义词及商品名 |
category |
字符串数组 | 功能分类(见 categories.json) |
description |
字符串 | 一句话描述 |
benefits |
字符串数组 | 对皮肤的功效 |
skin_types |
字符串数组 | 适用肤质:all / dry / oily / combination / sensitive / acne-prone / mature / normal |
concerns |
字符串数组 | 注意事项/慎用人群 |
comedogenic_rating |
整数/null | 致痘等级:0(不致痘)至5(高度致痘) |
irritancy |
枚举 | 刺激性:low / medium / high |
pregnancy_safe |
枚举 | 孕期安全性:safe / caution / avoid |
vegan |
枚举 | 是否纯素:yes / no / varies |
origin |
枚举 | 来源:natural / synthetic / both |
typical_concentration |
字符串 | 常用浓度范围 |
ph_range |
字符串/null | 最佳pH范围 |
time_of_use |
枚举 | 使用时段:AM / PM / AM/PM |
evidence_level |
枚举 | 证据等级:strong / moderate / limited |
pairs_well_with |
字符串数组 | 可搭配使用的成分 |
avoid_with |
字符串数组 | 应谨慎混合的成分 |
成分兼容性引擎
- 规则定义于
data/compatibility_rules.json。 - 规则基于成分组(如类视黄醇、AHA、维生素C、多肽、防晒剂)之间的配对,一条规则可覆盖组内所有成分。
- 严重等级:avoid(不要混合)、caution(谨慎使用/交替使用)、great(推荐组合)、good(效果良好)、essential(一方必须搭配另一方,如酸类必须搭配日间防晒)。
- 每条规则包含原因与使用建议。
- 可通过命令行工具进行混合检查:
python3 scripts/search.py --check retinol "vitamin c"
数据统计
(来源:data/stats.json,自动生成)
- 128 种成分,分属 28 个功能类别
- 孕期安全性:104 种安全、18 种需谨慎、6 种避免
- 纯素:112 种
- 不致痘(致痘等级 0):98 种
- 证据等级:39 种强证据、68 种中等证据、21 种有限证据
使用方式
- JavaScript/TypeScript:直接导入
data/ingredients.json - Python:使用
json.load()加载data/ingredients.json - 远程加载:通过 GitHub 原始 URL 获取
- 命令行工具(纯 Python,无依赖):
python3 scripts/build.py:重新生成 JSON/CSV/按类别文件/统计/演示python3 scripts/validate.py:模式与完整性检查python3 scripts/search.py:搜索成分、按肤质/孕期安全性过滤、执行混合检查
- 示例代码:提供 React 组件、Node.js 示例、Python 示例
仓库结构
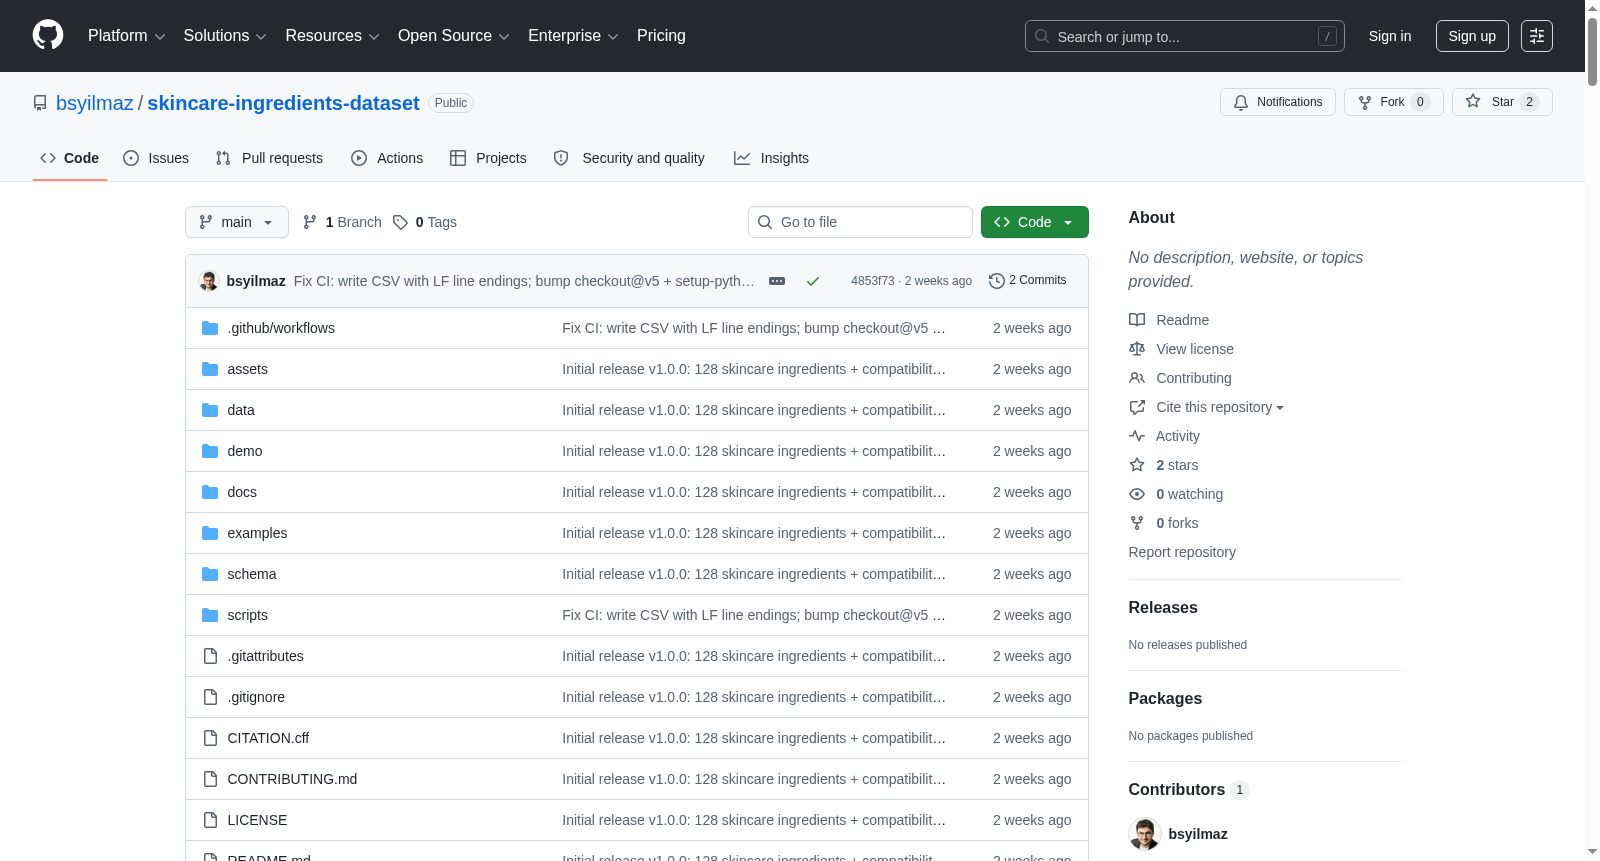
skincare-ingredients-dataset/ ├── data/ # 数据集文件(自动生成) │ ├── ingredients.json # 完整数据集(美观格式) │ ├── ingredients.min.json # 精简格式 │ ├── ingredients.csv # 电子表格格式 │ ├── compatibility_rules.json # 混合引擎 │ ├── categories.json # 类别词汇表 │ ├── stats.json # 统计数据 │ └── by-category/ # 按类别分列的 JSON 文件 ├── schema/ # JSON 模式定义 ├── scripts/ # 工具脚本(数据源编辑于此) ├── examples/ # 使用示例 ├── demo/ # 交互式演示(单文件 HTML) ├── assets/ # 截图与社交媒体图片 └── docs/ # 文档
目标用户
- 护肤品/美容应用程序开发
- AI/大语言模型产品(提供结构化事实)
- 成分分析工具
- 护肤流程检查工具
- 数据科学与化妆品科学学习
注意事项
- 数据集采用 MIT 许可证,可免费用于商业和个人项目。
- 数据为教育与开发资源,不构成医疗建议。
- 致痘等级与孕期安全性标识基于化妆品科学共识,个体耐受度有差异,配方与pH值也会影响成分表现。