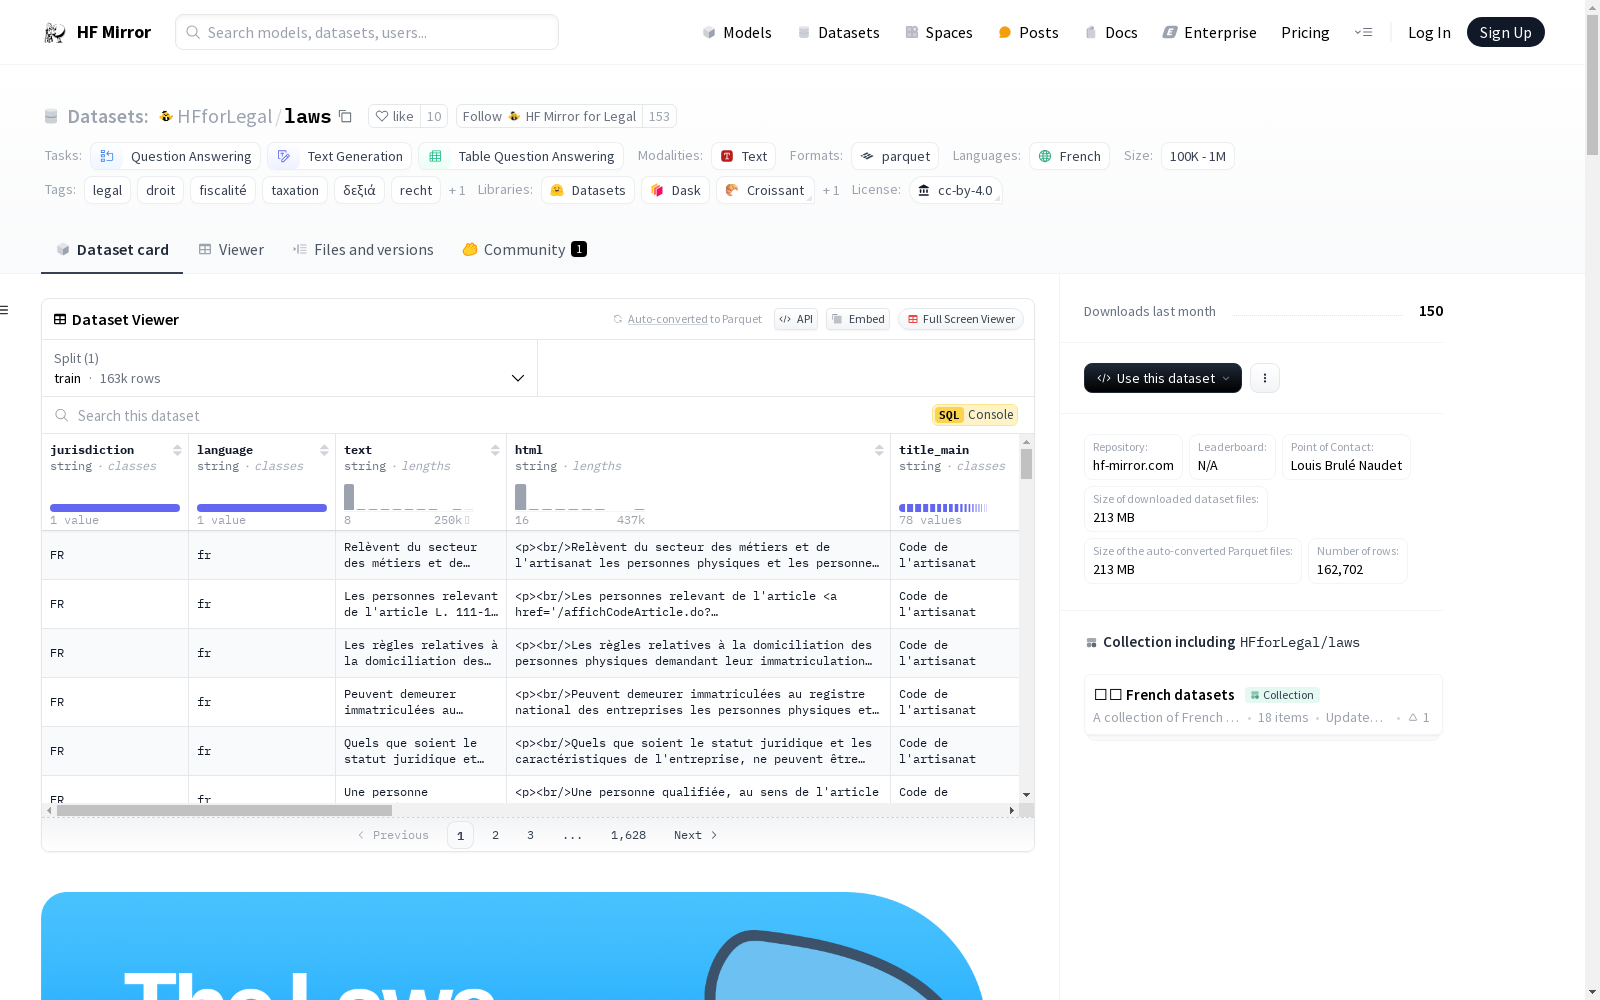
HFforLegal/laws
收藏资源简介:
The Laws数据集是一个集中了来自不同国家的法律文本的集合,旨在通过提供标准化的、易于访问的全球法律文档语料库来改进法律AI模型的开发。数据集包含多个特征,如书籍名称、文档内容、时间戳、ID和哈希值。数据集按国家划分,使用ISO 3166-1 alpha-2代码来标识不同国家的法律文档。此外,数据集还考虑了伦理问题,如隐私、偏见、时效性和管辖权问题。
The Laws Dataset is a comprehensive collection of legal texts from various countries, centralized in a common format. This dataset aims to improve the development of legal AI models by providing a standardized, easily accessible corpus of global legal documents. The dataset includes features such as book name, document content, timestamp, ID, and hash value. It is organized by country using ISO 3166-1 alpha-2 codes to identify legal documents from different jurisdictions. Additionally, the dataset addresses ethical considerations such as privacy, bias, currency, and jurisdiction.
数据集概述
数据集信息
- 特征:
book: 法律书籍的名称或代码(例如,"Civil Code", "Penal Code")document: 法律文件的完整文本内容timestamp: 法律生效或最后更新的时间戳id: 每个文档的标识符hash: 用于验证目的的document的SHA-256哈希值
- 分割:
fr: 包含153,005个样本,总大小为151,400,300字节
- 下载大小: 64,396,801字节
- 数据集大小: 151,400,300字节
- 配置:
default: 使用data/fr-*路径加载fr分割的数据
- 许可证: cc-by-4.0
- 任务类别:
- 问答
- 文本生成
- 表格问答
- 语言: 法语
- 标签:
- 法律
- 法律
- 财政
- 税收
- δεξιά
- recht
- derecho
- 名称: The Laws, centralizing legal texts for better use
目标
- 集中世界各地的法律文本于一个通用格式,以促进:
- 比较法律研究
- 多语言法律AI模型的开发
- 跨司法管辖区的法律研究
- 改进法律技术工具
数据集结构
book: 法律书籍的名称或代码document: 法律文件的完整文本内容timestamp: 法律生效或最后更新的时间戳id: 每个文档的标识符hash: 用于验证目的的document的SHA-256哈希值
国家分割
- 数据集使用基于国家的分割来组织来自不同司法管辖区的法律文件。每个分割由相应国家的ISO 3166-1 alpha-2代码标识。
- 示例代码:
- 法国: fr
- 美国: us
- 英国: gb
- 德国: de
- 日本: jp
- 巴西: br
- 澳大利亚: au
伦理考虑
- 隐私: 确保所有个人信息已正确匿名化。
- 偏见: 注意源材料和所包含法律的选择中可能存在的偏见。
- 时效性: 法律会随时间变化。始终验证您正在使用的法律版本是否为最新版本。
- 司法管辖: 法律解释可能因司法管辖区而异。基于此数据训练的AI模型不应替代专业法律建议。
引用
- 如果您在研究中使用此数据集,请使用以下BibTeX条目: BibTeX @misc{HFforLegal2024, author = {Louis Brulé Naudet}, title = {The Laws, centralizing legal texts for better use}, year = {2024}, howpublished = {url{https://huggingface.co/datasets/HFforLegal/laws}}, }