
community-datasets/dyk
收藏官方服务:
资源简介:
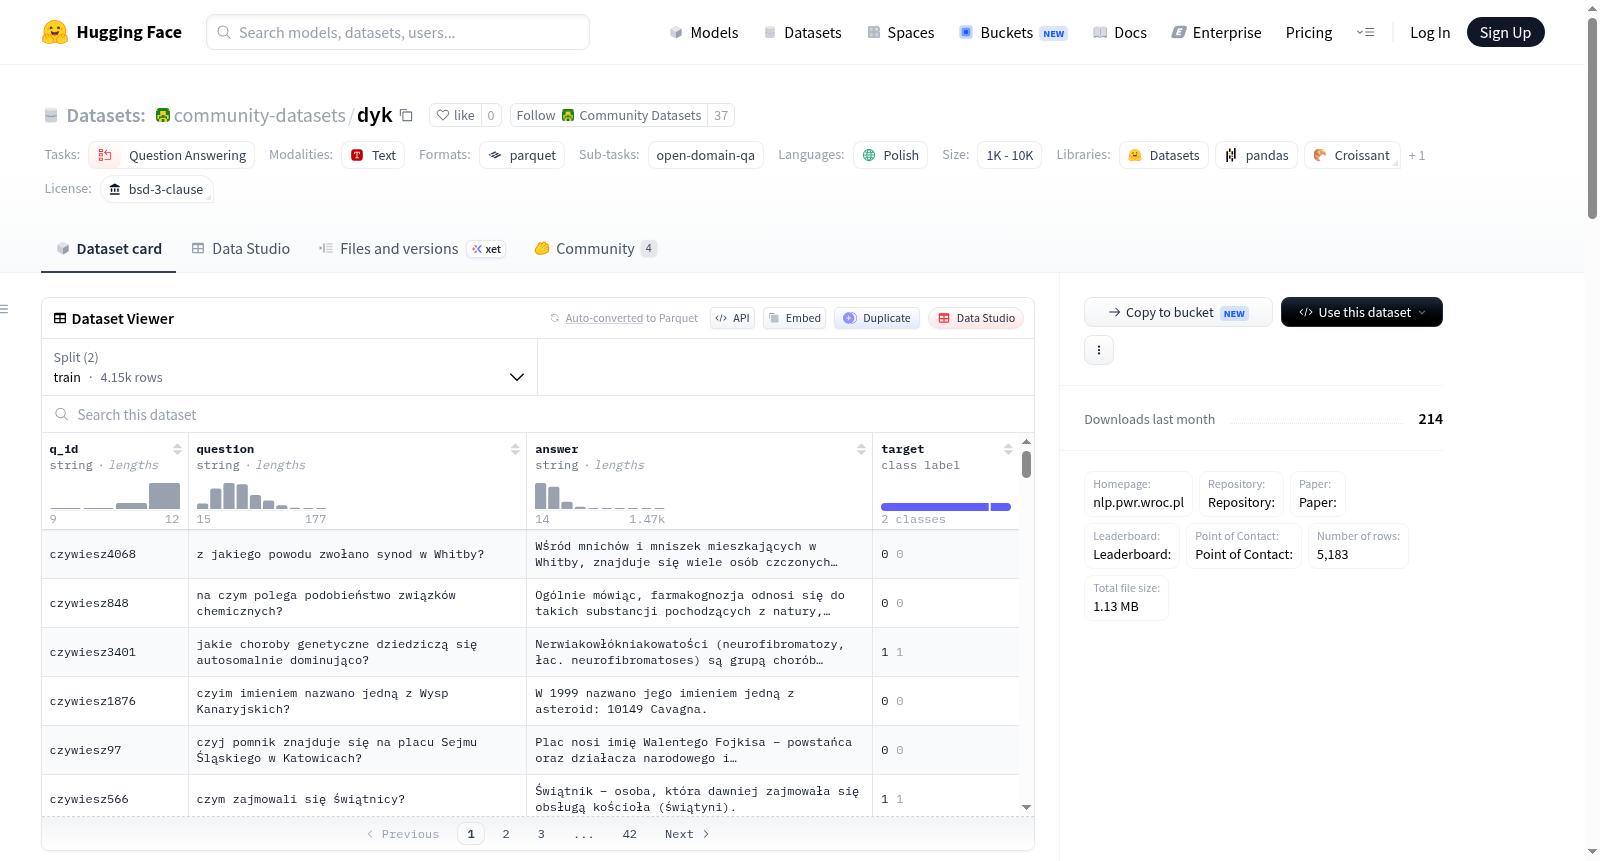
Did You Know(波兰语:Czy wiesz?)数据集由人工标注的问答对组成,任务是预测答案是否正确。我们选择了与问题具有最大词重叠的负样本。数据集包含波兰语的问答对,分为训练集和测试集,训练集包含4154个样本,测试集包含1029个样本。数据集的字段包括问题ID、问题句子、答案句子和目标值(1表示答案正确,0表示错误,测试集中目标值为-1)。
The Did You Know (pol. Czy wiesz?) dataset consists of human-annotated question-answer pairs. The task is to predict if the answer is correct. We chose the negatives which have the largest token overlap with a question. The dataset contains question-answer pairs in Polish, divided into a training set with 4154 examples and a test set with 1029 examples. The dataset fields include question ID, question sentence, answer sentence, and target value (1 if the answer is correct, 0 otherwise, with -1 used in the test set).
提供机构:
community-datasets原始信息汇总
数据集概述
数据集描述
- 数据集名称: dyk
- 数据集摘要: 该数据集包含人工标注的问答对,任务是预测答案是否正确。我们选择了与问题具有最大token重叠的负例。
- 支持的任务和排行榜:
- 任务类别: 问答
- 任务ID: 开放领域问答
- 语言: 波兰语
数据集结构
数据字段
- q_id: 问题ID,数据类型为字符串
- question: 问题句子,数据类型为字符串
- answer: 答案句子,数据类型为字符串
- target: 如果答案正确则为1,否则为0。注意测试集没有目标值,因此使用-1代替
数据分割
- 训练集:
- 字节数: 1388678
- 样本数: 4154
- 测试集:
- 字节数: 353631
- 样本数: 1029
数据集大小
- 下载大小: 1125972字节
- 数据集大小: 1742309字节
数据集创建
数据来源
- 标注创建者: 专家生成
- 语言创建者: 其他
- 多语言性: 单语
- 源数据集: 原始数据
配置
- 配置名称: default
- 数据文件:
- 训练集: data/train-*
- 测试集: data/test-*
- 数据文件:
许可信息
- 许可证: BSD-3-Clause
搜集汇总
数据集介绍
构建方式
在开放领域问答的研究中,高质量的人机交互数据是模型训练的关键基石。dyk(Did You Know)数据集源自波兰语社区,由领域专家精心构建,旨在评估问答系统的准确性。该数据集通过人工标注的方式生成问答对,其中负例的选取策略尤为精妙——系统性地选择与问题具有最大词汇重叠的干扰项作为错误答案,从而增强模型的判别能力。数据被划分为训练集和测试集,分别包含4154条和1029条样本,每条记录由问题ID、问题文本、答案文本及二元标签构成,标签指示答案是否正确。这种结构化的构建方式为波兰语问答任务提供了严谨的基准资源。
特点
dyk数据集的核心特点在于其针对波兰语单语环境的专注设计,以及标签分布的二元分类特性。数据集规模适中(1K至10K),既保证了统计有效性,又便于快速迭代实验。其独特之处在于负例构建的挑战性——通过最大化词汇重叠来模拟真实场景中的语义混淆,迫使模型超越浅层匹配,深入理解问题与答案的语义关系。此外,测试集隐藏真实标签(以-1替代),确保了评估的公正性。这些特性使dyk成为检验问答模型鲁棒性和波兰语自然语言处理能力的理想测试床。
使用方法
使用dyk数据集时,研究者可借助HuggingFace Datasets库便捷加载,通过指定配置名'default'即可获取训练和测试分片。数据加载后,每条样本包含'q_id'、'question'、'answer'和'target'字段,其中'target'为0或1的整数标签,适用于二分类任务。模型训练可采用交叉熵损失函数进行优化,测试阶段需自行预测答案正确性并提交结果。该数据集特别适合用于评估预训练语言模型在波兰语问答场景下的判别能力,为跨语言问答系统的研究提供标准化评估框架。
背景与挑战
背景概述
在自然语言处理领域,开放域问答系统旨在从大规模知识库中精准检索并验证答案,而答案验证的准确性直接影响系统的可靠性与用户体验。dyk(Did You Know,波兰语Czy wiesz?)数据集由波兰弗罗茨瓦夫理工大学自然语言处理团队于近年创建,核心研究问题聚焦于判断给定问答对中答案的正确性。该数据集通过人工标注方式构建,包含约5000个波兰语问答对,其中负样本特意选取与问题具有最大词汇重叠的错误答案,以模拟真实场景中高度混淆的干扰项。dyk数据集的发布填补了波兰语开放域答案验证任务的资源空白,为低资源语言的自然语言理解研究提供了重要基准,推动多语言问答系统的公平性评估与鲁棒性提升。
当前挑战
dyk数据集所解决的领域问题在于开放域问答中的答案验证任务,其核心挑战包括:1)答案歧义性消解——负样本与问题存在显著词汇重叠,导致模型难以区分语义正确性与表面相似性,亟需深层语义理解能力;2)低资源语言适配——波兰语形态丰富且标注数据稀缺,限制了预训练语言模型的泛化性能。在构建过程中,挑战集中于:1)高质量负样本生成——人工设计具有高度迷惑性的错误答案需兼顾语义偏离与词汇重叠,对标注专家的语言学知识要求严苛;2)标注一致性保障——多人标注中需统一判断标准以避免主观偏差,同时确保正负样本比例平衡以支持有效训练。
常用场景
经典使用场景
在自然语言处理领域,问答系统的可靠性验证始终是研究焦点,而dyk数据集正是为此而设计。该数据集由专家精心标注的波兰语问答对构成,其核心任务在于判断给定答案是否正确。经典的使用场景是将该数据集作为二分类任务的基准,通过对比模型在正误答案判别上的表现,来评估其对语义一致性与事实关联性的理解能力。研究者通常利用其独特的负样本构造策略——选取与问题具有最大词汇重叠的错误答案——来检验模型在细粒度语义区分上的鲁棒性。
衍生相关工作
dyk数据集的发布催生了多项相关研究工作,尤其在对抗性样本生成与鲁棒问答验证领域。研究者借鉴其负样本构建思路,开发了基于词汇重叠和语义干扰的自动负采样算法,并应用于其他语言的问答数据集。此外,该数据集还推动了波兰语自然语言处理中预训练模型的微调策略研究,如利用其训练BiLSTM、Transformer等架构的二分类模型,为后续跨语言迁移学习提供了基准参考。这些工作共同拓展了问答验证任务的边界,强化了模型对语言歧义性的处理能力。
数据集最近研究
最新研究方向
在开放域问答系统的前沿研究中,dyk数据集因其独特的负样本设计而备受关注。该数据集聚焦于波兰语问答任务,通过人工标注构建了包含正确答案与高词元重叠错误答案的配对样本,旨在挑战模型对语义细微差别的辨别能力。当前研究热点集中在该数据集如何助力多语言问答模型的鲁棒性提升,特别是在处理低资源语言时,dyk提供的对抗性负样本为评估模型避免虚假关联提供了关键基准。随着多语言预训练模型的普及,dyk数据集成为检验模型在词元重叠干扰下保持回答准确性不可或缺的测试平台,其影响延伸至跨语言信息检索与事实核查等关联领域,推动了更可靠、更去偏的问答系统研发。
以上内容由遇见数据集搜集并总结生成


