
mteb/OBLIQBenchRetrieval
收藏官方服务:
资源简介:
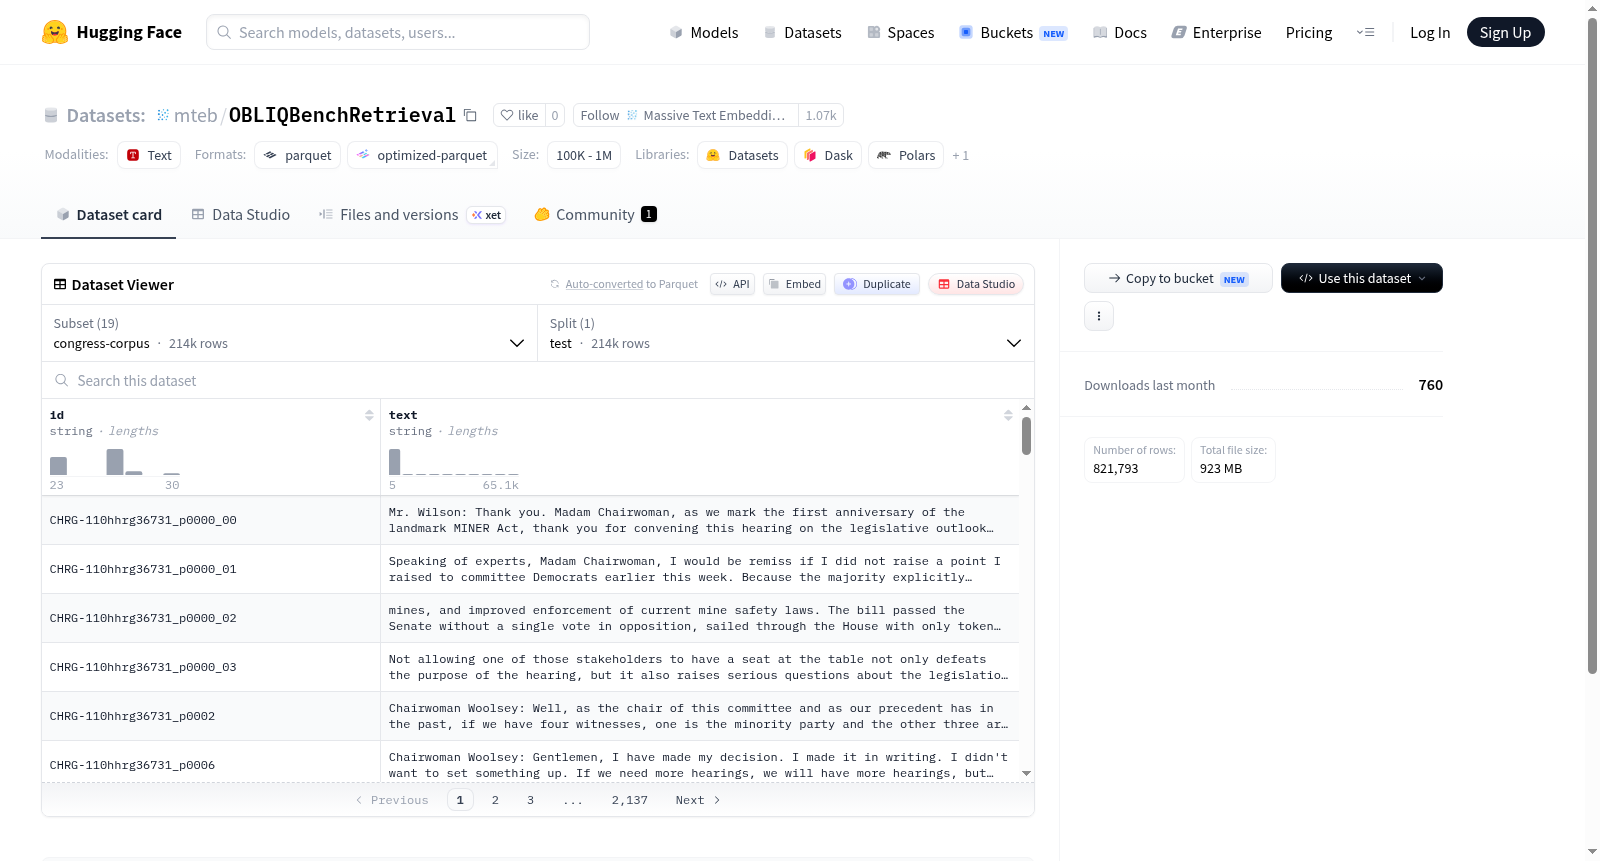
该数据集包含多个领域的检索任务,包括美国国会文件、数学问题、推文、WildChat对话和写作风格等。每个领域包括语料库、查询和相关性判断(qrels),用于评估信息检索系统性能。
This dataset contains multiple retrieval tasks across different domains, including U.S. Congress documents, math problems, Twitter tweets, WildChat conversations, and writing style. Each domain includes a corpus, queries, and relevance judgments (qrels) for evaluating retrieval system performance.
提供机构:
mteb搜集汇总
数据集介绍
构建方式
OBLIQBenchRetrieval数据集专为信息检索领域的大语言模型幻觉检测评估而构建,涵盖了国会听证会、数学问题、推特对话、WildChat聊天记录以及写作风格五大领域。每个领域均以‘语料库-查询-相关性标注’三元组形式组织,并提供可选的排除集与预计算排名集。数据源自公开的真实文本,经人工或自动化流程抽取查询及其对应的相关文档,并赋予相关性分数,从而形成结构化的检索评估基准。
使用方法
使用OBLIQBenchRetrieval数据集时,研究者可通过HuggingFace Datasets库按需加载不同配置。以Python为例,调用`load_dataset("OBLIQBenchRetrieval", "corpus", split="test")`即可获取指定领域的语料。随后,结合对应查询集与qrels,可构建标准的检索实验流程。对于需要排除特定文档的场景,可利用excluded配置中的文档ID列表过滤语料。数据集全部采用test分割,无需再行划分,简化了评估流程。最终,通过比较检索系统返回的文档排名与qrels中的标注,即可计算准确率、召回率、NDCG等经典指标,量化模型在减轻事实性幻觉方面的表现。
背景与挑战
背景概述
OBLIQBenchRetrieval数据集旨在评估和提升大型语言模型在长文本检索任务中的表现,涵盖了国会听证会、数学、推特、写作和对话等多个领域。该数据集由相关研究团队创建,聚焦于解决信息检索领域中对复杂、长上下文查询进行精确匹配和排序的核心问题。通过提供丰富的语料库、查询及其相关性判断,OBLIQBenchRetrieval为学术界提供了一套标准化的评测基准,推动了长文本检索技术从粗粒度匹配向细粒度语义理解的演进,对自然语言处理和信息检索领域产生了重要影响。
当前挑战
该数据集面临的主要挑战包括:1) 长文本检索中查询与文档间语义鸿沟难以逾越,尤其是面对多义性、隐含意图或领域术语时,模型需具备深度理解与推理能力;2) 数据构建过程中,为确保语料的多样性与代表性,需从海量异构源中筛选并标注相关对,人工标注成本高且一致性难以保障;3) 面对数学、法律等专业领域,现有检索模型常因缺乏领域知识而导致召回率与精度失衡,对模型泛化能力提出严峻考验。
常用场景
经典使用场景
在信息检索与自然语言处理领域,OBLIQBenchRetrieval数据集作为一项综合性基准测试资源,专为评估检索系统在多领域语料中的表现而设计。它囊括了国会听证会文档、数学问题、社交媒体推文(Twitter)、开放域聊天对话(WildChat)以及写作风格文本等丰富多样的子集,每一部分均配备独立的查询、语料库及相关性判断(qrels)。该数据集最经典的使用场景在于构建和验证稠密检索、稀疏检索或混合检索模型,特别是在处理长文本、专业术语、非正式语言及多模态语义匹配时的检索精度与效率。研究者通过该数据集可系统性地评测模型在跨领域、跨风格文本上的泛化能力,从而推动检索技术的演进与优化。
解决学术问题
OBLIQBenchRetrieval数据集有效地解决了信息检索领域中长期存在的两个关键学术问题:领域迁移评估与细粒度相关性判别。学术研究中,检索模型往往在单一领域(如新闻或科学文献)表现优异,但面对法律、数学、社交媒体等异构数据时性能骤降。该数据集通过提供跨领域、跨风格的标准化测试平台,使研究者能够定量分析模型在不同数据生态下的鲁棒性。此外,其包含的多级相关性评分(qrels)为研究更细粒度的排序学习、零样本检索及对抗性鲁棒性提供了宝贵资源。这一数据集的意义在于推动了检索系统从实验室环境向现实世界复杂场景的跨越,深化了对语义匹配本质规律的理解,并促进了更公平、可复现的学术评价体系的建立。
实际应用
在实际应用层面,OBLIQBenchRetrieval数据集的影响力辐射至多个工业与公共事业领域。例如,在政府信息公开与立法咨询系统中,基于国会听证会子集训练的检索模型能够高效地从海量法案记录中提取与特定议题相关的文书,辅助政策分析师与立法者进行决策。在数学教育领域,针对数学问题的检索模型可以帮助学生或研究人员快速定位相关定理、证明步骤或类似习题,从而提升学习与科研效率。社交媒体监控工具则利用Twitter子集进行舆情分析与内容审核,从纷繁的推文中精准挖掘冲突性话题或敏感信息。此外,写作辅助工具借助写作风格子集,能够在用户输入草稿时推荐风格匹配的范文或段落,实现个性化内容创作支持。这些应用场景共同凸显了数据集在提升信息获取效率、优化公共服务质量方面的实际价值。
数据集最近研究
最新研究方向
OBLIQBenchRetrieval数据集近期研究聚焦于构建跨领域、多模态的信息检索基准,涵盖国会听证、数学推理、社交媒体和对话系统等场景,以评测检索模型在复杂语义理解和对抗性噪声下的鲁棒性。伴随大型语言模型(LLM)生成内容激增,该数据集引入“写作”与“数学”子集,专门用于检测模型在长文本推理和逻辑挖掘中的表现,呼应了AI生成内容可检索性与真实性验证的热点。其“冲突”与“元程序”配置更推动了对抗性检索研究,为评估模型在矛盾或误导性信息中的辨别力提供了关键支撑,对构建可信赖的智能检索系统具有深远意义。
以上内容由遇见数据集搜集并总结生成


