
dpo_answer_openorca_openorca_argilla_rejudged_filtered_1e-6_0.02_1.7B_4B_with_gold_labels_kl_est
收藏数据链接:
官方服务:
资源简介:
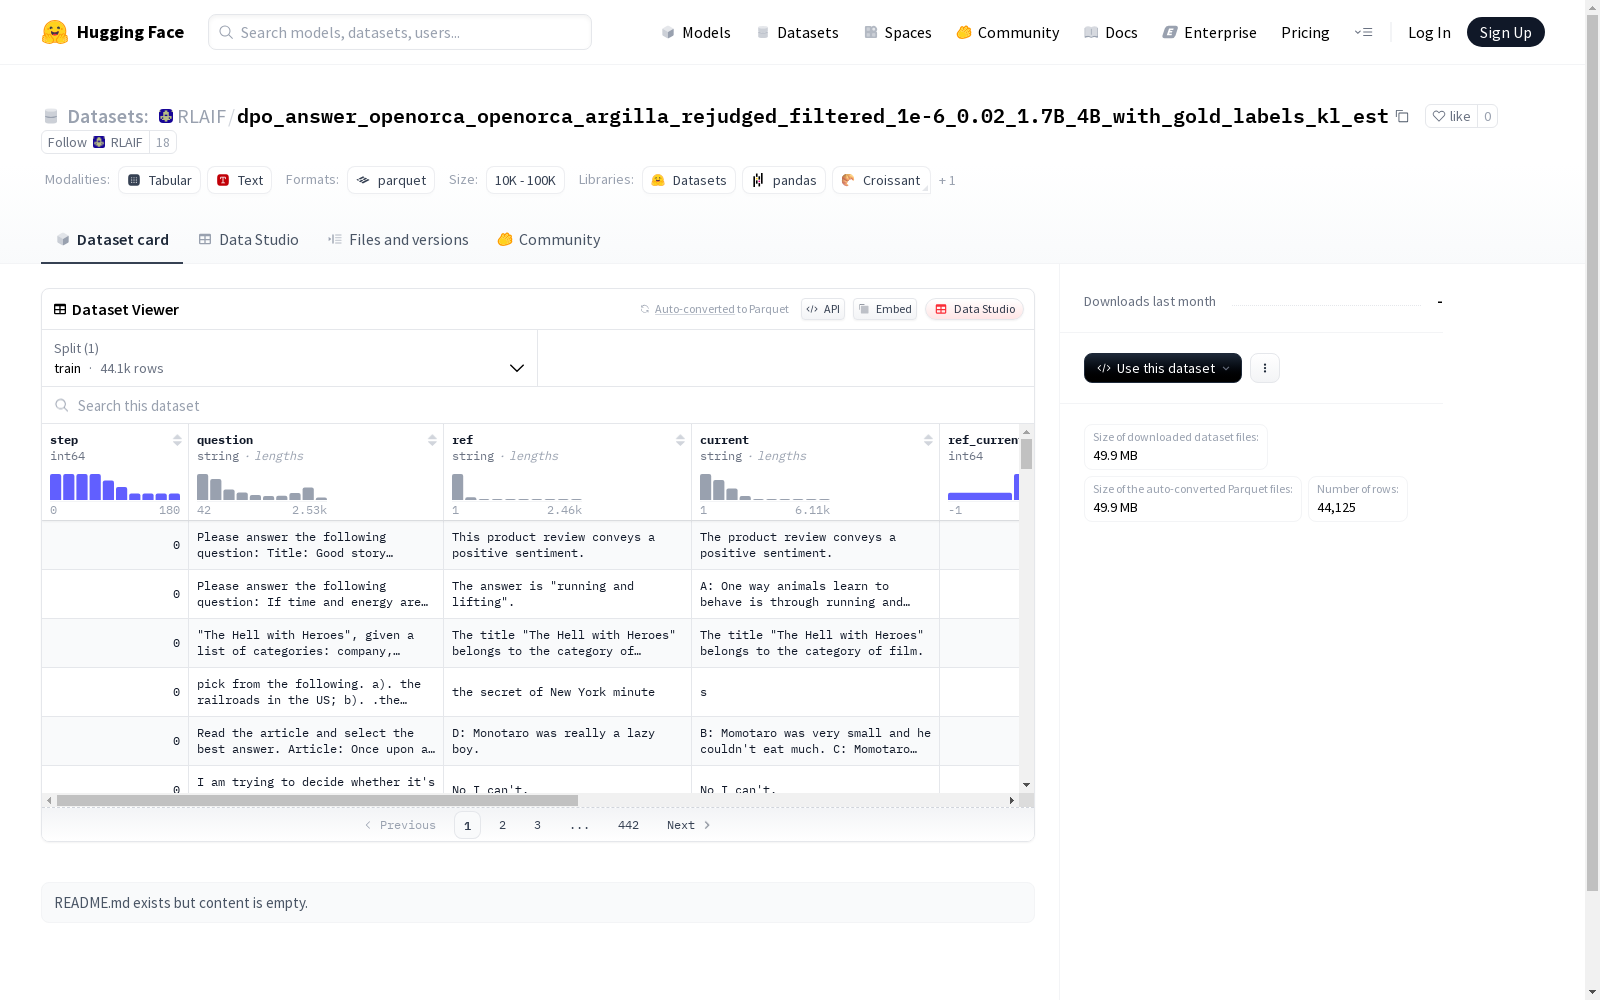
该数据集包含了用户的交互步骤、问题文本、参考答案文本、当前答案文本等字段。数据集通过KL散度等指标来衡量答案之间的差异,并标记了参考答案是否为A类答案以及真实标签。数据集被划分为训练集,共有44125个示例,文件大小为89536865字节。
提供机构:
RLAIF创建时间:
2025-08-31
原始信息汇总
数据集概述
基本信息
- 数据集名称:RLAIF/dpo_answer_openorca_openorca_argilla_rejudged_filtered_1e-6_0.02_1.7B_4B_with_gold_labels_kl_est
- 来源地址:https://huggingface.co/datasets/RLAIF/dpo_answer_openorca_openorca_argilla_rejudged_filtered_1e-6_0.02_1.7B_4B_with_gold_labels_kl_est
- 下载大小:49,901,382 字节
- 数据集大小:89,536,865 字节
数据规模
- 训练集样本数量:44,125 个
- 训练集大小:89,536,865 字节
特征结构
- step:int64 类型
- question:string 类型
- ref:string 类型
- current:string 类型
- ref_current:int64 类型
- current_ref:int64 类型
- kl_divergence:float64 类型
- ref_is_A:bool 类型
- gold:int64 类型
- kl_estimated:float64 类型
数据配置
- 默认配置:default
- 数据文件路径:data/train-*
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,高质量的训练数据对模型性能至关重要。该数据集基于OpenOrca和Argilla平台的数据源,通过严谨的筛选流程构建而成,具体采用KL散度估计方法对样本进行过滤,设定阈值为1e-6和0.02,确保数据质量。构建过程中还融入了人工重标注环节,并引入黄金标签作为质量基准,最终形成包含4.4万余条样本的训练集。
使用方法
针对直接偏好优化(DPO)的研究需求,该数据集可直接用于训练对话模型的偏好学习模块。使用者可通过加载标准数据分割接口获取训练集,利用question作为输入提示,结合ref和current构建正负样本对,并通过kl_estimated等字段计算损失函数。数据集的标准化特征设计确保了与主流训练框架的兼容性,支持端到端的模型优化流程。
背景与挑战
背景概述
在人工智能领域,偏好对齐技术对于提升大型语言模型的性能与安全性具有关键意义。dpo_answer_openorca_openorca_argilla_rejudged_filtered_1e-6_0.02_1.7B_4B_with_gold_labels_kl_est数据集由OpenOrca与Argilla等研究机构联合构建,专注于通过直接偏好优化方法优化模型输出。该数据集整合了人类反馈与自动评估机制,旨在解决模型生成内容的质量控制与偏好学习问题,对推动对话系统与生成式AI的发展具有重要影响。
当前挑战
该数据集核心挑战在于解决偏好学习中的噪声过滤与质量评估问题,需确保生成响应的准确性与一致性。构建过程中面临多重困难,包括大规模数据清洗中的标注一致性维护、KL散度计算的计算复杂度优化,以及黄金标签与估计值之间的偏差校准。这些挑战要求高效算法设计与高质量人工审核的结合,以保障数据可靠性。
常用场景
经典使用场景
在自然语言处理领域,该数据集专为直接偏好优化(DPO)算法设计,通过包含人类偏好的对比样本,为模型对齐提供高质量训练数据。研究人员利用其丰富的问答对和人工标注的偏好标签,训练语言模型更好地理解和遵循人类指令,显著提升模型在开放域对话中的响应质量与安全性。
解决学术问题
该数据集有效解决了语言模型对齐中的奖励建模难题,通过精确的KL散度估计和黄金标签标注,为DPO训练提供了可靠的偏好信号。它帮助学术界克服了传统强化学习从人类反馈中训练模型的高成本问题,推动了无需显式奖励模型的参数高效对齐方法发展,对可解释AI研究具有重要价值。
实际应用
在实际应用中,该数据集支撑了对话系统和智能助手的优化部署,使模型能够生成更符合人类价值观的响应。企业可基于其训练的模型开发客户服务机器人、教育辅导系统和内容生成工具,这些应用在保持对话连贯性的同时,显著降低了产生有害或偏见内容的风险,提升了用户体验。
数据集最近研究
最新研究方向
在对话系统与对齐技术领域,该数据集通过整合DPO训练框架与KL散度估计机制,为模型偏好优化提供了精细化标注数据。当前研究聚焦于利用此类数据提升语言模型的人类偏好对齐能力,特别是在减少幻觉响应和增强答案可靠性方面。热点方向包括结合强化学习从人类反馈中提取更稳定的奖励信号,以及探索多模态语境下的偏好学习范式。这类数据集对推动可解释人工智能发展具有关键意义,为构建更安全、可控的大型语言模型奠定了数据基础。
以上内容由遇见数据集搜集并总结生成


