odia_pretrain_dataset_v2
收藏资源简介:
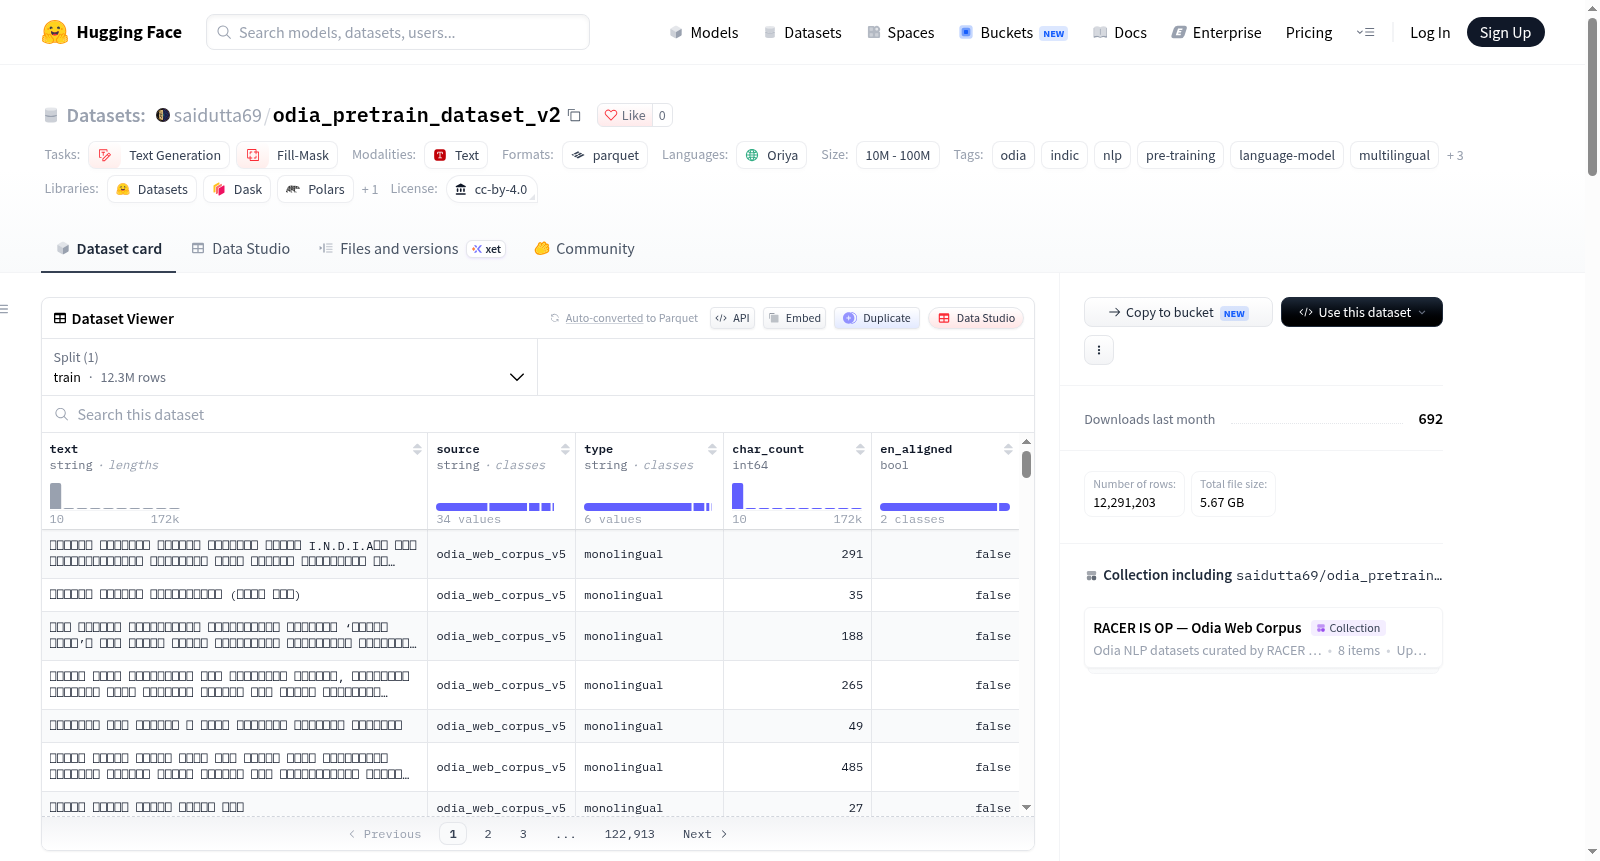
Odia Pretrain Dataset v2 是一个高质量、大规模的奥里亚语(Odia)预训练数据集。该数据集由Sai Dutta Abhishek Dash构建,在v1版本基础上新增了来自Wikipedia Odia、IndicCorpV2等来源的数据,经过跨来源去重后,最终包含12,291,203个独特的奥里亚语文档,覆盖30多个数据源。数据集采用CC-BY-4.0许可证,可免费用于商业和研究目的,无需任何形式的申请或门控。数据以Parquet格式存储(32个分片),每个样本包含以下字段:text(干净的奥里亚语文本)、source(数据来源,如monsoon-nlp、wikipedia、indiccorp_v2)、type(固定为'pretrain')、char_count(字符长度,整数类型)、en_aligned(是否具有英文对齐,布尔类型)。该数据集特别适合用于奥里亚语语言模型的预训练、文本生成、掩码语言建模等自然语言处理任务。用户可通过Hugging Face datasets库直接加载使用。
Odia Pretrain Dataset v2 is a high-quality, large-scale Odia pretraining dataset. It was constructed by Sai Dutta Abhishek Dash, building upon the v1 version by adding data from sources such as Wikipedia Odia and IndicCorpV2. After cross-source deduplication, it contains 12,291,203 unique Odia documents covering over 30 data sources. The dataset is licensed under CC-BY-4.0, free for commercial and research purposes without any application or gating. Data is stored in Parquet format (32 shards), with each sample including the following fields: text (clean Odia text), source (data source, e.g., monsoon-nlp, wikipedia, indiccorp_v2), type (fixed as pretrain), char_count (character length, integer), en_aligned (whether it has English alignment, boolean). This dataset is particularly suitable for pretraining Odia language models, text generation, masked language modeling, and other NLP tasks. Users can directly load it via the Hugging Face datasets library.
Odia Pretrain Dataset v2 数据集详情
基本信息
- 数据集名称: Odia Pretrain Dataset v2
- 语言: 奥里亚语(Odia,语言代码:
or) - 许可协议: CC-BY-4.0(可商用)
- 访问限制: 无(无需申请或门控)
- 数据规模: 12,291,203 行(约 1230 万条)
- 数据来源: 30+ 个来源
- 文件格式: Parquet(32 个分片)
数据来源构成
| 来源 | 行数 | 说明 |
|---|---|---|
| v1 数据集(25+ 来源) | 10,290,562 | 新闻、网页爬取、IndicNLP、Varta、Samanantar、xp3、OdiaQA、Wikipedia、Alpaca 等 |
| monsoon-nlp/odia-cleaned | 0(完全去重) | 与 v1 完全重叠 |
| Wikipedia(奥里亚语) | 641 | v1 中未包含的奥里亚语维基百科文章 |
| IndicCorpV2(奥里亚语) | 2,000,000 | AI4Bharat 的 IndicCorpV2 奥里亚语子集 |
数据字段说明
| 字段 | 类型 | 描述 |
|---|---|---|
text |
string | 清洗后的奥里亚语文本 |
source |
string | 数据来源(monsoon-nlp、wikipedia 或 indiccorp_v2) |
type |
string | 固定为 "pretrain" |
char_count |
int64 | 字符长度 |
en_aligned |
bool | 是否有英文对齐 |
数据集用途
该数据集适用于以下自然语言处理任务:
- 文本生成(text-generation)
- 掩码语言建模(fill-mask)
- 预训练语言模型
使用方式
可通过 Hugging Face datasets 库直接加载:
python
from datasets import load_dataset
ds = load_dataset("saidutta69/odia_pretrain_dataset_v2", split="train")
支持按来源过滤数据,并可计算字符长度分布等统计信息。
背景说明
该数据集是在 v1 基础上构建的,v1 曾因过滤掉 98% 的数据而受到批评。v2 在保留 v1 全部数据的基础上,新增了 Wikipedia 奥里亚语文章和 IndicCorpV2 的 200 万条数据,经全面去重后达到 1230 万条独特文本,相较于 v1 增加了 19% 的数据量。