polish-dynaword
收藏资源简介:
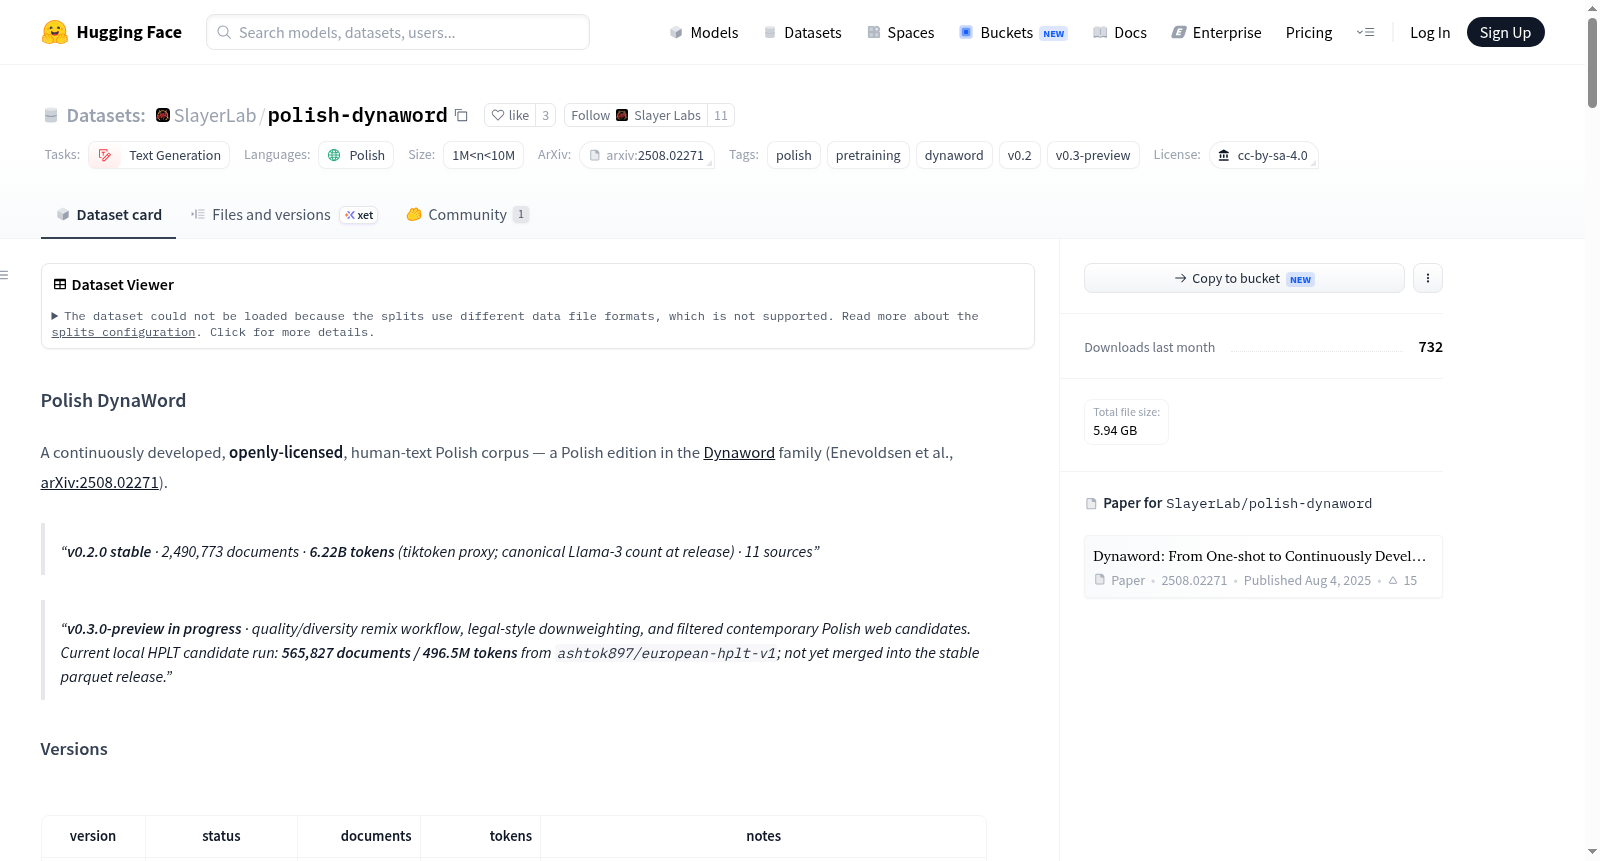
Polish DynaWord是一个持续开发、开源许可的波兰语人类文本语料库,属于Dynaword家族(Enevoldsen等人,arXiv:2508.02271)的波兰语版本。数据集的核心价值在于其策展工作,而非原始数据本身。当前包含两个版本:v0.2.0稳定版,包含来自11个开放/官方来源的2,490,773个文档,约62.2亿个标记(基于Llama-3计数);以及v0.3.0预览版,正在开发中,计划整合经过质量/多样性重新混合、法律风格降权和过滤的当代波兰网络候选数据。数据来源包括EUR-Lex(欧盟法律文件)、波兰议会语料库、波兰维基百科、波兰维基文库、Dziennik Ustaw(波兰主要立法)、Wolne Lektury(学校读物)、波兰维基语录、ELTeC-pol(欧洲文学文本集)、波兰维基导游、波兰维基教科书和波兰维基新闻。所有来源均经过严格的许可证审查,确保具有开放、可追溯的法律基础。数据集遵循Dynaword方法论,包括:1)按来源进行许可证审查;2)应用最小化、可重复的过滤与标准化(短文档、非波兰语、精确跨源去重、OCR乱码);3)为每个来源提供数据表文档;4)确保可重复性和版本控制。数据模式统一为:id、text、source、added、created、token_count。数据集仅包含人类创作文本,不含合成、机器翻译或自动转录数据。适用于波兰语文本生成和预训练任务,遵循CC-BY-SA-4.0许可证发布,要求下游用户遵守各上游许可证,特别是CC-BY-SA-4.0的署名和相同方式共享要求。
Polish DynaWord is a continuously developed, open-source licensed Polish human text corpus, serving as the Polish version of the Dynaword family (Enevoldsen et al., arXiv:2508.02271). The core value of the dataset lies in its curation efforts rather than the raw data itself. It currently includes two versions: v0.2.0 stable, containing 2,490,773 documents from 11 open/official sources, with approximately 6.22 billion tokens (based on Llama-3 counting); and v0.3.0 preview, under development, planning to integrate contemporary Polish web candidate data with quality/diversity remixing, legal style de-weighting, and filtering. Data sources include EUR-Lex (EU legal documents), Polish parliamentary corpus, Polish Wikipedia, Polish Wikisource, Dziennik Ustaw (primary Polish legislation), Wolne Lektury (school readings), Polish Wikiquote, ELTeC-pol (European literary text collection), Polish Wikivoyage, Polish Wikibooks, and Polish Wikinews. All sources undergo strict license review to ensure an open, traceable legal basis. The dataset follows the Dynaword methodology, including: 1) license review by source; 2) application of minimal, reproducible filtering and standardization (short documents, non-Polish language, exact cross-source deduplication, OCR gibberish); 3) provision of data sheet documents for each source; 4) ensuring reproducibility and version control. The data schema is unified as: id, text, source, added, created, token_count. The dataset contains only human-authored text, with no synthetic, machine-translated, or automatically transcribed data. It is suitable for Polish text generation and pre-training tasks, and is released under the CC-BY-SA-4.0 license, requiring downstream users to comply with upstream licenses, particularly the attribution and share-alike requirements of CC-BY-SA-4.0.