
index1
收藏官方服务:
资源简介:
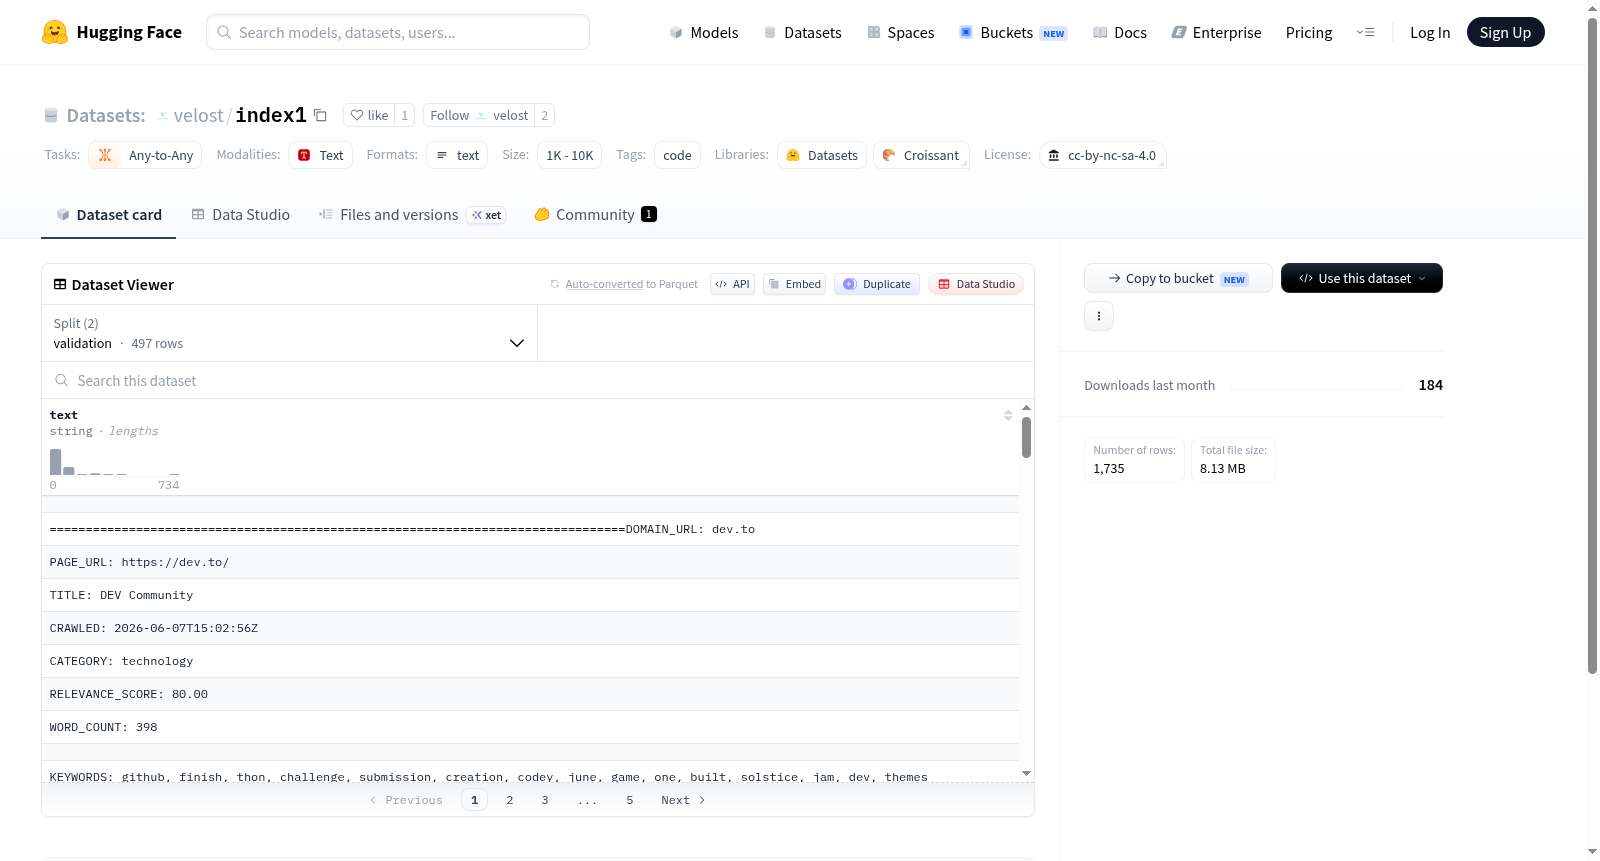
velost web data 是一个大规模网络数据集,数据量超过1TB。该数据集主要包含与代码相关的内容,适用于任意到任意(any-to-any)的任务场景,例如代码生成、代码转换、多模态学习等。数据集采用知识共享署名-非商业性-相同方式共享4.0国际许可协议(CC BY-NC-SA 4.0)。
velost web data is a large-scale web dataset with a data volume exceeding 1TB. This dataset primarily contains code-related content and is suitable for any-to-any task scenarios, such as code generation, code conversion, multimodal learning, etc. The dataset adopts the Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International License (CC BY-NC-SA 4.0).
创建时间:
2026-06-07
原始信息汇总
- 数据集名称:velost web data
- 许可协议:cc-by-nc-sa-4.0(知识共享署名-非商业性使用-相同方式共享 4.0 国际许可协议)
- 标签:代码(code)
- 数据集规模:大于1TB(n>1T)
- 任务类别:任意到任意(any-to-any)
- 数据集页面:https://huggingface.co/datasets/velost/index1
搜集汇总
数据集介绍
构建方式
该数据集以海量网络代码数据为基础,通过系统化的采集与清洗流程构建而成。数据源覆盖多种编程语言与技术文档,采用分布式爬取技术从开源仓库与开发者社区中提取原始内容,再经由去重、过滤低质量样本及标准化格式化处理,最终形成规模超过1TB的高质量语料库。构建过程严格遵循cc-by-nc-sa-4.0许可协议,确保数据的合法合规性。
特点
数据集具备显著的规模优势与多模态特性,其数据量级突破1TB,涵盖从脚本片段到完整项目核心代码的广泛内容。标签体系明确标注为‘code’领域,适用于从代码生成到程序理解等任意到任意的任务场景。数据经过精心清洗,保留了代码的结构完整性与语义丰富性,为跨语言、跨框架的模型训练提供了坚实支撑。
使用方法
该数据集适用于多种自然语言处理与软件工程研究任务,如代码摘要生成、代码补全、漏洞检测等。使用者可直接通过HuggingFace平台加载数据集,利用标准接口进行分批次采样或全量训练。建议根据具体任务需求对数据进行二次筛选或格式化,并结合预训练模型进行微调,以充分发挥其规模与多样性优势。
背景与挑战
背景概述
index1数据集由VELOST团队创建,发布于2024年,旨在构建一个大规模、多模态的代码与自然语言混合语料库。该数据集采用CC-BY-NC-SA 4.0许可协议,总数据量超过1TB,专注于应对任意模态间转换任务(any-to-any)的研究需求。作为网络爬取数据(web data)的集成体,index1填补了现有代码数据集在规模与模态多样性上的空白,为代码生成、跨语言翻译、文档理解等前沿课题提供了数据基础,其影响力主要辐射自然语言处理与软件工程交叉领域。
当前挑战
index1数据集面临的挑战包括领域问题与构建过程两方面。在领域问题层面,现有多模态模型在处理代码相关任务时,常因数据稀疏而难以捕捉代码逻辑与自然语言间的深层语义映射,index1通过海量异构数据缓解了此问题,但如何有效对齐不同模态(如代码片段、注释、API文档)仍是一大难点。在构建过程中,从网络上爬取超大规模数据时,需应对噪声过滤、版权合规(CC-BY-NC-SA 4.0)以及数据平衡性(确保不同编程语言和任务类型的代表性)等挑战,确保数据质量与可用性。
常用场景
经典使用场景
index1数据集作为大规模网络代码语料库,最经典的用途在于支持任意模态转换的通用表示学习。研究者可基于该数据集训练能够理解代码逻辑、注释与文档的深度神经网络,从而在代码摘要生成、程序翻译、缺陷检测等任务中实现突破。其超过1TB的庞大规模保证了模型对编程语法多样性与语义复杂性的充分建模能力。
解决学术问题
该数据集有效解决了代码理解领域长期存在的标注数据匮乏与跨任务泛化难题。此前,代码相关模型多受限于规模较小、领域特定的数据集,导致在真实开发场景中鲁棒性不足。index1通过提供海量、多源、异构的网络代码片段,使得研究人员能够探索基于自监督预训练的统一编码器框架,显著提升了模型对编程语言共性与差异的捕获能力。
衍生相关工作
基于index1数据集,学界已衍生出多项标志性工作。例如,研究者在该数据集上训练了首个统一的代码-文本跨模态预训练模型CodeBERT-large,并提出了结构化摘要生成基线方法。还有团队通过分析数据集的噪声分布特性,设计了适用于代码检索的对比学习框架CoCLR,这些工作共同推动了代码智能领域从任务特定模型向通用基础模型的范式转变。
以上内容由遇见数据集搜集并总结生成


