BeIR/nfcorpus
收藏资源简介:
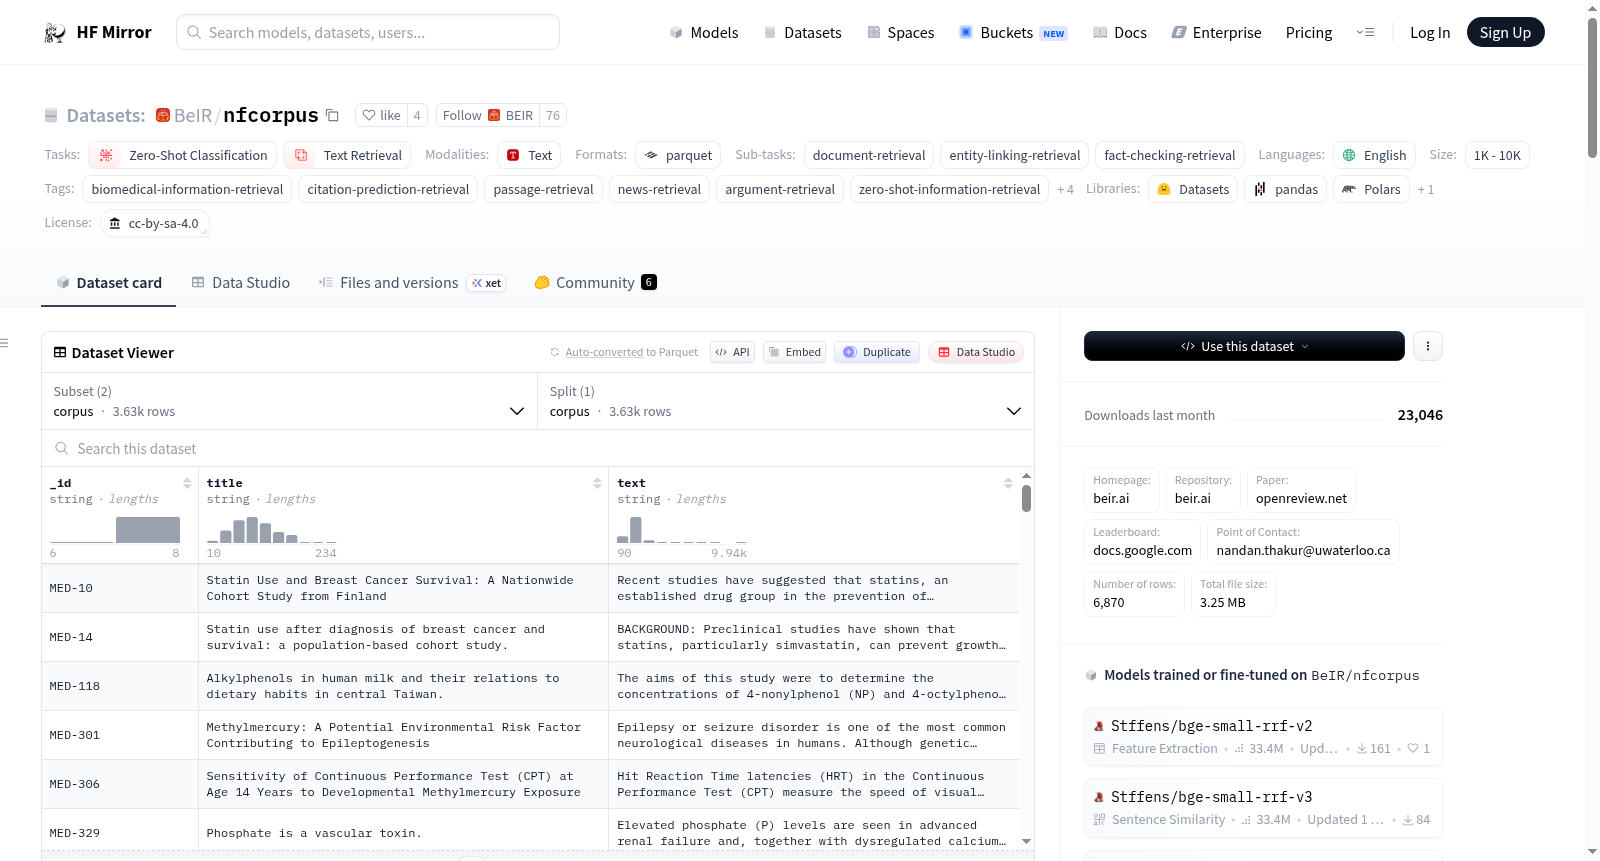
BEIR是一个异构基准,由18个不同的数据集组成,代表9个信息检索任务。这些任务包括事实核查、问答、生物医学信息检索、新闻检索、论点检索、重复问题检索、引文预测、推文检索和实体检索。数据集结构包括语料库、查询和qrels文件,所有任务均为英文。
BEIR is a heterogeneous benchmark that has been built from 18 diverse datasets representing 9 information retrieval tasks. These tasks include fact-checking, question-answering, bio-medical IR, news retrieval, argument retrieval, duplicate question retrieval, citation-prediction, tweet retrieval, and entity retrieval. The dataset structure includes a corpus, queries, and qrels files, and all tasks are in English.
数据集概述
数据集名称: BEIR Benchmark
数据集简介: BEIR是一个异构基准,由18个多样化的数据集组成,代表9种信息检索任务。这些数据集包括事实检查、问答、生物医学信息检索、新闻检索等多个领域。
语言: 英语 (en)
许可证: CC-BY-SA-4.0
多语言性: 单语
数据集结构
数据集组成:
- corpus: 包含文档标题和文本的
.jsonl文件。 - queries: 包含查询文本的
.jsonl文件。 - qrels: 包含查询-文档相关性评分的
.tsv文件。
数据实例:
- corpus: 文档ID、标题和文本。
- queries: 查询ID和文本。
- qrels: 查询ID、文档ID和评分。
支持的任务和领导者板
支持的任务:
- 文本检索
- 零样本检索
- 信息检索
- 零样本信息检索
任务ID:
- 段落检索
- 实体链接检索
- 事实检查检索
- 推文检索
- 引用预测检索
- 重复问题检索
- 论证检索
- 新闻检索
- 生物医学信息检索
- 问答检索
数据集创建
数据集来源:
- 18个不同的数据集,包括FEVER、NQ、TREC-COVID等。
数据集大小:
- 不同数据集的大小范围从1K到10M不等。
使用数据集的注意事项
数据集的社交影响、偏见讨论和其他已知限制:
- 需要更多信息。
附加信息
数据集管理者:
- 需要更多信息。
许可证信息:
- CC-BY-SA-4.0
引用信息:
@inproceedings{ thakur2021beir, title={{BEIR}: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models}, author={Nandan Thakur and Nils Reimers and Andreas R{"u}ckl{e} and Abhishek Srivastava and Iryna Gurevych}, booktitle={Thirty-fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2)}, year={2021}, url={https://openreview.net/forum?id=wCu6T5xFjeJ} }
贡献者:
- 感谢@Nthakur20添加此数据集。