
遇见数据集

nemotron-gym-inverse-ifeval-v2

收藏
Hugging Face2026-06-05 更新2026-06-06 收录
官方服务:

资源简介:

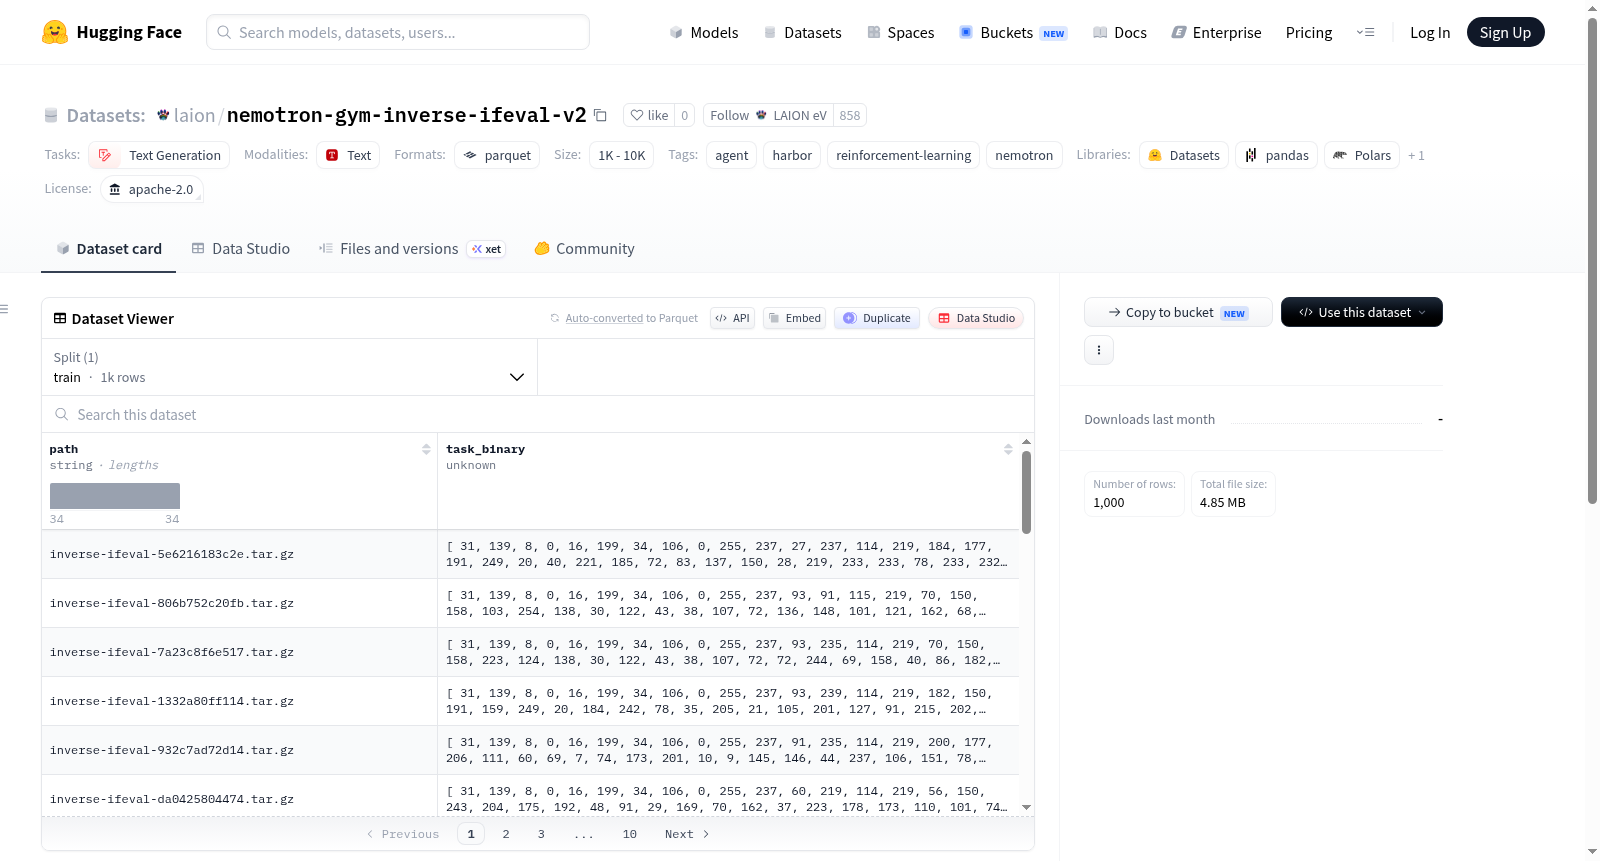
该数据集名为nemotron-gym-inverse-ifeval-v2,是一个Harbor任务二进制数据集,包含1,000个任务,源自nvidia/Nemotron-RL-InverseIFEval-v1(属于nvidia/Nemotron-Post-Training-v3系列)。数据以两列形式组织:path(字符串类型,表示路径)和task_binary(gzip tar压缩格式,存储任务二进制数据),转换过程使用了OpenThoughts-Agent的data.nemotron_gym框架。数据集主要用于文本生成和代理相关任务,涉及强化学习环境,评估采用多标准LLM评判(全部结果为YES),运行需配置OPENAI_API_KEY。与前一版本相比,本版本修复了终端代理的答案交付问题:明确指示代理通过shell heredoc将答案写入指定文件路径并进行验证,从而确保答案文件正确提交,但核心评分逻辑保持不变。

The dataset named nemotron-gym-inverse-ifeval-v2 is a Harbor task binary dataset containing 1,000 tasks, derived from nvidia/Nemotron-RL-InverseIFEval-v1 (part of the nvidia/Nemotron-Post-Training-v3 series). The data is organized in two columns: path (string type, representing the path) and task_binary (gzip tar compressed format, storing task binary data), with the conversion process using the OpenThoughts-Agent data.nemotron_gym framework. The dataset is primarily used for text generation and agent-related tasks, involving reinforcement learning environments, and evaluation employs multi-criteria LLM judgment (all results are YES), requiring OPENAI_API_KEY configuration for operation. Compared to the previous version, this version fixes the answer delivery issue for terminal agents: explicitly instructing agents to write answers to a specified file path via shell heredoc and verifying them, ensuring correct submission of answer files, while the core scoring logic remains unchanged.

提供机构:
LAION eV
创建时间:
2026-06-05
原始信息汇总

数据集概览

  • 数据集名称: laion/nemotron-gym-inverse-ifeval-v2
  • 许可证: Apache-2.0
  • 任务类别: 文本生成
  • 标签: agent, harbor, reinforcement-learning, nemotron

数据集描述

该数据集是从 nvidia/Nemotron-RL-InverseIFEval-v1 转换而来的 Harbor task-binary 数据集,包含 1,000 个任务。它是 nvidia/Nemotron-Post-Training-v3 的一部分。

数据列

  • path(字符串)
  • task_binary(gzip tar 归档文件)

数据转换框架

数据集使用 OpenThoughts-Agent 的 data.nemotron_gym 框架进行转换。

评分方式

采用多标准 LLM 判断(全部为 YES),在试验时需要 OPENAI_API_KEY

版本更新说明(相较于前一版本)

  • 问题修复: 解决了终端智能体的答案交付约定问题。前一版本仅告知智能体要生成什么,但未说明如何提交;导致 1 回合的 terminus-2 智能体将答案以聊天回复形式输出,而未写入指定评分文件,多数试验因“答案文件缺失”得分为 0。
  • 改进措施: 新版本明确指示智能体通过 shell heredoc 方式写入评分器的文件路径(并进行验证),评分逻辑本身未作其他改动。
搜集汇总
数据集介绍
nemotron-gym-inverse-ifeval-v2 数据集图片
构建方式
该数据集源自NVIDIA开发的Nemotron-RL-InverseIFEval-v1,由OpenThoughts-Agent框架下的nemotron_gym数据处理管道转换而成。共包含1,000个二元任务样本,每个样本以路径(path)和二进制任务文件(task_binary)的形式存储于gzip tar压缩包中。构建过程中,重点修复了原始版本中终端智能体未遵循输出提交协议的问题,通过明确要求智能体使用shell heredoc方法将答案写入评分文件并验证,确保任务执行路径的完整性。
使用方法
使用时需将数据集加载为Harbor任务格式,每个样本包含路径及对应的二进制任务文件。在推理阶段,智能体必须依据指令通过shell heredoc将最终答案写入评分系统预设的文件路径,并执行验证操作。评分时需配备OpenAI API密钥以运行多准则大语言模型评估器,所有标准均需标记为‘YES’才算通过。该数据集主要面向基于文本生成的智能体训练与评估场景。
背景与挑战
背景概述
在大型语言模型的后训练对齐阶段,强化学习(RL)已成为提升模型指令遵循能力的关键方法。为此,NVIDIA于2024年发布了Nemotron-RL-InverseIFEval-v1数据集,由NVIDIA研究团队构建,旨在通过反指令遵循任务(Inverse IFEval)为RL训练提供细粒度的二元监督信号。该数据集包含1,000个任务,每个任务要求智能体在终端环境中生成符合特定格式的答案,并由多准则LLM裁判进行严格评测。该数据集作为NVIDIA Nemotron-Post-Training-v3系列的一部分,对探索基于Agent的RL训练范式具有重要影响,推动了模型在复杂指令执行与结果验证方面的能力边界。
当前挑战
该数据集面临的核心挑战在于构建过程中智能体与环境交互的“答案交付协议”缺陷:早期版本仅指明输出内容,却未明确提交方式,导致终端智能体常将答案以对话回复形式输出而非写入指定文件,从而使LLM裁判因“文件缺失”而判定零分。这一设计问题暴露了RL数据构建中指令粒度与执行机制脱节的系统性难题。此外,评测依赖外部API(如OpenAI API)作为裁判模型,增加了评判的可复现性与成本控制难度,同时多准则“全YES”的严格标准也对数据质量与模型泛化性提出了更高要求。
常用场景
经典使用场景
该数据集专为强化学习与智能体推理场景设计,其核心用途在于训练语言模型执行逆指令遵循(inverse instruction following)任务。在逆IFEval框架下,模型需根据给定的输出结果反向推断并生成符合预期的指令,进而通过终端智能体(terminal agent)执行文件写入操作。这种范式突破了传统指令遵循的单向约束,为训练具备逆向推理能力的AI系统提供了标准化评估基准,尤其适用于多轮交互环境中的智能体行为优化。
解决学术问题
在学术研究中,该数据集主要解决了智能体强化学习中'答案交付协议不明确'的难题。原始版本因缺乏明确的输出格式约束,导致终端智能体常以对话框回复替代文件写入操作,造成评估失效。通过引入显式的shell heredoc写入指令与验证机制,该数据集有效消除了指令理解与执行间的沟壑,为构建可复现的智能体决策评估体系奠定了基础,显著提升了逆指令遵循任务的可量化性与置信度。
实际应用
实际应用中,该数据集可直接用于训练具备自动化运维能力的AI智能体,例如在云服务故障排查场景中,智能体需分析日志文件并自动生成修复脚本。企业可通过该数据集微调模型,使其掌握'观察现象→推断根因→执行命令'的端到端工作流,同时确保输出严格遵循目标文件系统的写入规范,避免因沟通歧义导致的操作失败,从而提升运维效率与稳定性。
数据集最近研究
最新研究方向
该数据集聚焦于强化学习与智能体(agent)系统的交叉前沿,特别是针对大语言模型在终端环境中的指令遵循与答案交付契约的优化。其核心改进在于修复了先前版本中智能体因未明确提交机制而导致的评分失效问题,通过引入显式的shell heredoc文件写入指令,显著提升了模型在多步骤任务中的执行准确性与可验证性。这一方向与当前LLM后训练(post-training)中强调的鲁棒性、可控性与环境交互能力紧密相连,反映了从单纯文本生成向闭环任务执行演进的关键趋势。nemotron-gym-inverse-ifeval-v2作为Harbor框架下的测试基准,为评估智能体在严格多准则LLM评判下的表现提供了标准化场景,其技术调整对推动大模型在自动化和代理系统中的实际部署具有重要参考价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

