laion-1m
收藏资源简介:
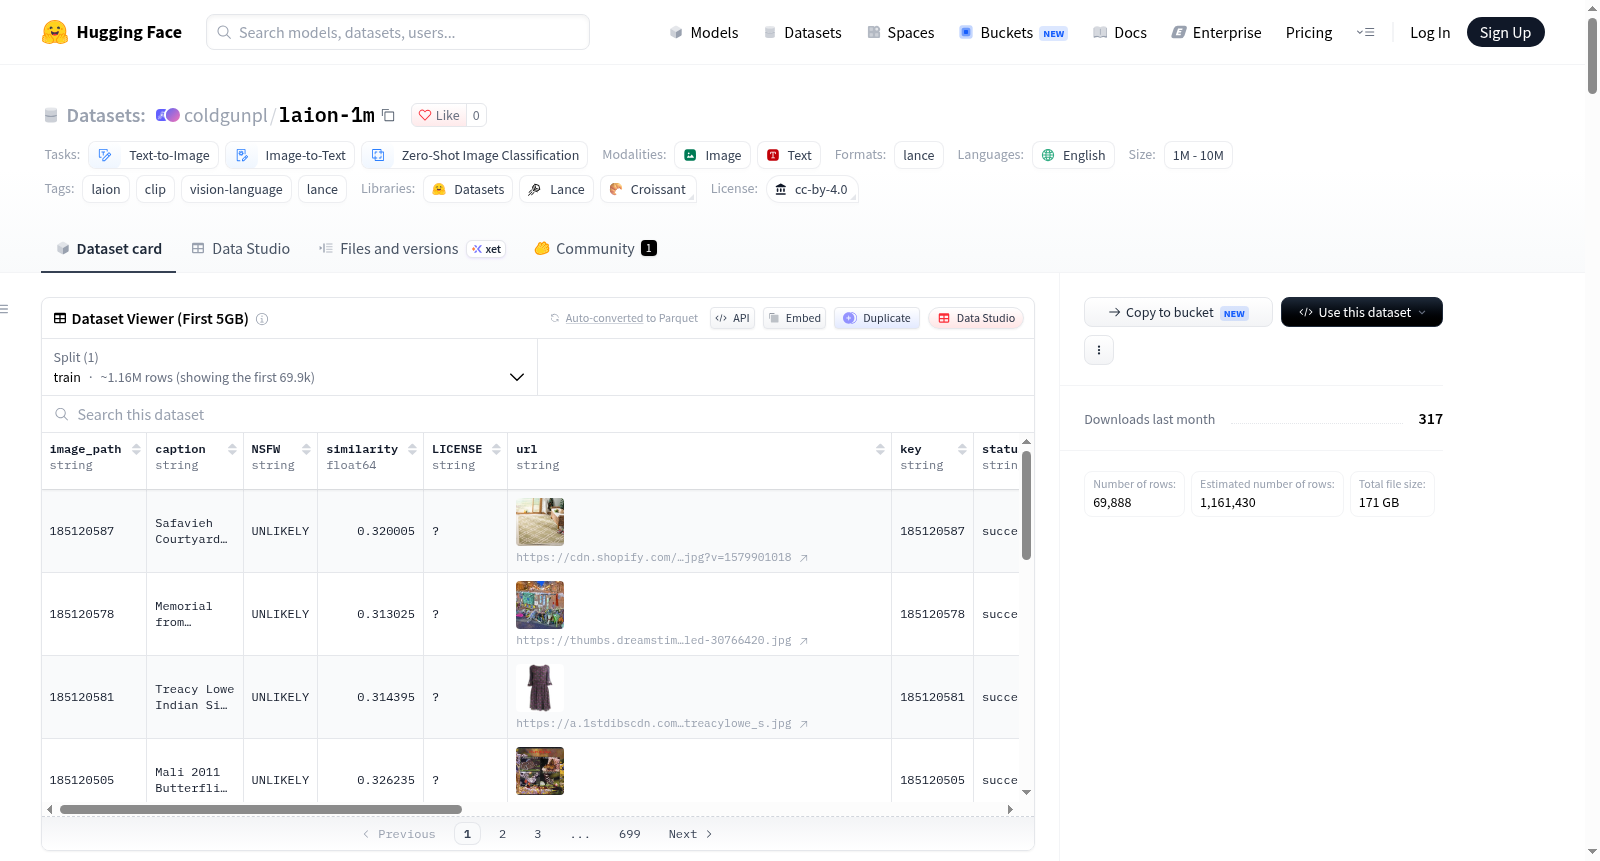
LAION-Subset (Lance Format) 是 LAION-5B 图像-文本语料库的一个子集,包含约100万行数据,采用高效的 Lance 列式存储格式。该数据集以内联 JPEG 字节形式存储图像,并预计算了 CLIP 图像嵌入(768维),同时提供了完整的 LAION 元数据,包括标题、URL、NSFW 标志、相似度分数、图像尺寸、EXIF 信息等。此外,数据集还附带了一个预构建的 IVF_PQ 近似最近邻索引,可用于高效的向量相似性搜索。数据集的列模式包括 key(行键)、image(图像字节)、image_path(原始文件名)、caption(文本描述)、url(来源URL)、NSFW(安全标志)、LICENSE(许可证)、similarity(CLIP 相似度)、width/height(尺寸)、original_width/original_height(原始尺寸)、exif、md5、status、error_message 以及 img_emb(CLIP 嵌入向量)。所有数据存储在单个 train.lance 文件中,支持快速随机访问、多模态存储、数据版本控制和高效的数据演化。该数据集适用于文本到图像、图像到文本、零样本图像分类等任务,可通过 HuggingFace datasets 库、LanceDB 或 Lance 直接加载使用。
LAION-Subset (Lance Format) is a subset of the LAION-5B image-text corpus, containing approximately 1 million rows of data in an efficient Lance columnar storage format. The dataset stores images as inline JPEG bytes and precomputes CLIP image embeddings (768 dimensions), while providing complete LAION metadata including captions, URLs, NSFW flags, similarity scores, image dimensions, EXIF information, etc. Additionally, the dataset comes with a pre-built IVF_PQ approximate nearest neighbor index for efficient vector similarity search. The column schema includes key (row key), image (image bytes), image_path (original filename), caption (text description), url (source URL), NSFW (safety flag), LICENSE, similarity (CLIP similarity), width/height (dimensions), original_width/original_height, exif, md5, status, error_message, and img_emb (CLIP embedding vector). All data is stored in a single train.lance file, supporting fast random access, multimodal storage, data versioning, and efficient data evolution. This dataset is suitable for tasks such as text-to-image, image-to-text, zero-shot image classification, and can be loaded directly using the HuggingFace datasets library, LanceDB, or Lance.
LAION-Subset (Lance格式) 数据集概述
基本信息
- 数据集名称: LAION-Subset (Lance Format)
- 许可证: CC-BY-4.0
- 语言: 英语
- 数据规模: 约100万行 (1M < N < 10M)
- 任务类型: 文本到图像生成、图像到文本生成、零样本图像分类
数据来源与内容
该数据集是 LAION-5B 图像-文本语料库的一个子集,以Lance格式存储,包含约100万条数据记录。数据集中包含内联JPEG图像字节、预计算的CLIP图像嵌入向量(768维)、完整的LAION元数据以及预构建的近似最近邻(ANN)索引。
数据模式(Schema)
| 列名 | 类型 | 说明 |
|---|---|---|
key |
int64 | 行键(用于合并的自然连接键) |
image |
large_binary | 内联JPEG图像字节 |
image_path |
string | 原始文件名 |
caption |
string | 图像描述文本 |
url |
string | 图像来源URL |
NSFW |
int64 | 0=安全,1=不适宜内容 |
LICENSE |
string | 每行许可标签 |
similarity |
float64 | CLIP图像-文本余弦相似度 |
width, height |
int64 | 图像尺寸 |
original_width, original_height |
int64 | 调整前的原始尺寸 |
exif, md5, status, error_message |
string | 来源/元数据信息 |
img_emb |
fixed_size_list<float32, 768> | CLIP图像嵌入向量 |
关键特性
- 内联JPEG字节: 图像直接存储在
image列中,无需辅助文件或图像文件夹 - 预计算CLIP嵌入: 提供768维图像嵌入向量,附带
IVF_PQ索引用于相似性搜索 - 完整元数据: 包含描述文本、URL、NSFW标记、EXIF、尺寸、相似度分数等
- 单一列式数据集: 可低成本扫描元数据,仅按需获取所需行的图像字节
技术优势(Lance格式)
- 快速随机访问: 优化分散行的读取,适合随机采样和实时ML服务
- 原生多模态支持: 文本、嵌入和其他数据类型可共存于同一文件,大二进制对象延迟加载
- 原生索引支持: 磁盘上的快速向量索引和全文搜索索引与数据集共存
- 高效数据演进: 添加新列或回填数据无需重写整个数据集
- 灵活查询: 支持向量相似性搜索、全文搜索和SQL风格过滤的单一查询组合
- 数据版本控制: 每次变更提交新版本,旧版本保留在磁盘上
使用方式
通过HuggingFace datasets加载
python import datasets hf_ds = datasets.load_dataset("lance-format/laion-1m", split="train", streaming=True)
通过LanceDB加载
python import lancedb db = lancedb.connect("hf://datasets/lance-format/laion-1m/data") tbl = db.open_table("train")
通过Lance直接加载
python import lance ds = lance.dataset("hf://datasets/lance-format/laion-1m/data/train.lance")
功能示例
- 搜索: 使用内置IVF_PQ索引进行近似最近邻搜索
- 数据筛选: 结合相似度与元数据过滤(如NSFW=0、宽度≥512)构建定制子集
- 数据演进: 添加新列(如宽高比、高分辨率标志)或合并外部标签数据
- 训练数据加载: 通过列投影和PyTorch DataLoader集成为训练管道
- 版本管理: 支持版本历史查看、标签创建和按版本/标签打开数据集
引用与许可
- 引用论文: LAION-5B: An open large-scale dataset for training next generation image-text models,发表于NeurIPS Datasets and Benchmarks Track (2022)
- 许可说明: 内容继承LAION原始许可和安全指南,下游使用前需查阅 LAION政策