
遇见数据集

gszauer/Clue250K

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

该数据集名为Clue 250K合成语料库,是一个用于训练和测试小型Clue 250K语言模型的合成短篇谋杀谜题集合。数据集中包含固定的人名、地点、武器和伤口描述,每个谜题要求模型根据线索推断凶手,或在线索无法唯一确认时回答Unknown。数据集结构为.txt文件,包含多种示例类型,如地点谜题(通过尸体位置识别凶手)、武器谜题(通过伤口匹配武器识别凶手)和不可解谜题(无有效匹配或模糊匹配)。数据集规模包括3,164,051个示例,总文本大小524,288,508字节(500.0 MiB),分为318个分片。数据集还包含多种结尾风格(如Therefore the murderer is:等),以提高模型泛化能力。该数据集专为教育性语言模型实验设计,针对小型Transformer模型(如词汇量512、上下文长度96),不适用于通用推理基准测试。数据高度模板化,包含重复结构模式,以适应小型模型需求。

This dataset is the Clue 250K Synthetic Corpus, containing synthetic short murder mysteries for training and testing the tiny Clue 250K language model. The examples use a fixed set of names, locations, weapons, and wound descriptions. Each mystery asks the model to infer the murderer, or answer Unknown when the clues do not identify exactly one person. The dataset structure includes .txt files with multiple example types, such as location mysteries (where the body location identifies the murderer), weapon mysteries (where the wound matches a weapon to identify the murderer), and unsolvable mysteries (with no valid or ambiguous matches). The dataset size totals 3,164,051 examples, with a text size of 524,288,508 bytes (500.0 MiB) across 318 shards. It also features varied ending styles (e.g., Therefore the murderer is:) to prevent overfitting. Intended for educational language-model experiments, it targets very small decoder-only transformers (e.g., vocabulary size 512, context length 96) and is not a benchmark for general reasoning. The data is highly templated with repeated structural patterns for small model compatibility.
提供机构:
gszauer
搜集汇总
数据集介绍
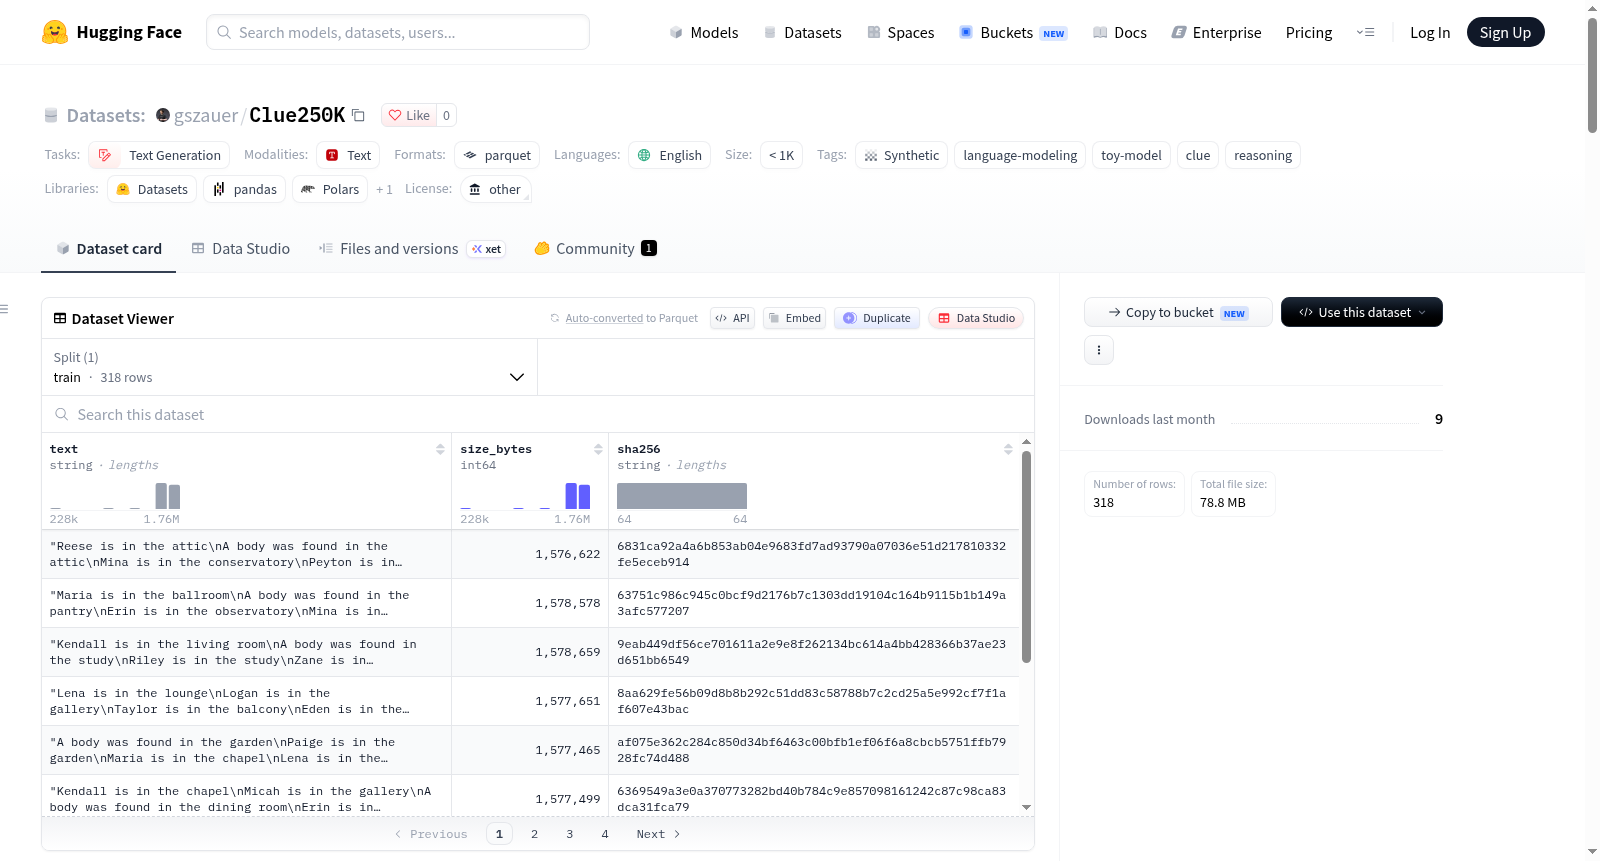
gszauer/Clue250K 数据集图片
构建方式
在合成语料构建领域,面向微型语言模型训练的数据集合成通常依赖模板生成以控制分布。Clue250K语料库的构建遵循这一范式,通过预设有限集合的名称、地点、武器和伤口描述,系统化生成短篇谋杀谜题。每个谜题以固定结构呈现,要求模型推断凶手,或在线索不足以唯一识别时输出“Unknown”。生成过程覆盖地点型、武器型及无解型谜题,并引入多种结尾表述变体,以增强模型对最终行前缀的泛化能力。整体语料以纯文本分片存储,每个.txt文件以空行分隔多个示例,无需JSON或CSV元数据。
特点
该数据集的核心特征在于其高度模板化与受控的词汇空间。语料包含约316万条示例,总文本量约500 MiB,分为318个文本分片。谜题类型涵盖地点推理、武器推理及不可解情形,其中三嫌疑人示例约占25%,四嫌疑人示例约占75%。所有示例共享固定名称、地点、武器和伤口映射,并采用多种结尾句式,如“Therefore the murderer is:”占70%,其余变体占30%。这种设计旨在过拟合极小规模的解码器模型,而非作为通用推理基准,凸显其教育实验导向。
使用方法
使用该数据集时,研究者可直接读取纯文本文件,每个示例以空行分隔,末尾的“FIN.”为字面文本而非特殊标记。数据适用于训练和测试微型解码器语言模型,参考模型配置为词汇量512、上下文长度96、3个块、特征维度72,参数量约23万。训练可采用字节级BPE分词器,参考训练运行4个周期,总标记呈现量约9.6亿。该语料库亦可作为教学实验素材,用于探究小模型在受限模板下的推理行为,但不宜作为通用推理能力的评估标准。
背景与挑战
背景概述
在语言模型日益庞大的时代,探索超小规模模型在受限任务上的推理能力成为一项有趣课题。Clue250K数据集由Greg Szauer等人于近年构建,旨在为仅约23万参数的微型解码器模型提供充足的训练语料。该数据集通过合成大量谋杀谜题,要求模型从人物位置或凶器线索中推断凶手,无法唯一确定时则输出Unknown,核心研究问题在于检验极小模型能否在高度模板化的逻辑推理任务中习得模式。其影响力主要服务于教育实验与玩具模型开发,未作为通用推理基准。
当前挑战
该数据集所解决的领域问题是受限文本推理,即从结构化线索中推断唯一答案,其挑战在于模型需精准区分可解与不可解情形,避免过度依赖表面共现。构建过程中的挑战包括:生成数百万条示例时确保无歧义,平衡三嫌犯与四嫌犯样本比例,覆盖多种结局表述以降低模板偏见,同时维持数据集全部由固定名称、地点、武器和伤口描述构成,导致高度重复且缺乏自然语言多样性,可能限制模型泛化能力。
常用场景
经典使用场景
在微型语言模型的教育实验与推理能力评估领域,Clue250K数据集最经典的使用场景在于训练和测试体量极小的仅解码器变换器模型,通过高度模板化的短篇谋杀谜题,促使模型从给定的房间位置或武器伤口线索中推断出唯一凶手,或在不唯一时输出Unknown。该数据集以纯文本形式组织,每行陈述一个事实,末尾以固定结束符FIN.收束,使模型能够聚焦于封闭集合内的逻辑推理,成为探究参数量与推理表现关系的理想试验台。
实际应用
在实际应用层面,Clue250K主要服务于教学演示与轻量级推理原型的快速验证。其配套的网页演示和训练参考模型使研究者与学生能够直观观察最小变换器如何完成多步逻辑推断,并测试不同模板与结尾变体对模型稳定性的影响。此外,该语料可用于生成可控的合成推理数据,为受限环境下的模型压缩、课程学习设计以及Token效率分析提供可复现的基准素材,但不宜作为通用推理能力的评测标准。
衍生相关工作
基于Clue250K语料,相关经典工作集中在微型模型过训练与合成推理基准的交叉领域。代表性成果包括配套训练的小型解码器模型Clue250K,其参数仅约23万、词汇表512、上下文长度96,在四个轮次内完成了近十亿Token的呈现。围绕该数据集,研究者进一步探索了字节级BPE分词、极短上下文下的线索聚合以及模板多样性对消除表面启发式的作用,并催生了以封闭世界假设为基础的玩具推理任务系列,为后续合成逻辑语料的构建提供了范式参考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

