
stefanocarrera/autophagycode_D_mercury_Qwen3-8B_lr0.0001_c142_trust_t0.75_g2_run1
收藏数据链接:
官方服务:
资源简介:
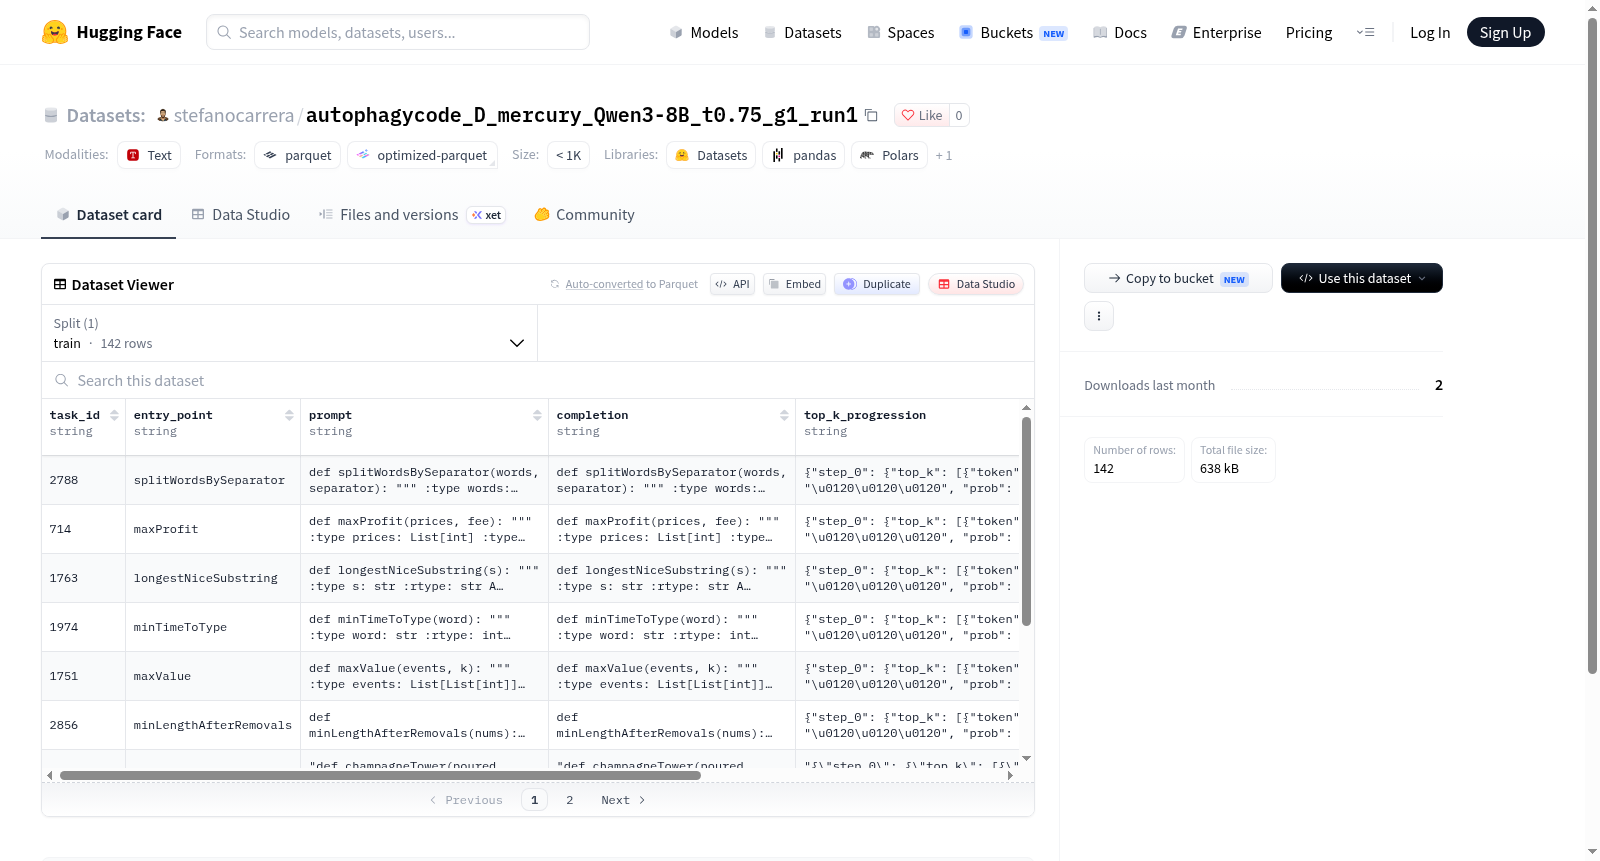
该数据集包含142个训练样本,每个样本由任务ID、入口点、提示、完成、top_k进展和测试字段组成,具体用途未说明。
The dataset contains 142 training samples, each consisting of task_id, entry_point, prompt, completion, top_k_progression, and test fields, with the specific purpose not described.
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集源于针对代码生成任务的专项优化流程。以Qwen3-8B基座模型为起点,采用学习率0.0001、信任温度0.75及组规模2的配置,通过自噬式迭代策略对汞元素相关代码任务进行微调,最终产出142条训练样本。构建过程整合了任务标识、入口点、提示与补全对,并记录top-k渐进信息及测试用例,每条样本均经过质量筛选,以保障代码逻辑与任务描述之间的语义一致性,从而形成结构化的微调数据集合。
特点
数据集以代码任务为核心,涵盖任务标识、入口点、提示、补全、top-k渐进及测试六个字段,兼顾生成轨迹与验证信息。数据规模为142条,体积约4.2MB,适用于小样本精细调优场景。每条样本附带渐进式top-k记录,能够反映生成过程中的候选演化,为分析模型行为提供额外维度。字段设计紧凑,既包含自然语言提示,又保留可执行测试,便于衡量代码的功能正确性。
使用方法
该数据集以默认配置加载,可直接用于代码生成模型的监督微调或评估。使用时通过datasets库读取train划分,将prompt作为输入、completion作为目标,并可借助test字段执行单元测试验证生成代码。top_k_progression可用于分析生成多样性或设计课程学习策略。训练时建议依据entry_point和task_id组织实验,监控验证指标,避免过拟合。
背景与挑战
背景概述
近年来,代码生成模型在软件工程与人工智能交叉领域迅速崛起,其评估与优化依赖于高质量的程序合成数据集。autophagycode_D_mercury_Qwen3-8B_lr0.0001_c142_trust_t0.75_g2_run1数据集于2025年由匿名研究团队构建,基于Qwen3-8B模型在特定超参数下生成,包含142个训练样本,涵盖任务标识、函数入口、自然语言提示、补全代码、top-k渐进信息及测试用例。该数据集聚焦于代码生成模型在自我修复与迭代优化过程中的行为分析,为研究模型对代码正确性的自动评估与修正能力提供了细粒度实验平台,对程序合成与自动化调试领域具有潜在推动作用。
当前挑战
该数据集所应对的领域问题在于代码生成模型在开放场景下输出正确且鲁棒的程序,其核心挑战包括:模型需在缺乏显式监督下自主识别并修复代码逻辑错误,同时保持语义一致性;构建过程中,依赖单一模型生成的数据可能引入偏差与噪声,且样本量有限(仅142例),难以覆盖多样化的编程任务与边界条件。此外,top-k渐进信息的引入虽有助于分析模型置信度演化,但如何量化其与最终代码质量的关系仍面临方法学挑战。
常用场景
经典使用场景
在程序合成与自动化代码生成的学术探索中,该数据集通常被视作评估模型在复杂代码逻辑推理任务上的基准资源。其最为经典的使用场景在于:研究者利用task_id与entry_point对编程题目进行唯一标识,进而引导模型依据prompt中的自然语言描述生成相应的completion代码,同时借助test字段提供的测试用例对生成结果进行自动化验证与筛选。这一过程往往与top_k_progression所记录的采样轨迹相结合,用以剖析模型在多次尝试中的收敛行为与候选代码的演化路径,从而为代码生成模型的性能诊断提供细粒度依据。
解决学术问题
该数据集所应对的核心学术问题,在于如何量化评估代码生成模型在受限样本规模下的泛化能力与逻辑推理深度。通过提供142条带有完整单元测试的编程任务,它有效缓解了代码生成研究中高质量评测资源稀缺的困境,使得研究者能够在一个可复现的框架下,系统考察模型对问题语义的理解、对边界条件的处理以及对算法结构的把握。其test字段构成的验证闭环,尤为有助于揭示模型在表面正确性与深层逻辑一致性之间的落差,为代码智能领域的可解释性研究提供了实证基础。
衍生相关工作
围绕该数据集,后续研究衍生出一系列与代码生成评估方法学相关的工作,包括对生成代码进行静态分析与动态执行的混合验证策略,以及基于多次采样轨迹的置信度估计与候选排序机制。部分工作进一步将其与执行反馈相结合,探索迭代式代码精炼框架,利用test的执行结果指导模型进行自我修正。此外,亦有研究以此为基准,比较不同解码策略对代码正确率的影响,或将其纳入更广泛的跨语言代码生成评测体系,推动了代码智能领域基准建设的持续演进。
以上内容由遇见数据集搜集并总结生成


