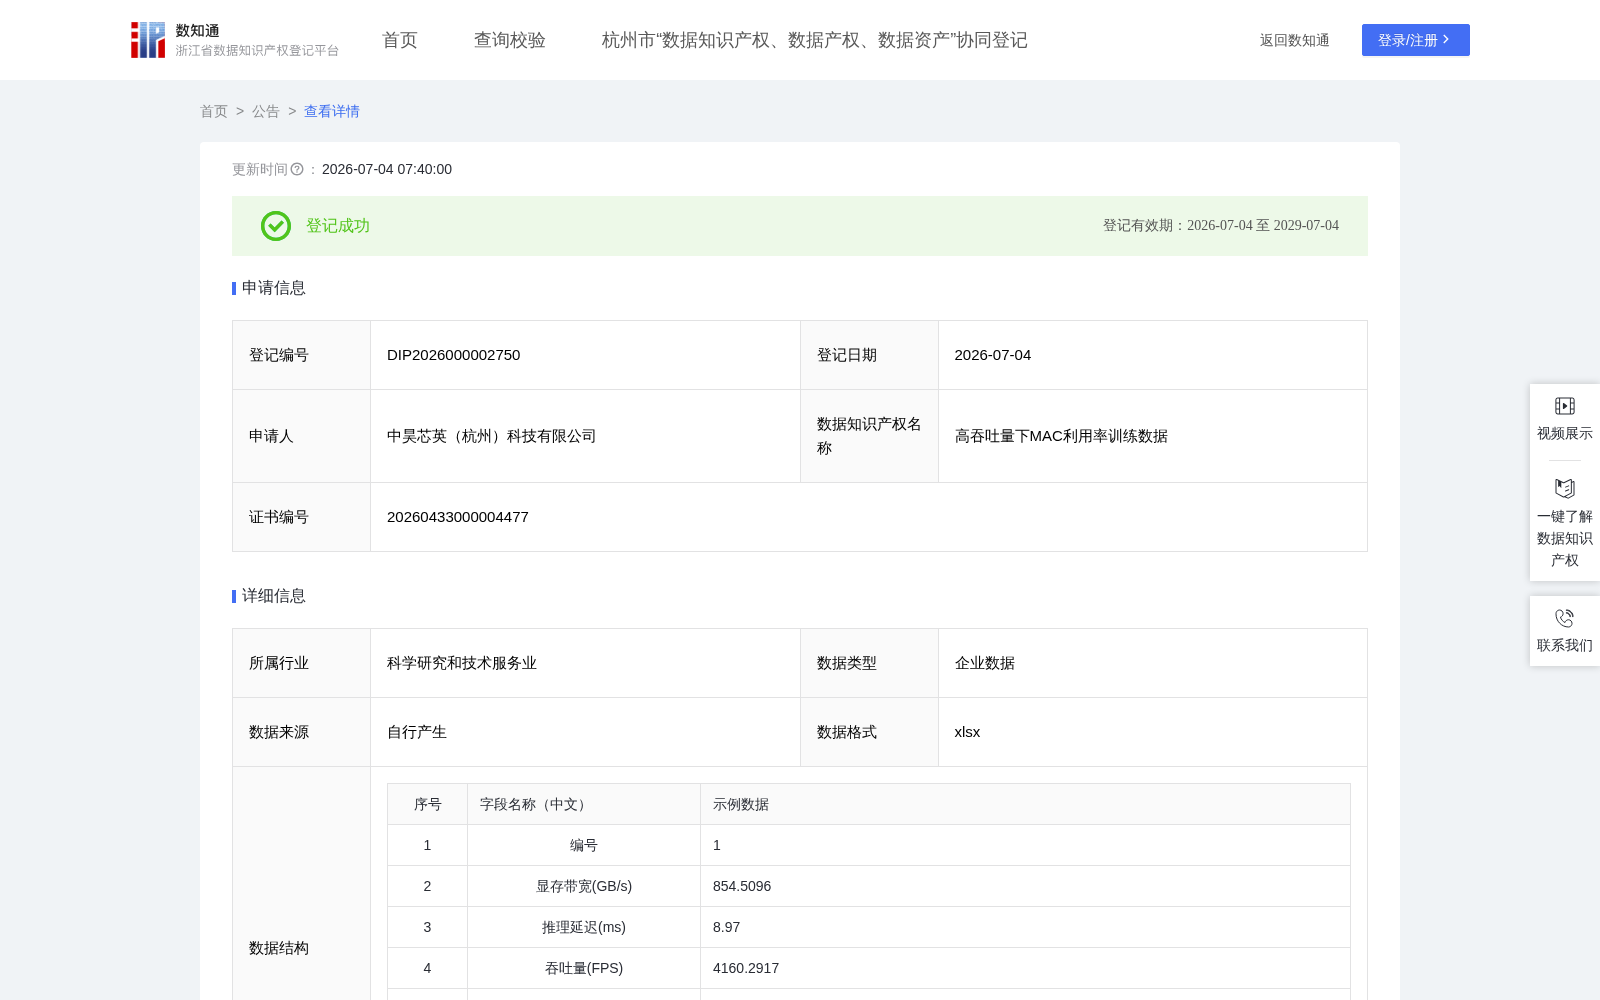
高吞吐量下MAC利用率训练数据
收藏资源简介:
本数据集包含数千条AI推理硬件在高吞吐量(>4000FPS)工况下的性能监控数据,经筛选、清洗及特征工程,新生成带宽吞吐积特征,以MAC利用率作为回归预测目标。数据按8:1:1划分为训练集、验证集和测试集,可直接用于监督学习模型训练。对外部企业而言,本数据可用于训练高吞吐场景下的计算单元利用率预测模型,帮助视频处理、批量推理、云端AI服务等高并发企业,在高压力下预估硬件资源利用程度,指导任务分发和动态扩缩容,避免过载或资源浪费。此外,本数据集可为机器学习模型提供高质量训练数据,用于训练利用率异常检测模型、高吞吐调度策略模型等,具有重要的行业应用价值。独立性:本数据集通过明确的筛选条件(吞吐量>4000FPS,不含端点)、独立新生成特征计算及随机划分,形成自包含的训练数据。必要性:原始数据包含大量低吞吐样本(<2000FPS),这些样本中MAC利用率受任务调度和空闲开销影响大,与高吞吐场景(计算单元接近饱和)规律不同。企业若直接使用全量数据,对高吞吐下的利用率预测容易产生偏差。本数据集聚焦高吞吐区间,是高并发AI推理硬件利用率建模任务的基础。1.加工前的数据说明 原始数据为AI推理硬件运行状态监控日志,以表格形式存储,每行代表一个采样时刻,按编号顺序排列。总样本量达数千行,所有字段均为数值型且无缺失值。原始数据包含MAC利用率(%)、显存带宽(GB/s)、推理延迟(ms)、吞吐量(FPS)、动态功耗(W)、漏电功耗(W)、能效比(TOPS/W)共7个字段。 2.处理规则 首先,从原始数据中筛选出吞吐量>4000FPS的记录,构成高吞吐子集。对该子集进行质量检查,剔除超出物理合理范围的记录,并删除所有字段完全相同的重复记录。其次,基于原始字段新生成一个自变量字段:带宽吞吐积=显存带宽×吞吐量。因变量为MAC利用率。之后,对全部自变量进行Z-score标准化。最后,将处理后的全部数据按8:1:1比例随机划分为训练集、验证集和测试集。基于随机森林回归算法构建MAC利用率预测模型,以6个原始自变量和1个新生成自变量(带宽吞吐积)共7个输入,MAC利用率为输出。通过网格搜索优化超参数,特征重要性分析表明带宽吞吐积和推理延迟是影响高吞吐下MAC利用率的关键因素。模型在测试集上达到R²>0.93的良好精度,验证了本数据集的有效性。 3.数据内容描述 最终产出数据集包含7个自变量、1个因变量(MAC利用率)。所有数据均来自吞吐量>4000FPS的真实高吞吐运行环境(不含边界)。该数据集结构清晰、指标完整,可直接用于训练AI推理硬件在高吞吐量工况下的MAC利用率回归预测模型。