
openeurollm/EU-Instruct-Synthetic
收藏官方服务:
资源简介:
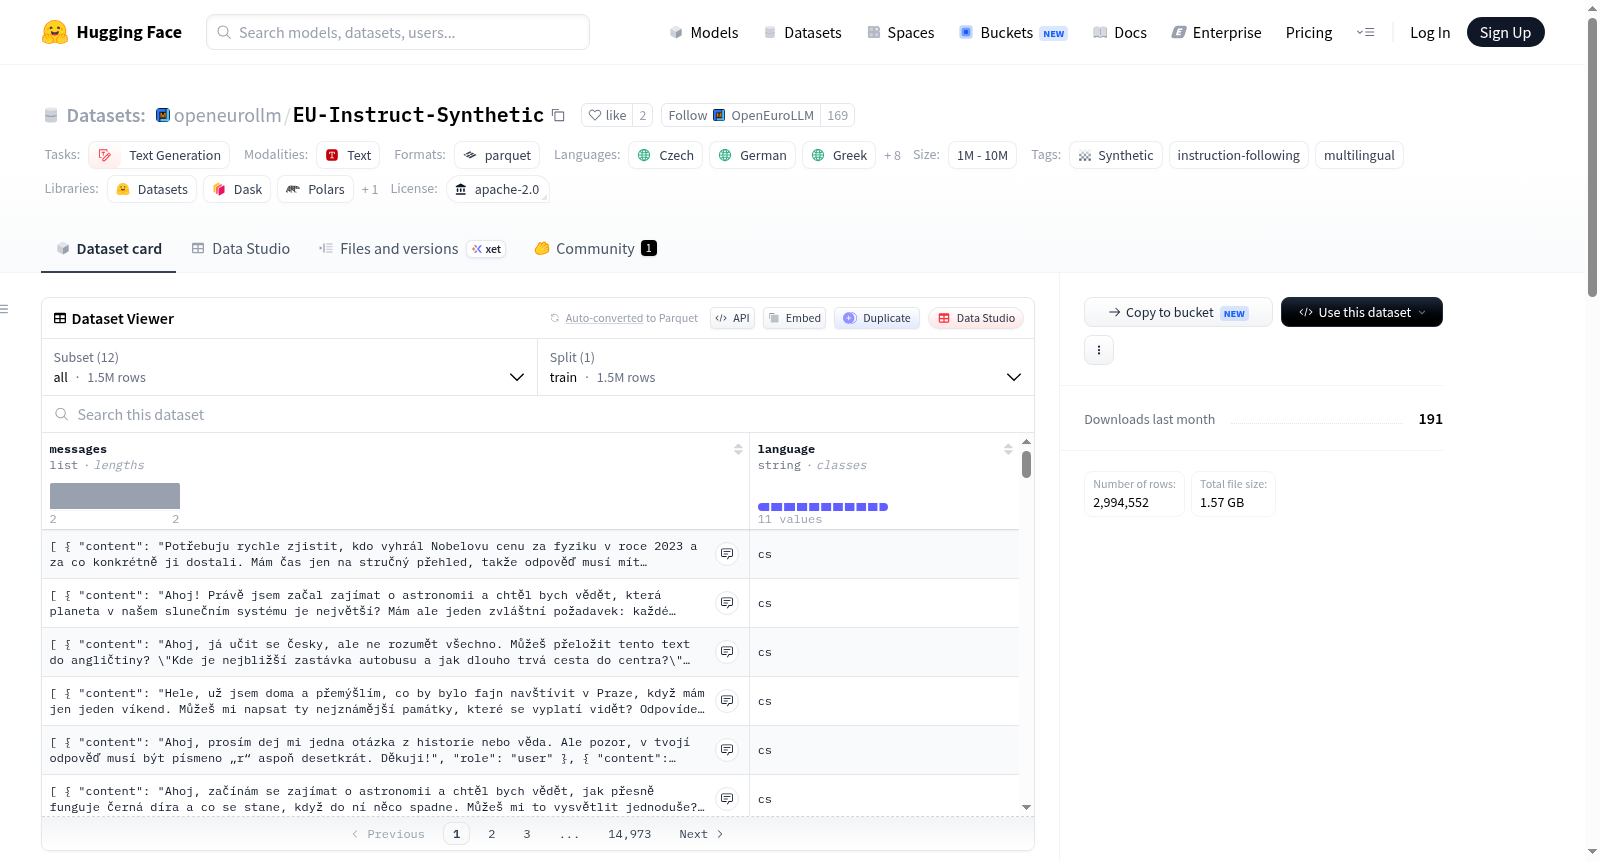
EU Instruct Synthetic是一个合成生成的指令跟随SFT数据集,涵盖11种欧洲语言(包括捷克语、德语、希腊语、西班牙语、法语、意大利语、荷兰语、波兰语、葡萄牙语、罗马尼亚语和乌克兰语)。每个示例是一个单轮聊天对话,包含用户指令和助手回复(以messages字段表示),并附带一个language字段标识语言。该数据集是openeurollm/Dolci-Instruct-SFT-translated的合成对应版本,总共有约1,497,276个示例,通过synthgen-if合成指令跟随管道生成。
EU Instruct Synthetic is synthetically generated instruction-following SFT data for 11 European languages. Each example is a single-turn chat (with messages: a user instruction and an assistant response) and includes a language field. This is the synthetic counterpart to openeurollm/Dolci-Instruct-SFT-translated.
提供机构:
openeurollm搜集汇总
数据集介绍
构建方式
EU-Instruct-Synthetic数据集是借助合成指令遵循管道(synthgen-if)构建而成,作为openeurollm/Dolci-Instruct-SFT-translated数据集的合成对应版本,涵盖了捷克语、德语、希腊语、西班牙语、法语、意大利语、荷兰语、波兰语、葡萄牙语、罗马尼亚语及乌克兰语共11种欧洲语言。每条样本均呈现为单轮对话格式,包含用户指令与助手响应,并附带语言标识字段,确保了数据在语种上的规范性与可区分性。
使用方法
数据集可通过HuggingFace的datasets库便捷加载,支持按单一语言访问,如load_dataset("openeurollm/EU-Instruct-Synthetic", "cs")以捷克语为例,亦可通过默认配置一次性获取全部语种,即load_dataset("openeurollm/EU-Instruct-Synthetic")。数据以JSON格式组织,每条记录包含messages字段(存储用户与助手的对话内容)和language字段(标明语种),便于与标准训练流程无缝整合。
背景与挑战
背景概述
随着大规模语言模型(LLMs)在自然语言处理领域的广泛应用,获取高质量、多语言的指令遵循(instruction-following)数据成为提升模型跨语言泛化能力的关键。然而,现有数据集多集中于英语,严重制约了非英语语言模型的发展。在此背景下,由OpenEuroLLM团队于2024年发布的多语言合成指令数据集——EU-Instruct-Synthetic应运而生。该数据集覆盖捷克语、德语、希腊语、西班牙语等11种欧洲语言,共计约150万条单轮对话样本,通过synthgen-if合成管道生成,旨在为多语言SFT(监督微调)提供高质量训练资源。作为Dolci-Instruct-SFT-translated的合成对应版本,它有效弥补了欧洲低资源语言指令数据的匮乏,对推动多语言LLMs的公平性与包容性研究具有重要价值。
当前挑战
该数据集所解决的领域挑战主要包括:其一,非英语语言指令数据稀缺,尤其在捷克语、希腊语、乌克兰语等语言中,高质量人工标注数据难以获取且成本高昂;其二,现有跨语言模型在指令遵循任务上表现不佳,亟需大规模、多样化的多语言数据以提升泛化能力。在构建过程中,亦面临多重挑战:合成数据生成需确保指令的真实性与多样性,避免语义偏差和重复模式;覆盖11种语言意味着需处理不同语系的语法结构、文化语境及表达习惯差异;此外,自动生成的数据质量验证机制尚不完善,需人工精细校验以保证助理响应的准确性与自然度。这些挑战要求构建者兼顾生成效率与数据生态的真实性平衡。
常用场景
经典使用场景
在自然语言处理与多语言人工智能研究领域,指令遵循(instruction-following)能力是衡量大型语言模型性能的核心维度之一。EU-Instruct-Synthetic数据集作为专为11种欧洲语言设计的合成指令微调资源,其最经典的用途在于支持跨语言监督式微调(Supervised Fine-Tuning, SFT)。研究人员可以将该数据集中生成的单轮对话样本——涵盖用户指令与助手回应——直接用于训练和优化模型的多语言对齐能力,使其在捷克语、德语、希腊语、西班牙语、法语、意大利语、荷兰语、波兰语、葡萄牙语、罗马尼亚语及乌克兰语环境中,都能精准理解并遵循人类的复杂指令,从而显著提升模型在非英语语言场景下的响应质量。
解决学术问题
长期以来,学术界在多语言指令微调领域面临着一项关键挑战:高质量、大规模且覆盖多种语言的指令数据极为匮乏,尤其是欧洲非英语语言的资源更为稀缺。EU-Instruct-Synthetic数据集的出现有效缓解了这一困境,它通过合成生成技术,系统性地创建了一个包含近150万条样本的指令微调语料库,为研究者提供了统一且可复用的多语言训练基准。这解决了跨语言模型在指令理解上存在的性能偏差问题,使得不同语言背景下的模型能力得以均衡发展,推动了多语言人工智能系统在公平性与泛化性方面的学术探索。
实际应用
在实际应用层面,EU-Instruct-Synthetic数据集为欧洲多语言智能助手的开发提供了坚实的数据基础。企业或研究机构可借助该数据集微调大型语言模型,从而构建出能够无缝支持捷克、德国、法国、西班牙等国家官方语言的客服系统、智能文档处理工具或跨语言知识问答平台。该资源尤其适用于需要覆盖欧盟多元语言环境的商业场景,例如多语种聊天机器人、本地化内容生成系统以及面向不同国家用户的个性化推荐引擎,有效降低了从零收集和标注多语言指令数据的成本与复杂度。
数据集最近研究
最新研究方向
EU-Instruct-Synthetic数据集聚焦于多语言指令微调的前沿探索,通过合成方法为11种欧洲语言生成高质量的单轮对话数据,旨在弥补非英语语言在指令遵循任务中的资源匮乏。该数据集是OpenEuroLLM项目的重要组成部分,与当前大语言模型多语言能力提升的热点紧密相连,尤其关注低资源语言(如乌克兰语、罗马尼亚语)的覆盖,推动了模型在跨语言场景下的泛化表现。其影响在于为多语言SFT研究提供了可复现的基准,促进了欧洲语言AI生态的均衡发展,同时合成数据的低成本优势为大规模多语言数据集构建开辟了新路径,对缩小语言数字鸿沟具有深远意义。
以上内容由遇见数据集搜集并总结生成


