
M3-SLU/M3-SLU-Task2
收藏官方服务:
资源简介:
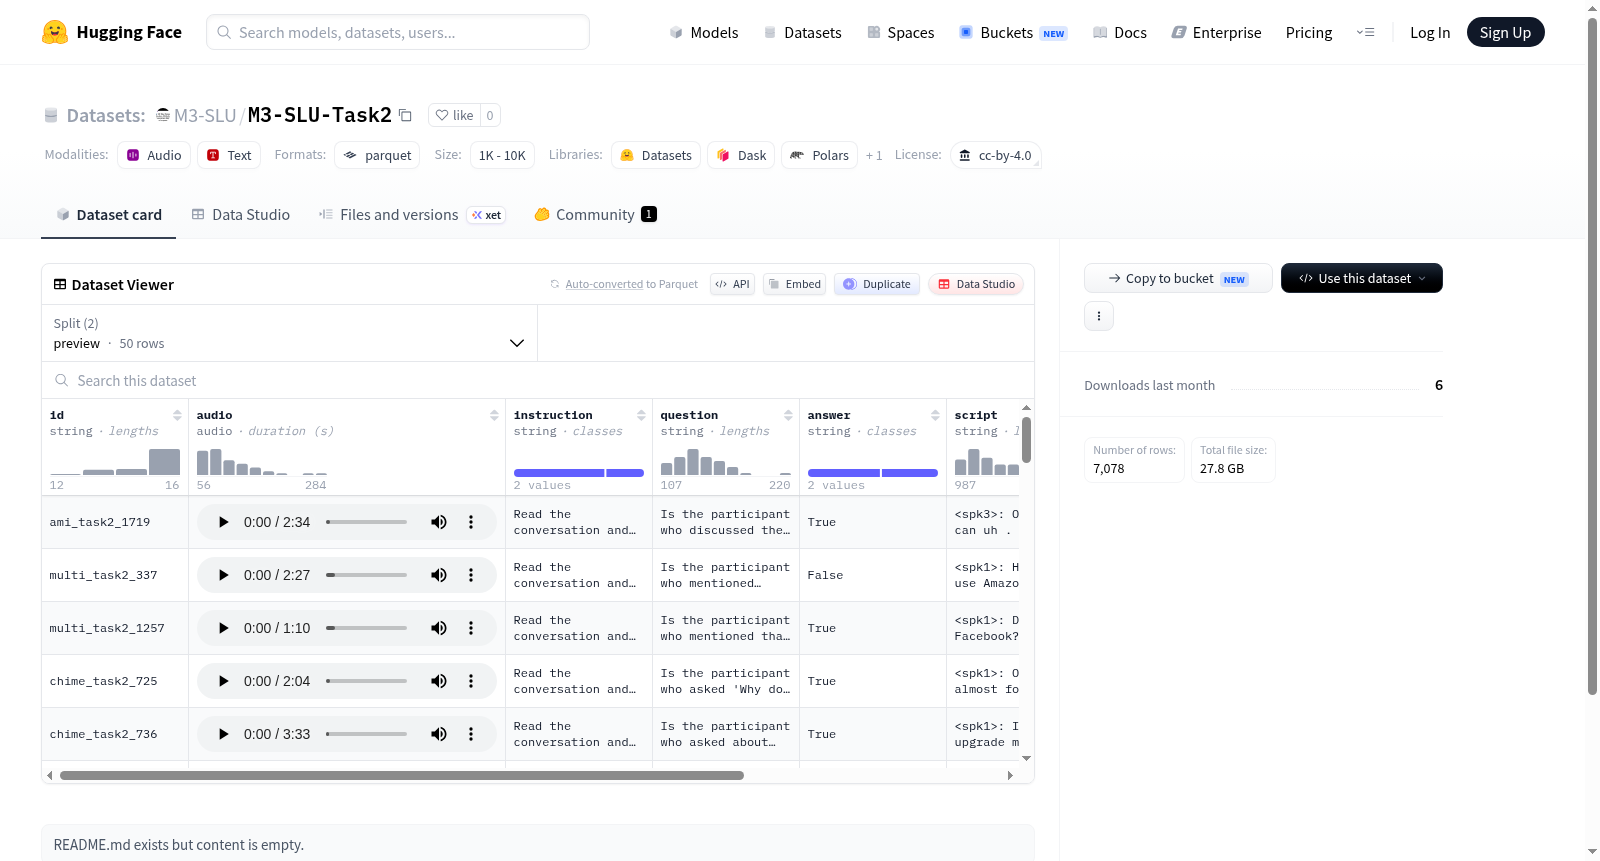
该数据集包含音频、指令、问题、答案、脚本、说话人数和数据来源,是一个多说话人音频问答数据集,用于训练模型理解音频指令并生成回答。
This dataset contains audio, instruction, question, answer, script, number of speakers, and data source. It is a multi-speaker audio question-answering dataset designed for training models to understand audio instructions and generate responses.
提供机构:
M3-SLU搜集汇总
数据集介绍
构建方式
M3-SLU-Task2数据集的构建立足于口语理解领域对多模态、多说话人场景的迫切需求,通过采集真实对话环境中的音频数据,并辅以精细化的标注流程完成。每个样本包含唯一标识符、原始音频文件、结构化指令、提问与标准答案,以及对应的文本脚本。数据来源涵盖多种场景,同时记录了说话人数量,以增强对复杂声学环境的覆盖。数据集划分为preview和sample两个子集,其中sample集包含7028个样本,为模型训练与评估提供了充足素材。
特点
该数据集的核心特点在于其多维度信息融合的设计。音频、文本指令与答案三重模态的结合,使得模型能够学习从语音到语义的端到端映射。特别地,数据集中保留了说话人数量的元数据,为多说话人场景下的鲁棒性研究提供了支撑。此外,数据来源的多样性确保了覆盖领域的广泛性,而标准的CC-BY-4.0许可则有助于推动学术社区的开源合作与复现。
使用方法
数据集的使用通过Hugging Face Datasets库便捷调用,用户可基于config名'default'加载preview或sample分片。每个样本以字典形式返回,包含'audio'字段(采用非即时解码的音频格式以节省内存)和文本字段。典型应用流程包括:首先利用音频特征提取模块(如Wav2Vec2)将语音编码,随后结合'instruction'与'question'字段构建提示(prompt),指导模型生成'answer'。适用于语音对话系统、任务型口语理解等领域的训练与基准测试。
背景与挑战
背景概述
M3-SLU-Task2数据集诞生于多模态与多语言语音理解研究蓬勃发展的背景下,由相关研究机构为探索多说话人、多语言及多任务联合处理而构建。该数据集以语音为核心,融合了音频、指令、问答及脚本等多维信息,旨在推动语音理解系统在复杂交互场景中的性能提升。其核心研究问题聚焦于如何利用多任务学习范式,实现从原始语音信号到结构化语义信息的精准映射。自发布以来,该数据集为多模态语音理解领域提供了宝贵的基准资源,促进了端到端模型在处理多说话人对话、跨语言任务迁移等方面的研究,对推动人机交互技术的智能化发展具有重要影响。
当前挑战
该数据集所解决的领域问题在于,传统语音理解系统通常局限于单语言、单任务或单说话人场景,难以应对真实世界中多说话人交织、语言混杂且任务多样的复杂对话环境。M3-SLU-Task2通过整合多种任务指令与跨语言数据,挑战了模型在多维约束下进行语义推理的能力。在构建过程中,面临的核心挑战包括:多语言语音数据的对齐与标注一致性维护,确保不同语言间语义等价;多说话人场景下声学特征的分离与识别精度控制,避免说话人重叠带来的混淆;以及复杂指令与问答对的设计,需兼顾任务多样性与语境的自然性,以避免引入人工偏误。
常用场景
经典使用场景
M3-SLU-Task2数据集专为多模态、多说话人、多语种口语理解任务而设计,其核心应用场景涉及语音与文本跨模态联合建模。典范性的用途包括构建基于用户指令的复杂对话系统,其中模型需同时解析音频信号中的声学特征、说话人身份信息以及自然语言语义。研究者常利用该数据集的'sample'和'preview'划分,在包含70余万条样本的大规模语料上进行监督学习,通过'instruction'与'question'字段组合的提示范式,驱动模型从混合语音场景中提取结构化答案,这显著推动了端到端口语理解范式的发展。
实际应用
在实际产业环境中,M3-SLU-Task2数据集可直接赋能智能会议室系统、车载多模态助手以及无障碍交互设备。例如,在多人会议场景中,系统需基于一段包含多个提问与回答的录音,自动识别特定发言人的意图并生成响应摘要。该数据集提供的'audio'与'script'配对信息使得开发人员能够训练出对说话人切换具有鲁棒性的语音接口,降低环境噪声和声纹混淆引发的误识率。此外,其灵活的数据格式兼容主流语音-文本联合模型,为开发面向多语种用户的全球化部署方案铺平了道路。
衍生相关工作
自M3-SLU-Task2发布以来,其样本构成与任务定义已衍生出多项开创性工作。一方面,研究者基于其'multi-stage'的问答逻辑开发了分层注意力机制的解码器,实现了对重叠语音中关键指令的动态筛选;另一方面,该数据集被用于评估大规模预训练模型在少样本口语理解上的迁移能力,如Whisper与SLAM系列模型的微调实验均引用其作为基准。更深远的影响体现在对话系统评测体系的重构上——若干后续工作以M3-SLU-Task2的'n_speakers'和'data_source'为锚点,提出了融合说话人嵌入的多粒度评估指标,推动口语理解从孤立话语分析迈向群体交互建模的新阶段。
以上内容由遇见数据集搜集并总结生成


