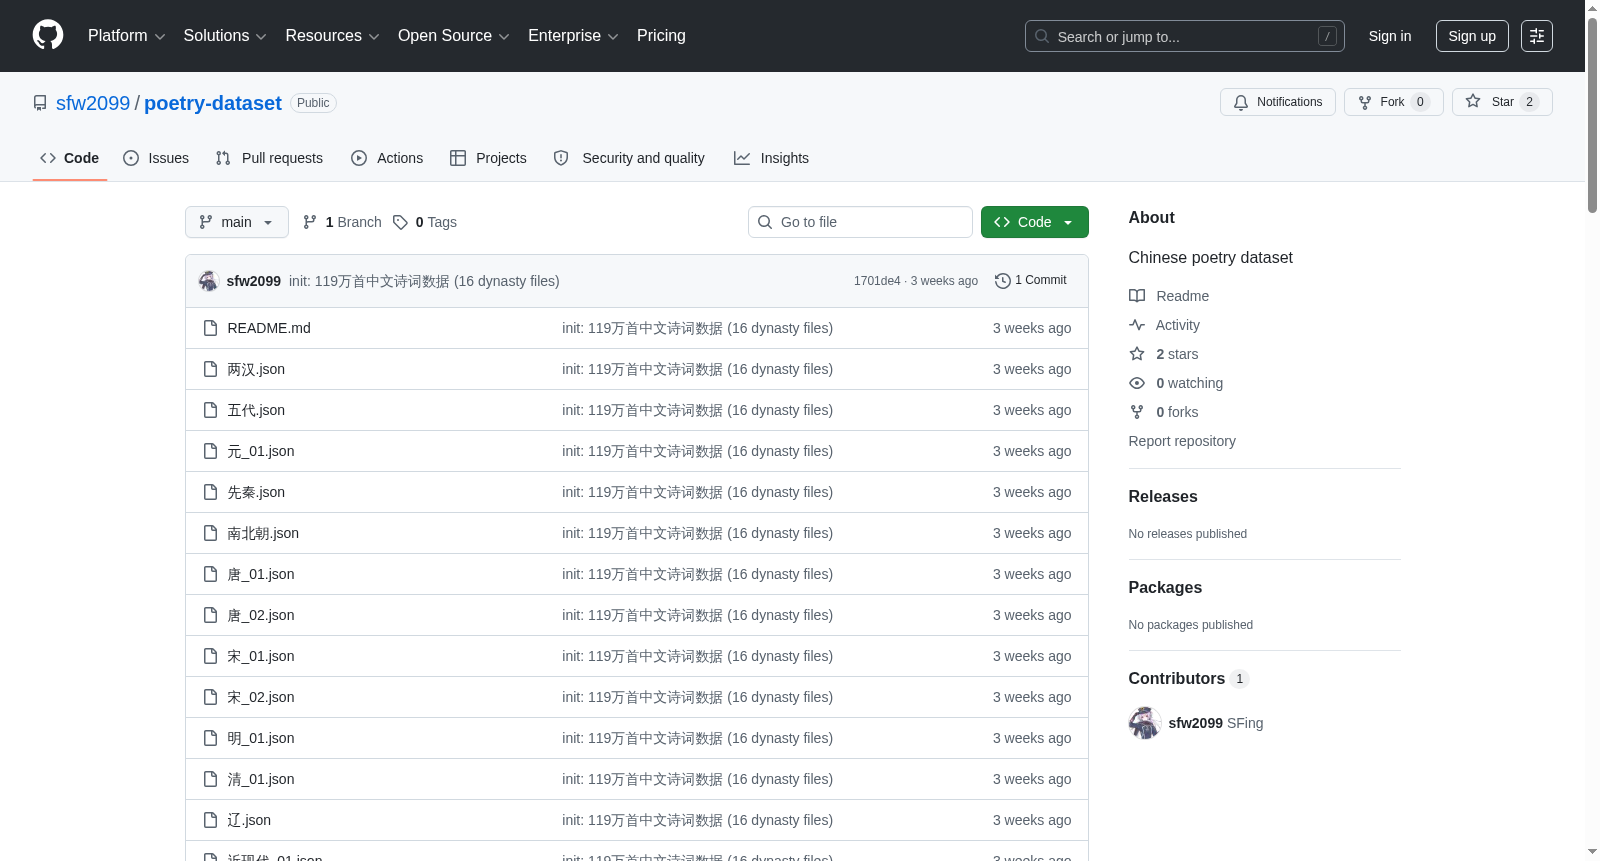
Chinese Poetry Dataset (诗词数据)
收藏资源简介:
格式化的中国古典诗词数据集,包含1,197,883首诗,时间跨度从先秦到近现代。数据以JSON格式存储,每个诗作对象包含标题、作者、朝代、内容、来源和版本字段。数据集经过解析、规范化、简繁转换、去重和排序处理,来源于三个开源诗歌集合。
A formatted Chinese classical poetry dataset containing 1,197,883 poems, spanning the period from the Pre-Qin Dynasty to modern times. The data is stored in JSON format, with each poem object comprising fields including title, author, dynasty, content, source and version. The dataset has undergone parsing, standardization, simplified-to-traditional Chinese character conversion, deduplication and sorting, and is sourced from three open-source poetry corpora.
数据集概述:Chinese Poetry Dataset (诗词数据)
- 名称: Chinese Poetry Dataset (诗词数据)
- 规模: 总计 1,197,883 首 诗词,其中包含 118,915 首 多版本诗词。
- 时间跨度: 从 先秦 至 近现代。
- 文件大小: 439 MB,共 16个 文件。
- 数据格式: JSON。
数据结构
每条诗词数据为一个 JSON 对象,包含以下字段:
| 字段 | 描述 |
|---|---|
title |
诗词标题(宋词为词牌名合并) |
author |
作者名(未知作者为"佚名") |
dynasty |
标准化的朝代名称 |
content |
完整诗词正文,以换行符分隔 |
source |
来源数据集 |
version |
0 = 唯一版本, >0 = 重复/版本变体 |
示例: json { "title": "静夜思", "author": "李白", "dynasty": "唐", "content": "床前明月光, 疑是地上霜。 举头望明月, 低头思故乡。", "source": "Poetry/唐.csv", "version": 0 }
朝代分布
| 朝代 | 诗词数量 | 对应文件 |
|---|---|---|
| 先秦 | 942 | 先秦.json |
| 两汉 | 363 | 两汉.json |
| 魏晋 | 3,046 | 魏晋.json |
| 南北朝 | 4,586 | 南北朝.json |
| 隋 | 1,642 | 隋.json |
| 唐 | 361,530 | 唐_01.json, 唐_02.json |
| 五代 | 543 | 五代.json |
| 宋 | 320,498 | 宋_01.json, 宋_02.json |
| 金 | 2,741 | 金.json |
| 辽 | 22 | 辽.json |
| 元 | 67,036 | 元_01.json |
| 明 | 254,656 | 明_01.json |
| 清 | 118,175 | 清_01.json |
| 近现代 | 62,103 | 近现代_01.json |
数据来源
数据集合并自三个开源诗词集合:
- chinese-poetry — 来自 github.com/chinese-poetry/chinese-poetry
- Poetry (Werneror) — 来自 github.com/Werneror/Poetry
- poetic-mao — 来自 github.com/cdn0x12/poetic-mao
数据处理流程
- 解析: 从三个来源解析 JSON / CSV / Markdown 格式数据。
- 标准化: 统一标题、作者、朝代、正文等字段。
- 繁简转换: 使用 OpenCC 将繁体中文转换为简体中文。
- 去重: 完全匹配的诗词合并,不同版本通过
version字段保留。 - 排序: 按朝代时间顺序分组存储。
许可协议
MIT 许可证 —— 合并后的数据集继承自原始数据源的许可证。