
遇见数据集

danish-foundation-models/swedish-dynaword

收藏
Hugging Face2026-05-30 更新2026-04-05 收录
官方服务:

资源简介:

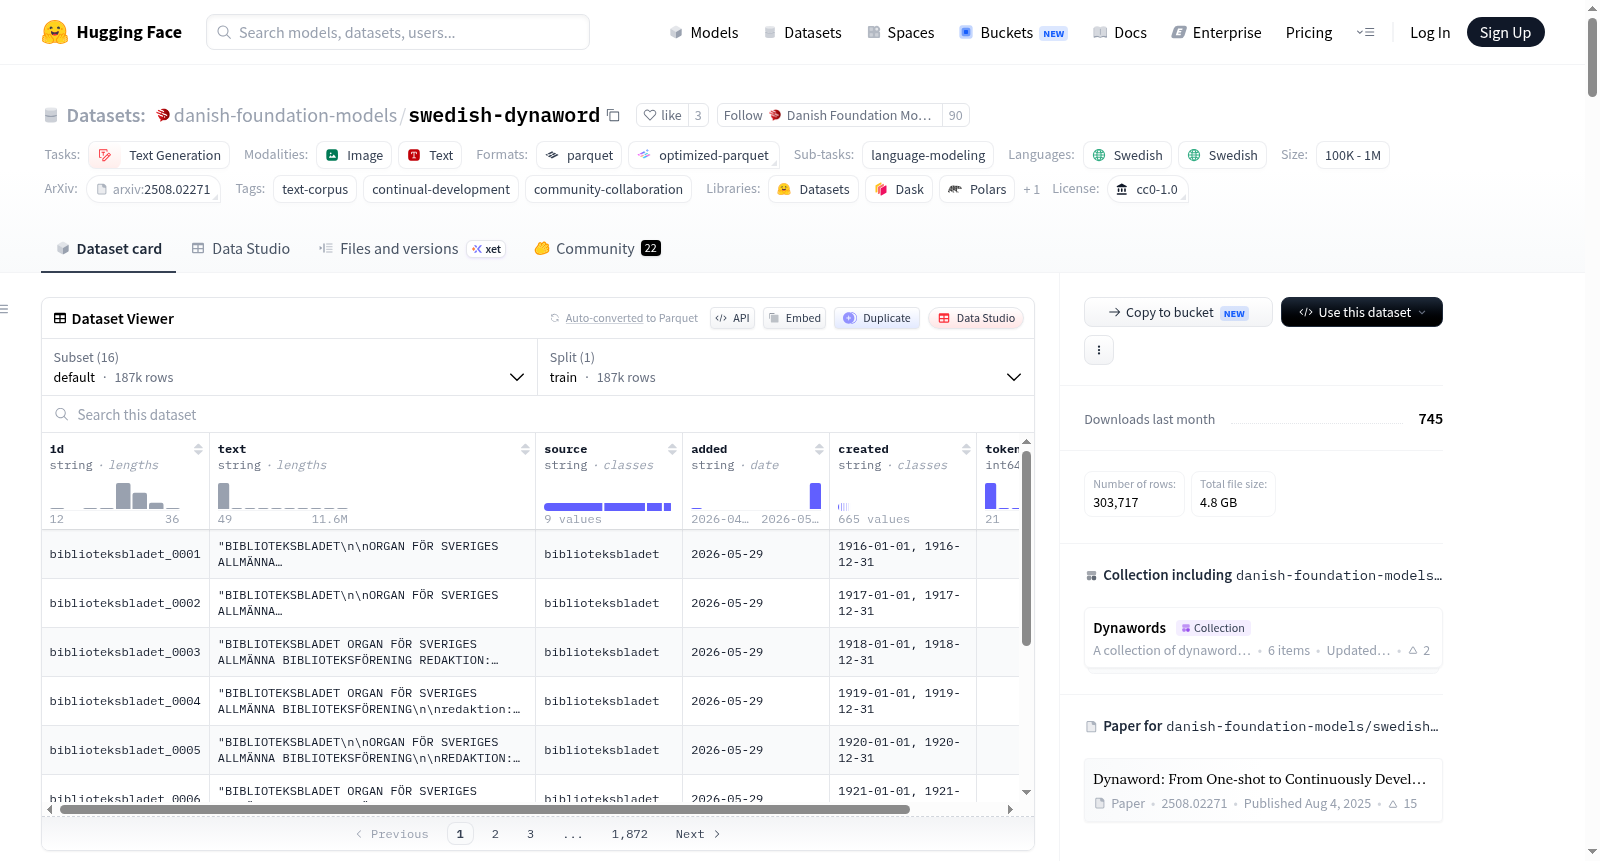
Swedish Dynaword 是一个收集自多个领域的瑞典语自由文本数据集集合,所有数据集均采用开放许可证,被认为适合用于训练大语言模型。该数据集持续开发,会随着新数据集的可用性而主动更新。数据集包含来自不同领域的文本,如报告、新闻和法律等,具体包括政府调查报告、议会辩论协议、委员会报告、议会动议、叙事和账目、政府调查文本、议会信件和通信等。数据来源于多个公开资源,例如Statens offentliga utredningar(政府调查报告)、Riksdagen propositioner(政府法案和议会信件)、Riksdagen protokoll(议会辩论协议)等。数据集使用CC-BY 4.0许可证,并包含约187.17K个样本,总令牌数约为3.21B(基于Llama 3分词器),平均文档长度在17.17K令牌(范围从21到4.06M令牌)。数据集支持通过HuggingFace的datasets库加载,可以整体或按子集(如lag1800、riksdagen-protokoll等)加载,并支持流式处理。

The Swedish dynaword is a collection of Swedish free-form text datasets from various domains. All of the datasets in the Swedish Dynaword are openly licensed and deemed permissible for training large language models. Swedish dynaword is continually developed, which means that the dataset will actively be updated as new datasets become available.
搜集汇总
数据集介绍
danish-foundation-models/swedish-dynaword 数据集图片
构建方式
Swedish Dynaword 是一个持续更新的瑞典语文本数据集,通过整合来自多个公开许可的瑞典语语料库构建而成。其构建方式遵循社区协作与动态扩展理念,目前汇聚了来自历史报纸、法律文献、政府报告及议会记录等15个不同来源的子集。每个子集均以Parquet格式存储,并通过HuggingFace Datasets库提供统一的加载接口。数据集分设多个配置,允许用户按需加载全部语料或单一子集,例如通过指定'dalpilen-1860'即可获取该新闻子集。所有语料均遵循CC0或CC-BY 4.0许可协议,确保用于大规模语言模型训练的法律合规性。
特点
该数据集的核心特点在于其多领域覆盖与持续演进机制。在领域分布上,报告类文本占据绝对主体(约3.17B tokens),涵盖政府调查、议会提案与辩论记录等;新闻类(约40M tokens)与法律类(约6.8M tokens)则提供补充视角。每条样本均附带'id'、'text'、'source'、'added'、'created'及'token_count'等结构化元数据字段,明确标注文档来源、添加日期、原始创建时间及基于Llama 3分词器计算的词元数量。数据集版本已迭代至0.0.6,通过revision参数可实现版本锁定,保障研究复现性。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集,基础用法为'datasets.load_dataset("danish-foundation-models/swedish-dynaword", split="train")'。为适应大规模数据处理需求,支持流式加载模式(streaming=True),避免内存溢出。针对特定子集研究,可通过配置参数指定子集名称,例如'load_dataset(name, "lag1800", split="train")'。数据集仅提供'train'划分,适合用于语言模型预训练、领域适应任务或历史语言演变分析。建议用户在加载时指定revision版本号以确保实验一致性。
背景与挑战
背景概述
瑞典语作为北欧地区的重要语言,其在自然语言处理领域的研究长期受限于高质量语料库的匮乏。为应对这一困境,丹麦基础模型研究团队于2024年推出了Swedish Dynaword数据集,这是一项持续演进的多领域瑞典语文本集合。该数据集整合了来自瑞典议会记录、政府调查报告、法律法规及历史报刊等15个开放许可来源的语料,总计包含约32.1亿词元(以Llama 3分词器计),覆盖报告、新闻和法律三大领域。其核心研究问题在于为大型语言模型的预训练提供丰富、多样且合法的瑞典语文本资源,同时通过持续更新机制保持数据集的时效性。该数据集以CC-0协议发布,极大地推动了瑞典语NLP社区的协作研究与模型开发。
当前挑战
Swedish Dynaword所应对的领域挑战主要源于瑞典语作为低资源语言在预训练语料上的严重不足。在此之前,缺乏一个集中、开放许可且涵盖历史与现代多领域的综合性瑞典语文本库,导致模型在瑞典语任务上的表现远逊于英语等资源丰富语言。在构建过程中,团队面临多重挑战:首先,数据源分散于不同机构(如Språkbanken Text与瑞典议会档案),需要统一格式与元数据;其次,部分历史文本(如19世纪的《Dalpilen》报纸)存在OCR识别误差、旧式拼写及编码问题,需进行细致清洗;此外,确保所有语料均符合CC-BY 4.0开放许可要求,并建立清晰的出处追溯与贡献机制,也是一项关键挑战。
常用场景
经典使用场景
Swedish Dynaword数据集作为瑞典语大语言模型预训练的核心语料库,最经典的用途在于语言建模任务。该数据集汇聚了来自政府报告、新闻报刊和法律文书等多个领域的非结构化文本,总令牌数达32.1亿,覆盖了19世纪至20世纪末的瑞典语书面语。研究者可直接使用其提供的`train`分割进行自回归语言模型的训练,通过持续学习范式捕捉瑞典语在时间维度上的语义演变与句法变迁,为低资源语言的预训练奠定坚实的数据基础。
解决学术问题
该数据集有效解决了北欧语言研究中长期存在的公开语料匮乏问题,特别是历史瑞典语文本的数字化与标准化难题。通过整合瑞典议会档案、政府调查报告及期刊文献等开放许可资源,它填补了非英语语言在预训练数据生态中的空白。其持续更新机制使学术界能够追踪语言使用的历时变化,并研究不同领域(如法律与新闻)之间的词汇分布差异,从而推动对比语言学和计算历史语言学的前沿探索。
衍生相关工作
该数据集衍生了多个经典的学术工作,例如基于其子集`riksdagen-protokoll`训练的议会辩论语义分析模型,以及利用`statens-offentliga-utredningar`进行的透明政府文本生成研究。研究者还基于语料的时间戳信息构建了词汇年代模型,用于量化瑞典语中概念漂移现象。此外,其CC-BY 4.0许可协议催生了多项社区驱动的标注项目,如针对历史法律文书的命名实体识别基准,进一步拓展了该语料库在低资源场景下的应用边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

