
遇见数据集

mteb/MultilingualNanoNFCorpusRetrieval

收藏
Hugging Face2026-06-21 更新2026-07-22 收录
官方服务:

资源简介:

MultilingualNanoNFCorpusRetrieval 是一个多语言文本检索数据集,属于大规模文本嵌入基准(MTEB)的一部分。该数据集基于NanoNFCorpus,后者是NFCorpus(一个用于医学信息检索的全文本学习排序数据集)的较小子集。数据集涵盖医学、学术和书面文本领域,支持11种语言:阿拉伯语、德语、英语、法语、意大利语、日语、韩语、挪威语、葡萄牙语、西班牙语和瑞典语。每个语言配置包括语料库(包含文档文本)、查询(用于检索的问题或关键词)和相关度判断(标识查询与文档之间的相关性分数)。数据集的测试集包含33033个样本,其中550个查询和32483个文档,平均文档长度约为1451.7个字符,平均查询长度约为23.0个字符,每个查询平均有50.36个相关文档。该数据集适用于评估多语言嵌入模型在文本检索任务上的性能。

MultilingualNanoNFCorpusRetrieval is a multilingual text retrieval dataset that is part of the Massive Text Embedding Benchmark (MTEB). It is based on NanoNFCorpus, a smaller subset of NFCorpus: A Full-Text Learning to Rank Dataset for Medical Information Retrieval. The dataset covers domains such as medical, academic, and written texts, and supports 11 languages: Arabic, German, English, French, Italian, Japanese, Korean, Norwegian, Portuguese, Spanish, and Swedish. Each language configuration includes a corpus (containing document texts), queries (questions or keywords for retrieval), and relevance judgments (scores indicating the relevance between queries and documents). The test set of the dataset contains 33,033 samples, with 550 queries and 32,483 documents, an average document length of approximately 1,451.7 characters, an average query length of about 23.0 characters, and an average of 50.36 relevant documents per query. This dataset is suitable for evaluating the performance of multilingual embedding models on text retrieval tasks.
提供机构:
mteb
搜集汇总
数据集介绍
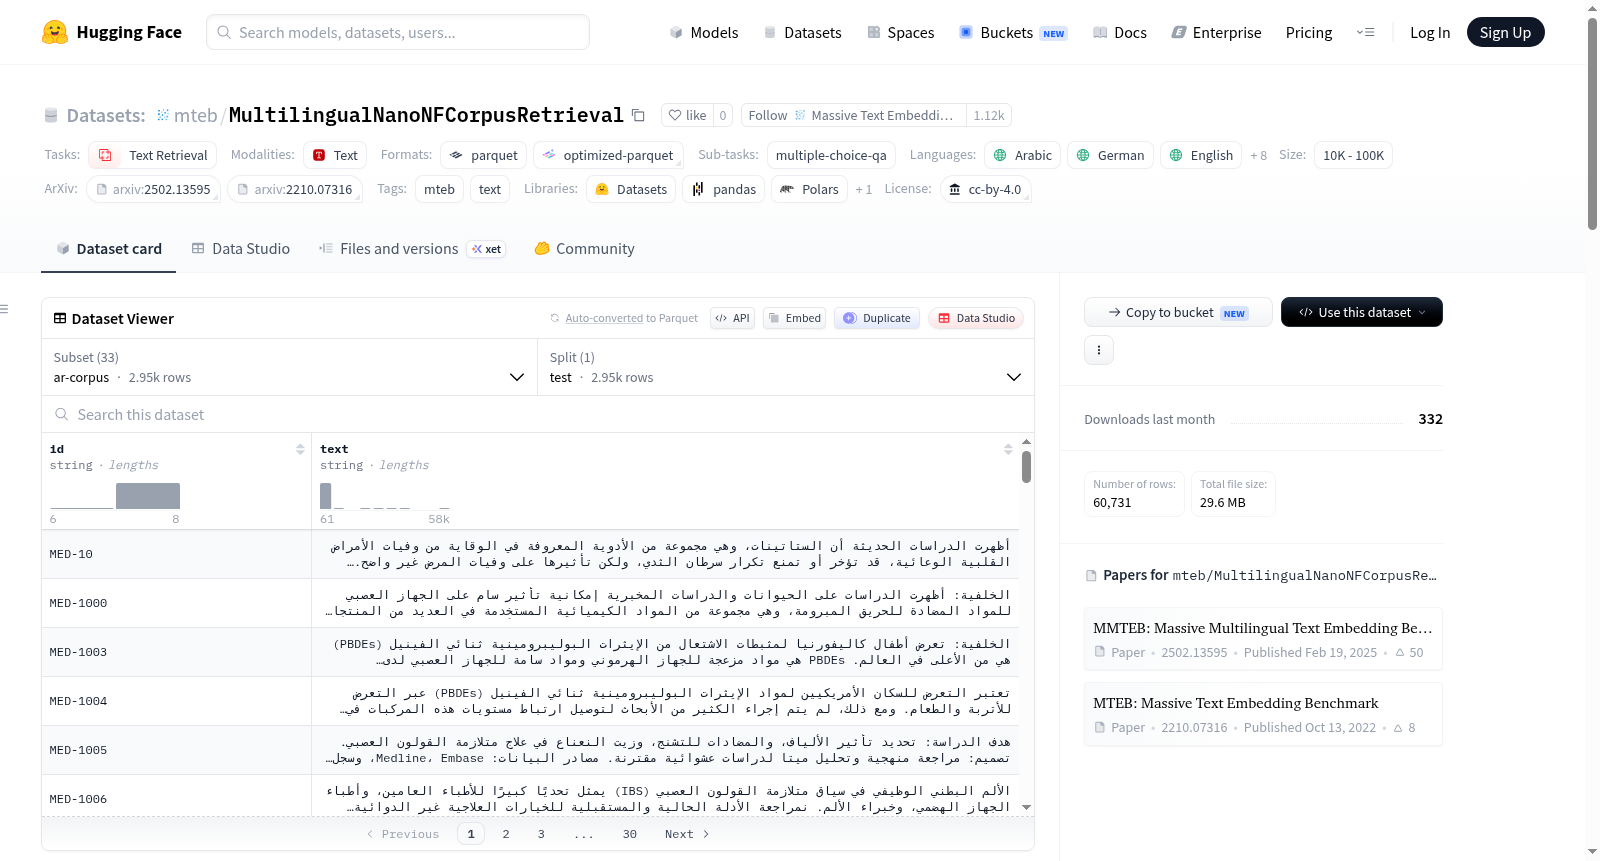
mteb/MultilingualNanoNFCorpusRetrieval 数据集图片
构建方式
MultilingualNanoNFCorpusRetrieval数据集源于NFCorpus,一个面向医学信息检索的全文本学习排序数据集,经由精简处理形成NanoNFCorpus子集。在此基础上,利用机器翻译技术将原始英文语料扩展至阿拉伯语、德语、法语、意大利语、日语、韩语、挪威语、葡萄牙语、西班牙语与瑞典语等十种语言,构建出多语言检索基准。每个语言配置均包含三个子集:corpus(文档库)、queries(查询集)与qrels(相关性判定),其中文档库包含2953个样本,查询集含50条查询,相关性标注共计2518条记录,整体数据规模各语言保持一致。
特点
该数据集的核心特点在于其多语言覆盖与医学领域的专业聚焦,涵盖十一种语言,为跨语言文本嵌入模型的评估提供了统一基准。每个语言版本的文档库、查询集及相关性标注数量均严格对齐,确保了不同语言间实验的可比性与公平性。数据集以CC-BY-4.0许可发布,来源可追溯,基于MTEB框架构建,支持标准化评测流程。测试集统计显示,全部语言合计包含33033个样本、550条查询及32483篇文档,平均每篇文档约1451个字符,每个查询平均对应约50个相关文档,展现了丰富的语义关联结构。
使用方法
研究者可通过MTEB(Massive Text Embedding Benchmark)框架便捷地使用该数据集进行评估。具体而言,调用mteb.get_task('MultilingualNanoNFCorpusRetrieval')加载任务,再通过mteb.get_model(YOUR_MODEL)指定待评测的嵌入模型,最后执行mteb.evaluate(model, task)完成自动化评估。数据集已按语言划分为31个配置(每语言含corpus、qrels、queries三个子集),用户可根据需求选择特定语言或进行多语言混合评测。评估结果可直接与MTEB排行榜上的其他模型进行横向对比,适用于文本检索任务的性能衡量。
背景与挑战
背景概述
多语言文本嵌入模型的研究近年来取得了显著进展,但对其在特定领域检索任务中的跨语言泛化能力评估仍相对匮乏。MultilingualNanoNFCorpusRetrieval数据集正是为填补这一空白而构建,其源自NFCorpus——一个专注于医学信息检索的全文本学习排序数据集。该数据集由MTEB(大规模文本嵌入基准)社区创建,核心研究人员包括Kenneth Enevoldsen等,发表于2025年的MMTEB项目中。通过将原始的英文NanoNFCorpus借助LiquidAI/nanobeir-multilingual-extended扩展为涵盖阿拉伯语、德语、法语等11种语言的平行语料,数据集旨在评估和推动多语言嵌入模型在医学学术文本检索任务中的表现。作为MTEB的重要组成部分,它已成为衡量多语言嵌入模型跨语言检索能力的关键基准之一。
当前挑战
该数据集所解决的领域问题核心是文本检索在医学领域的多语言可迁移性。一方面,医学文献蕴含大量专业术语与复杂语义关联,单语言检索已存在难度,跨语言检索更需模型准确理解并匹配不同语言中同一医学概念的表征,这对嵌入空间的语义对齐提出严峻挑战。另一方面,数据集的构建亦面临多重困难:原始NFCorpus的规模较大,需合理采样为NanoNFCorpus以保持代表性;而利用机器翻译扩展多语言版本时,如何保证翻译质量与医学语境下的术语准确性、避免语义漂移,是确保基准可靠性的关键。此外,各语言子集需保持相同的查询-文档相关性结构,以支持公平的跨语言评估,这对数据处理流程的严谨性提出了高要求。
常用场景
经典使用场景
在多语言信息检索与文本嵌入表示学习领域,MultilingualNanoNFCorpusRetrieval数据集弥合了跨语言语义匹配评估的鸿沟。该数据集源自医学信息检索领域的NFCorpus,经精简与翻译扩展后,囊括阿拉伯语、德语、英语、法语、意大利语、日语、韩语、挪威语、葡萄牙语、西班牙语和瑞典语共11种语言。其经典使用场景聚焦于评估和比较多语言文本嵌入模型在检索任务上的零样本跨语言迁移能力,通过提供统一的查询-文档相关性标注,研究者能够系统性地检验模型在跨语言环境下对医学文献的语义理解和排序性能。
衍生相关工作
围绕该数据集衍生了一系列具有影响力的经典工作,其中最核心的是作为Massive Multilingual Text Embedding Benchmark(MMTEB)的重要组成部分,发表于arXiv 2025。此外,其源数据NanoNFCorpus直接继承自Boteva等人(ECIR 2016)提出的全文本学习排序数据集,为现代稠密检索模型提供了精细化的相关性标注。基于此,研究者进一步发展了跨语言查询重构、多语言对比学习预训练等方向,如LiquidAI扩展的多语言嵌入项目,共同推动了多语言稠密检索从单语评估向多语言统一基准的演进。
数据集最近研究
最新研究方向
MultilingualNanoNFCorpusRetrieval数据集聚焦于跨语言医疗信息检索的前沿探索,通过整合11种语言的医学文本语料库与查询-相关性标注,为多语言嵌入模型在垂直领域的评估提供了标准化基准。该数据集源于NFCorpus的子集压缩与多语言扩展,紧密关联着大规模多语言文本嵌入基准(MMTEB)的构建浪潮,尤其支持对模型在罕见语言医学文献检索中的泛化能力进行零样本测试。其出现填补了多语言医疗检索任务中高质量基准的空白,促进了对跨语言语义对齐、域适应及低资源语言信息获取等热点问题的深入探究,对推动全球化医疗知识库的智能访问具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

