wanderlust-ai-dataset
收藏资源简介:
该数据集是Wanderlust AI旅行推荐应用生成的合成数据集,用于构建双层旅行推荐和行程规划系统。数据集包含两个文件:destinations_final.csv(2861行)描述220个真实城市的旅行体验,每个城市从13种旅行者画像(如预算背包客、奢华旅行者、美食家、家庭、独自女性旅行者、数字游民、蜜月夫妇、户外爱好者、退休人士、朋友团体、健康/瑜伽修行者、摄影师/Instagrammer、历史/文化爱好者)角度生成描述;pois_final.csv(23256行)包含各城市内真实命名的兴趣点(餐厅、咖啡馆、酒店、博物馆、海滩等)及其AI生成描述。总样本26117行。数据使用Meta Llama 3.1-8B-Instant模型通过Groq API生成,未使用网络爬虫。清洗过程移除了8176个完全重复的POI条目、728个模糊匹配重复项、5个提示指令泄露条目和4个空描述条目,并修正了509个(city, persona)重复行。探索性分析显示城市覆盖偏向欧洲和亚洲,描述长度因画像而异,POI类别以餐厅、咖啡馆、酒店为主。手动质量审核(80个样本)显示总体准确率63.7%(95% CI: 53.2%–74.3%),其中历史遗迹、酒店和海滩准确率高,餐厅和咖啡馆错误率较高。数据集已知限制包括:餐厅和咖啡馆建议需谨慎;某些城市类别深度不均;小众POI类别地理集中;可能存在少量残留重复。数据集预期用途为:构建旅行推荐系统、测试嵌入模型、探索合成数据生成技术,不作为经过验证的旅行指南。
This dataset is a synthetic dataset generated by the Wanderlust AI travel recommendation application, used to build a two-layer travel recommendation and itinerary planning system. The dataset contains two files: destinations_final.csv (2861 rows) describing travel experiences of 220 real cities, each city generated from the perspective of 13 traveler personas (such as budget backpacker, luxury traveler, foodie, family, solo female traveler, digital nomad, honeymoon couple, outdoor enthusiast, retiree, group of friends, wellness/yoga practitioner, photographer/Instagrammer, history/culture enthusiast); pois_final.csv (23256 rows) containing real-named points of interest within each city (restaurants, cafes, hotels, museums, beaches, etc.) along with AI-generated descriptions. Total samples: 26117 rows. The data was generated using the Meta Llama 3.1-8B-Instant model via the Groq API, without web scraping. The cleaning process removed 8176 exact duplicate POI entries, 728 fuzzy duplicate entries, 5 prompt injection entries, and 4 empty description entries, and corrected 509 duplicate (city, persona) rows. Exploratory analysis shows city coverage is biased towards Europe and Asia, description length varies by persona, and POI categories are dominated by restaurants, cafes, and hotels. Manual quality review (80 samples) shows an overall accuracy of 63.7% (95% CI: 53.2%–74.3%), with high accuracy for historical sites, hotels, and beaches, but higher error rates for restaurants and cafes. Known limitations include: caution needed for restaurant and cafe recommendations; uneven depth in some city categories; geographic concentration of niche POI categories; possible residual duplicates. Intended use: building travel recommendation systems, testing embedding models, exploring synthetic data generation techniques; not to be used as a verified travel guide.
✈️ Wanderlust AI — 旅游推荐数据集
📋 数据集概览
该数据集用于驱动 Wanderlust AI,一个双层旅游推荐和行程生成应用。第一层将用户的旅行“氛围”匹配到真实目的地;第二层在选定目的地内推荐真实景点;生成式功能则构建个性化的每日行程。
| 项目 | 详情 |
|---|---|
| 生成方式 | Meta 的 Llama 3.1-8B-Instant(通过 Groq 免费推理 API) |
| 方法 | 对真实、命名地点的 AI 生成描述(无网络爬取) |
| 总规模 | 26,117 行 |
| 覆盖范围 | 6 大洲的 220 个真实城市 |
📊 数据结构
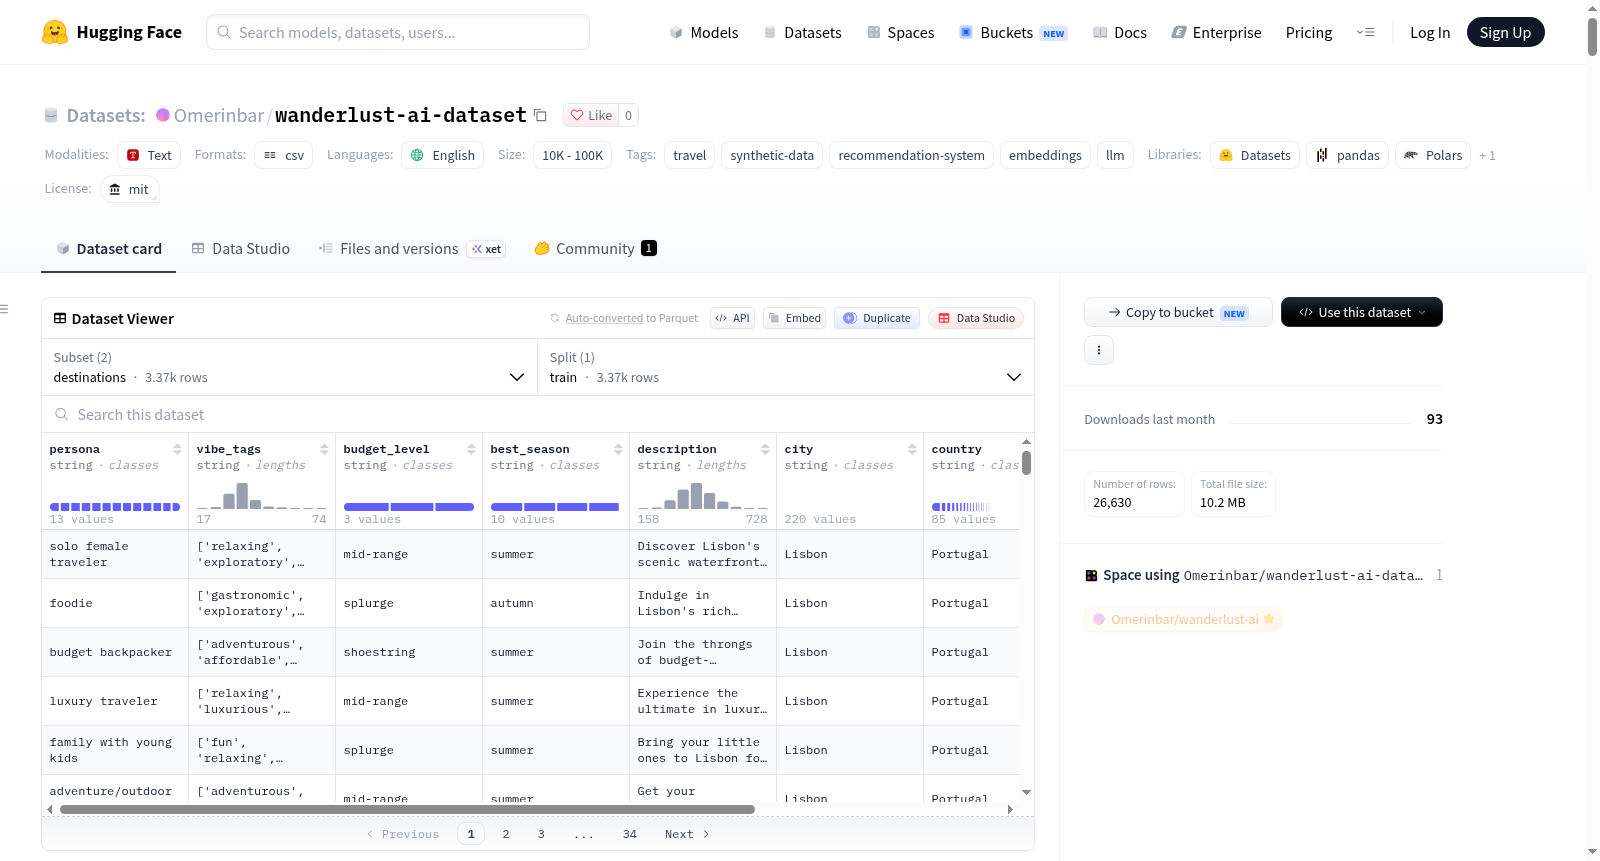
destinations_final.csv — 2,861 行
220 个真实城市的描述,每个城市从 13 种不同旅行者人设角度撰写。
主要列: city(城市)、country(国家)、region(大洲/地区)、persona(旅行者人设)、vibe_tags(氛围/主题标签)、budget_level(预算等级:穷游/中等/奢华)、best_season(最佳旅行季节)、description(AI 生成的个性化描述)
13 种人设: 预算背包客、奢华旅行者、美食家、带小孩的家庭、独自女性旅行者、数字游民、蜜月情侣、探险/户外爱好者、退休/老年旅行者、朋友团体、健康/瑜伽静修追求者、摄影师/Instagram 博主、历史/文化爱好者
pois_final.csv — 23,256 行
每个城市内的真实命名景点(餐厅、咖啡馆、酒店、博物馆、海滩等)。
主要列: name(地点名称)、category(景点类别)、description(AI 生成描述)、city(所在城市)、country(所在国家)
🧹 数据清洗
- 移除 8,176 条完全重复的 POI 记录和 728 条模糊匹配的近似重复记录(90% 相似度阈值,同类别内匹配)
- 统一了人设、类别和预算等级中的不一致大小写
- 移除 5 条包含泄露提示指令文本的异常记录
- 移除 4 条描述为空的记录
- 在后续推荐系统测试中发现并移除 509 条重复的
(city, persona)行
📈 探索性数据分析
- 城市覆盖:偏重欧洲(78 城)和亚洲(56 城);所有 13 种人设均匀分布(各约 220 条)
- POI 覆盖:每城 POI 数量 44 至 179 个(平均 105.7 个)
- 描述长度:目的地描述(平均 418 字符)远长于 POI 描述(平均 98 字符)
- 类别分布:餐厅和咖啡馆在所有地区占据主导;小众类别呈地域性集中,如“观景点”仅出现在欧洲,“水疗/健康场所”仅出现在亚洲和北美
- 预算分布:各区域内预算等级均衡,与现实生活成本无关联
🔍 数据质量审计
人工核验 80 条随机样本(对照真实世界来源):
| 判定 | 数量 | 百分比 |
|---|---|---|
| ✅ 准确 | 51 | 63.7% |
| ❌ 错误/幻觉 | 19 | 23.75% |
| ⚠️ 不确定 | 10 | 12.5% |
统计置信度: 准确率 63.7%(95% 置信区间:53.2%–74.3%,n=80)
按类别的错误率:
- 高错误率:咖啡馆(63%)、海滩酒吧(60%)、餐厅(55%)
- 低错误率:历史遗址(0%)、海滩(0%)、酒店(10%)、博物馆(25%)
主要发现: 餐厅和咖啡馆的可靠性明显低于其他类别,尽管它们是数量最大的两个类别。历史遗址、酒店和海滩高度可靠。
幻觉模式: 模型有时会将真实地标/地点名称错误地附加虚构的商业类型,例如“Restaurant Kapuzinerberg”(Kapuzinerberg 是萨尔茨堡的真实山丘地标,无此餐厅)、“Puri Saren Agung Restaurant”(实为乌布的真实宫殿/礼拜场所)、“Dar Chouara Museum”(混淆了非斯的真实 Chouara 皮革厂与虚构博物馆)。
⚠️ 已知局限性
- 餐厅和咖啡馆推荐需比历史遗址、博物馆或酒店更谨慎对待
- 部分城市类别深度不均(如某些城市历史遗址/博物馆覆盖薄弱)
- 小众 POI 类别按设计呈地域集中,非全球均匀分布
- 基于名称的模糊匹配存在固有限制,可能残留少量近似重复 POI 记录
🎯 预期用途
该数据集用于驱动双层旅游推荐系统(目的地匹配 + 目的地内 POI 匹配)。适用于构建推荐系统、测试嵌入模型和探索合成数据生成——不适用作事实性、经过验证的旅行指南。
📄 许可证
MIT
作者: Omer Inbar & Ohad | Reichman University — Adelson School of Entrepreneurship | Introduction to Data Science | 2026