DeepPavlov/wizard_of_wikipedia_es
收藏资源简介:
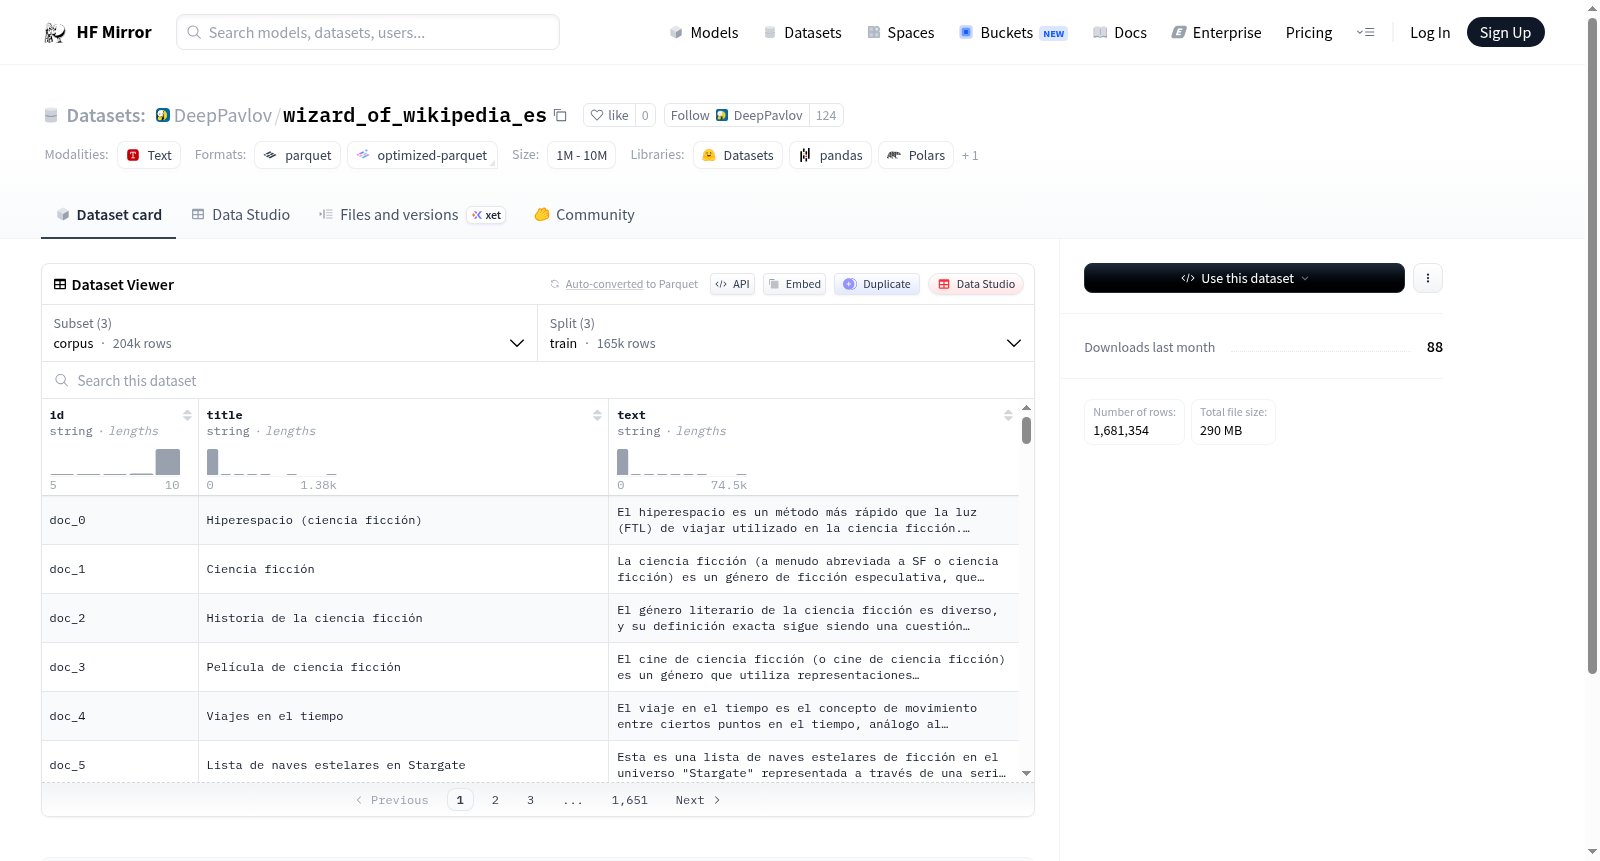
这是一个用于信息检索或对话检索任务的数据集,包含三个主要部分:1. 语料库(corpus):包含文档的ID、标题和文本内容,用于构建文档集合;2. 查询(queries):包含查询的ID、文本内容(由内容和角色组成)、人物角色(persona)和主题(topic),模拟用户查询,支持个性化检索;3. 查询-文档相关性(qrels):包含查询ID、文档ID和相关性分数,用于训练和评估检索模型。数据集分为训练、验证和测试分割,适用于构建和评估检索系统,特别是在个性化上下文中的检索任务。
This is a dataset for information retrieval or conversational retrieval tasks, consisting of three main components: 1. Corpus: includes document IDs, titles, and text content for building a document collection; 2. Queries: includes query IDs, text content (composed of content and role), persona, and topic, simulating user queries with support for personalized retrieval; 3. Query-document relevance (qrels): includes query IDs, document IDs, and relevance scores for training and evaluating retrieval models. The dataset is split into training, validation, and test sets, suitable for building and evaluating retrieval systems, particularly in personalized contexts.