Mouse
收藏资源简介:
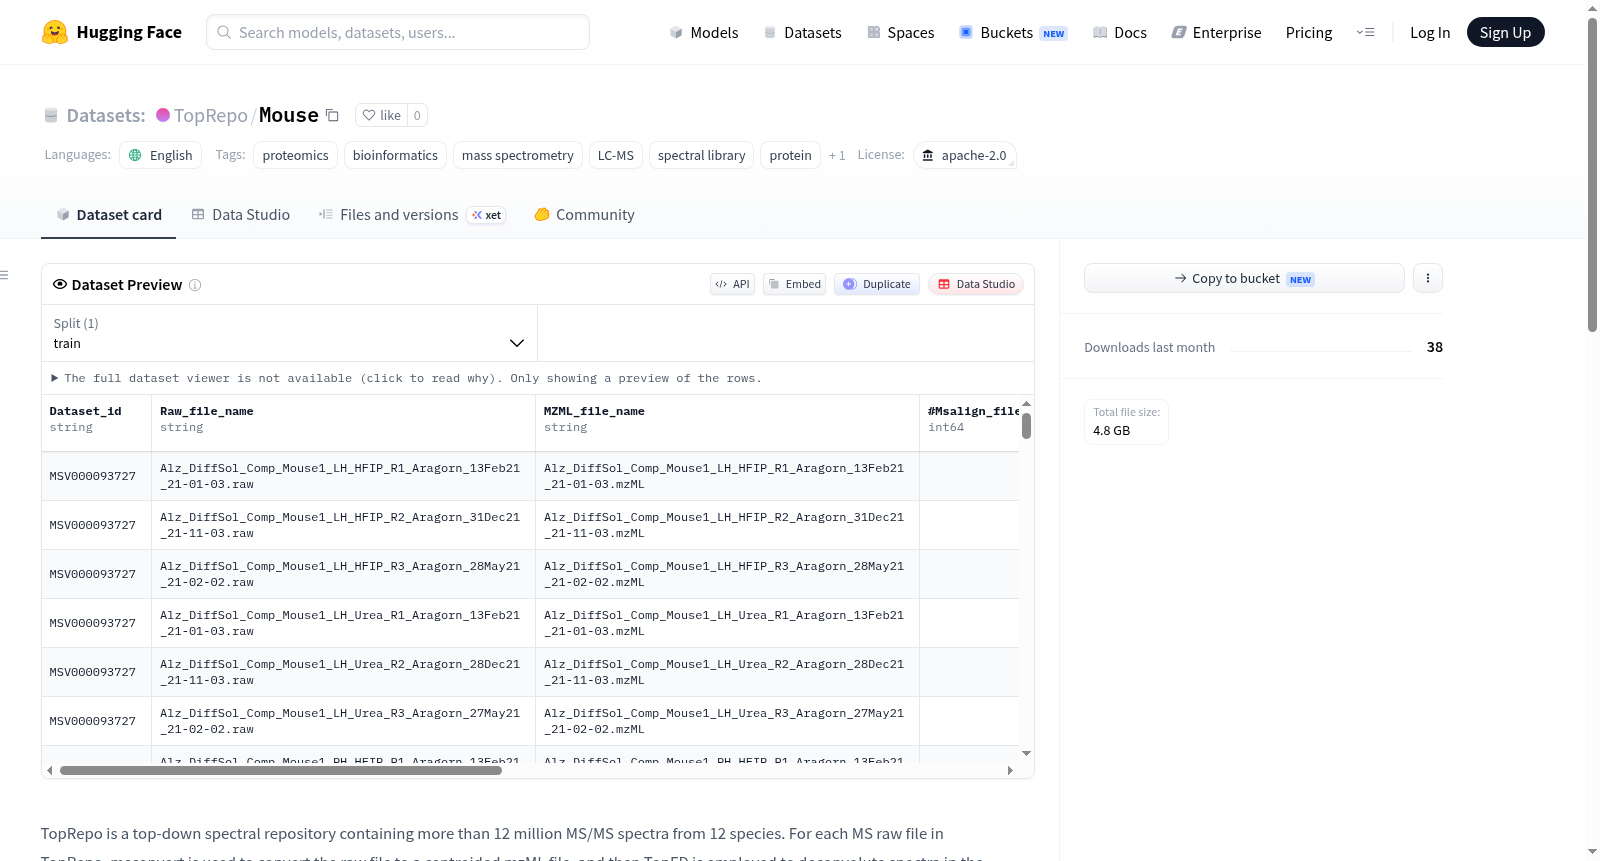
TopRepo Mouse数据集是TopRepo顶层谱图库中针对小鼠物种的蛋白质组学质谱数据子集,涵盖来自12个物种的超过1200万MS/MS谱图。该数据集通过标准化流程生成:首先将原始质谱文件转换为centroided mzML格式,接着进行谱图去卷积处理生成msalign文件和蛋白质形式特征文件,最后通过比对蛋白质组序列数据库实现谱图鉴定。数据集包含三个核心部分:1) 元数据表(toprepo_mouse_meta_table_v1.2.0.tsv),记录实验级别的元信息,如数据集标识符、物种、仪器数据、解离方法及谱图、蛋白质和蛋白质形式的数量统计;2) 谱图表(toprepo_mouse_spectrum_table_ms2_v1.2.0.tsv),包含谱图级别的MS/MS分析数据,如扫描标识符、前体离子信息、碎片测量数据、蛋白质形式注释和鉴定结果;3) 注释的.msalign文件。该数据集适用于蛋白质鉴定、蛋白质形式分析、质谱数据处理方法开发等蛋白质组学和生物信息学研究。
The TopRepo Mouse dataset is a subset of proteomics mass spectrometry data for the mouse species within the TopRepo top-down spectral library. TopRepo is a comprehensive top-down spectral library containing over 12 million MS/MS spectra from 12 species. The dataset is generated through a standardized data processing pipeline: raw mass spectrometry files are first converted to centroided mzML format using msconvert, then mzML files are deconvoluted using TopFD to produce msalign files and proteoform feature files, and finally TopPIC is used to match msalign files against corresponding proteome sequence databases for spectrum identification. The Mouse dataset specifically consists of three core components: 1) A metadata table (toprepo_mouse_meta_table_v1.2.0.tsv) recording experiment-level metadata, including dataset identifiers, species information, instrument metadata, dissociation methods, and counts of spectra, proteins, and proteoforms; 2) A spectrum table (toprepo_mouse_spectrum_table_ms2_v1.2.0.tsv) containing spectrum-level MS/MS analysis data, such as scan identifiers, precursor ion information, fragment measurements, proteoform annotations, protein identification results, and statistical confidence metrics; 3) Annotated .msalign files. The dataset is suitable for proteomics and bioinformatics research tasks such as protein identification, proteoform analysis, and mass spectrometry data processing method development.
数据集概述
名称:Mouse Dataset(小鼠数据集),属于 TopRepo 项目的一部分。
语言:英文。
许可证:Apache-2.0。
数据集描述
TopRepo 是一个自上而下的质谱谱图库,包含来自12个物种的超过1200万个 MS/MS 谱图。针对小鼠物种,数据集提供了通过标准化数据分析流程生成的多种文件。数据处理流程为:将原始 MS 文件转换为质心化的 mzML 文件,使用 TopFD 进行去卷积生成 msalign 文件和蛋白质形式特征文件,再利用 TopPIC 进行谱图鉴定,鉴定结果存储于 TSV 文件中。
数据集结构
小鼠数据集包含以下文件:
-
元数据表(
toprepo_mouse_meta_table_v1.2.0.tsv)- 实验级别的元数据,包括:
- 数据集标识符
- 物种信息
- 仪器元数据
- 解离方法
- 谱图、蛋白质和蛋白质形式的计数
- 实验级别的元数据,包括:
-
谱图表(
toprepo_mouse_spectrum_table_ms2_v1.2.0.tsv)- 谱图级别的 MS/MS 分析数据,包括:
- 扫描标识符
- 前体离子信息
- 碎裂测量值
- 蛋白质形式注释
- 蛋白质鉴定结果
- 统计置信度指标
- 谱图级别的 MS/MS 分析数据,包括:
-
带注释的 .msalign 文件
数据来源
- 仓库网站:https://toprepo.org/
- 论文:https://www.biorxiv.org/content/10.64898/2026.02.20.707032v1
- GitHub 仓库:https://github.com/toppic-suite/toprepo
联系方式
如有问题,可联系 TopRepo 团队:xwliu@tulane.edu 或 kli7@tulane.edu。版权归杜兰大学所有(2025-2026)。