
VerboVision/cem_mil_pares_5k_pt_11
收藏官方服务:
资源简介:
--- dataset_info: features: - name: file_name dtype: image - name: model a dtype: string - name: model b dtype: string splits: - name: Train num_bytes: 3324006792 num_examples: 5512 download_size: 3316130455 dataset_size: 3324006792 configs: - config_name: default data_files: - split: Train path: data/Train-* ---
提供机构:
VerboVision搜集汇总
数据集介绍
构建方式
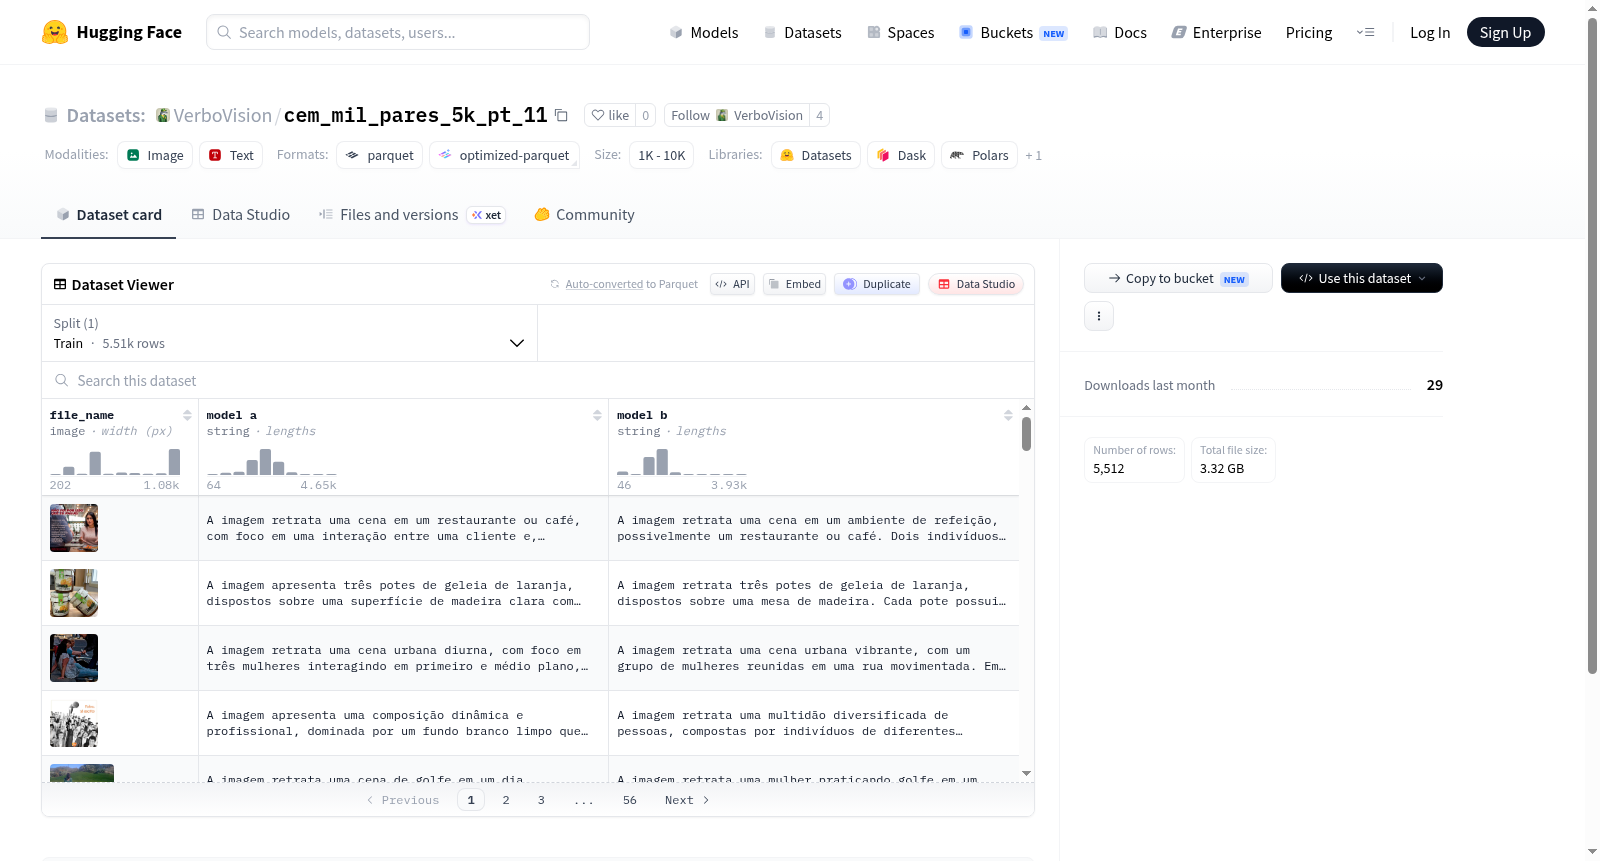
cem_mil_pares_5k_pt_11数据集专为葡萄牙语文本与图像匹配任务设计,通过收集5512个训练样本构建而成。每个样本包含一张图像及两个文本描述(model a与model b),旨在评估模型在图像与双文本对应关系中的判别能力。数据以图像文件和字符串字段形式存储,训练集总大小约3.1GB,覆盖多样化的视觉与语言场景,确保任务挑战性。
特点
该数据集的核心特点在于其双文本对照结构,每个图像关联两个不同文本,可支持对比学习、图像文本匹配及多模态检索任务。葡萄牙语语料的专属设计填补了低资源语言在该领域的空白,同时5512个样本的规模平衡了训练效率与多样性,适合中等规模模型微调与评估。数据均为高分辨率图像,保障视觉特征提取的可靠性。
使用方法
使用者可通过HuggingFace Datasets库加载默认配置,直接调用训练集拆分(Train)进行模型训练。数据以文件路径和文本标签形式组织,适用于图像编码器与文本编码器的联合优化。建议采用对比损失函数或三元组损失,利用双文本结构强化跨模态对齐能力,并针对葡萄牙语分词器进行预分词处理以提升效率。
背景与挑战
背景概述
在多模态与生成式人工智能迅猛发展的当下,视觉语言模型(VLM)的评估与对比成为研究热点。cem_mil_pares_5k_pt_11数据集由巴西研究机构于2023年创建,旨在系统化比较不同图像生成模型在葡萄牙语语境下的输出质量。该数据集包含5512个训练样本,每个样本由一张图像及对应两个模型(Model A与Model B)的描述文本构成,聚焦于用户主观偏好与模型客观性能之间的关联。其核心研究问题在于如何建立多维度、语言敏感的模型对比基准,为低资源语言环境下的生成模型调优提供数据支撑。该数据集填补了葡萄牙语视觉语言评估领域的空白,对推动拉丁美洲地区AI研究标准化具有重要示范意义。
当前挑战
该数据集面临的结构性挑战首先在于领域问题层面:当前主流视觉语言基准多基于英语,缺乏对葡萄牙语语义及文化特质的刻画,导致模型在非英语环境下的泛化性能难以准确衡量。构建过程中,挑战集中于数据标注的主观性——5512个样本需依赖人工判断模型输出的美学与语义契合度,而跨标注者一致性难以保证;此外,图像生成模型的快速迭代使得数据集时效性面临考验,静态标注集可能无法反映最新模型的能力边界。数据规模与样本多样性之间的平衡亦构成挑战,有限图像数限制了长尾场景的覆盖,增加了评估偏差的风险。
常用场景
经典使用场景
cem_mil_pares_5k_pt_11数据集汇聚了5,512对精心配对的葡萄牙语图像—文本样本,为跨模态检索与视觉语言理解研究提供了坚实基础。在计算机视觉与自然语言处理交叉领域,该数据集常被用于训练和评估模型在图文匹配任务上的表现,尤其是在葡萄牙语这一低资源语言场景下。研究者可借助该数据集构建跨模态对齐系统,探索图像与文本之间的语义桥梁,推动多模态学习在非英语环境中的发展。
解决学术问题
该数据集有效填补了葡萄牙语视觉语言研究中的资源空白,解决了跨模态模型因缺乏高质量配对数据而在低资源语言上表现不佳的学术难题。通过提供标准化的训练分割,研究团队能够系统地评估模型在图文匹配、视觉问答等任务中的泛化能力。这一贡献不仅促进了多模态理解的多语言均衡发展,还为探究语言与视觉信息交互的普适性规律提供了实证支撑,具有重要的方法论意义。
衍生相关工作
基于该数据集,研究者已衍生出多项经典工作,包括构建葡萄牙语多模态预训练模型、开发跨语言图文检索基准测试以及提出面向低资源语言的视觉语言微调策略。例如,相关研究利用该数据集对比了不同架构(如CLIP、ALIGN)在葡萄牙语场景下的迁移表现,并发布了配套的评估基准。此外,该数据集还启发了针对巴西葡语特色的文化视觉理解任务,推动了多模态数据集建设向语言多样性和区域特色深化。
以上内容由遇见数据集搜集并总结生成


