
LiteFold/AlphaFoldDB
收藏官方服务:
资源简介:
AlphaFoldDB是一个开放数据库,包含预测的蛋白质三维结构及置信度分数,极大扩展了已知蛋白质序列的结构覆盖范围。
AlphaFoldDB is an open database of predicted protein 3D structures with confidence scores, massively expanding structural coverage for known protein sequences.
提供机构:
LiteFold搜集汇总
数据集介绍
构建方式
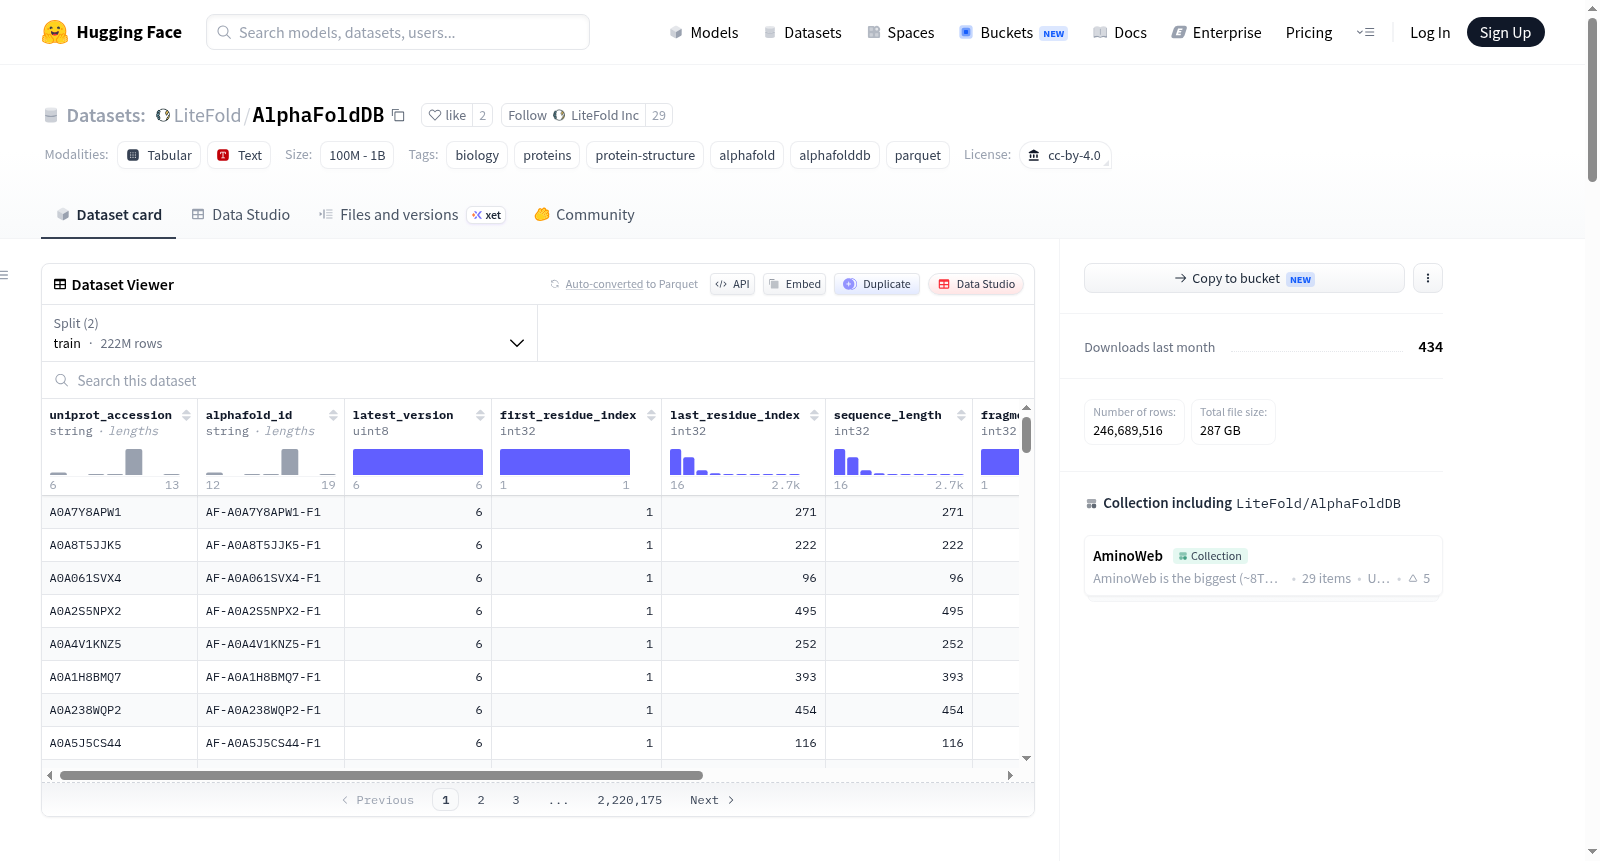
AlphaFoldDB数据集源自DeepMind与欧洲生物信息学研究所联合开发的AlphaFold蛋白质结构预测系统,旨在为生物信息学界提供大规模、高精度的蛋白质三维结构预测索引。该数据集以Parquet格式存储,包含训练集与测试集两大分区,其中训练集涵盖222,017,452条记录,测试集包含24,672,064条记录。数据集的分割策略基于UniProt登录号的哈希值取模运算,若结果为0则归入测试集,其余则划入训练集,确保了划分的确定性与可复现性。此外,数据集通过镜像文件描述了48个批量归档文件,涵盖蛋白质组、全球健康及Swiss-Prot等多样化来源的档案,极大提升了结构预测的覆盖范围。
使用方法
研究者可通过Hugging Face的datasets库便捷加载AlphaFoldDB数据集,仅需调用load_dataset函数即可获取完整的训练集与测试集,并支持直接指定分割参数以获取特定子集。针对大规模计算场景,数据集支持流式加载模式,用户可逐条处理记录而无需一次性将全部数据载入内存,极大降低了资源消耗。此外,数据集以Parquet格式存储,兼容DuckDB、PyArrow、Polars及Spark等列式处理引擎,便于执行复杂查询与高效分析。每一条记录均包含alphafold_id字段,可据此构建AlphaFold DB官网的条目URL,快速访问模型的详细可视化页面。用户亦可利用latest_version字段进行筛选,例如仅保留当前最新版本为6的条目,以聚焦于最新预测结果。
背景与挑战
背景概述
AlphaFoldDB是由欧洲生物信息学研究所(EMBL-EBI)的Varadi等人于2022年创建的开源蛋白质三维结构预测数据库,其核心研究问题在于利用深度学习模型AlphaFold2大幅扩展已知蛋白质序列的结构覆盖范围。该数据集通过提供高置信度的预测结构及置信度评分,解决了实验测定蛋白质结构耗时且覆盖率有限的难题,对结构生物学、药物设计及蛋白质功能研究产生了深远影响。其大规模、高质量的结构预测数据已成为生物信息学领域的重要基础资源。
当前挑战
AlphaFoldDB面临的挑战包括:1) 领域问题层面,虽然覆盖了海量序列,但对多结构域蛋白质的片段化预测及非标准序列的处理仍存在精度局限性,且无法替代实验结构在动态构象变化等方面的研究;2) 数据集构建过程中,需处理来自不同版本的模型(v1、v2、v6)数据一致性,并应对序列长度跨度极大(5至4186个残基)带来的存储与解析复杂度,同时约2.3%的条目不包含片段编号,增加了数据清洗与标准化处理的难度。
常用场景
经典使用场景
在蛋白质结构预测与生物学研究的交汇处,AlphaFoldDB凭借其大规模、高置信度的三维结构预测数据,成为解析蛋白质序列-结构-功能关系的基石性资源。该数据集汇聚了逾2.46亿条蛋白质结构预测条目,涵盖从微观残基索引到宏观结构版本的多元信息,为研究者提供了前所未有的结构覆盖广度。经典使用场景包括利用序列长度、片段编号及预测版本等特征,筛选特定置信度区间的结构数据进行下游分析;抑或借助UniProt accession与AlphaFold ID的映射关系,将结构预测与功能注释数据库进行交叉整合。通过流式加载或列式引擎处理,研究人员能够高效地开展从单蛋白结构验证到全蛋白组结构图谱构建的系统性研究,推动结构生物学从个案解析迈向数据驱动的规模化探索。
解决学术问题
面对传统实验结构生物学耗时耗力、覆盖率有限的困境,AlphaFoldDB从根本上解决了蛋白质结构数据稀疏的学术难题。它打破了长期以来结构解析依赖X射线晶体学、核磁共振或冷冻电镜等昂贵实验手段的瓶颈,使数百万尚未获得实验结构的蛋白质序列拥有了高精度预测模型。这一数据集使得研究者能够系统性地探索蛋白质折叠规律、结构域演化关系以及序列变异对三维构象的影响,极大推动了结构基因组学与比较蛋白质组学的发展。其带来的深远意义在于,结构信息的民主化使得功能注释、药物靶点发现及致病突变机制研究得以在更大规模上展开,加速了从序列到功能解读的科研范式转型。
实际应用
AlphaFoldDB的实际应用已渗透至生物医药研发的多个关键环节。在药物发现领域,研究人员利用该数据集中的高置信度结构进行虚拟筛选与分子对接,识别小分子候选化合物的结合位点,缩短先导化合物优化周期。在酶工程与合成生物学中,结构预测数据指导理性设计以提升酶活性或底物特异性,助力绿色催化与生物制造。此外,AlphaFoldDB还广泛应用于疫苗设计——通过精确呈现病毒表面蛋白的三维构型,辅助抗原表位预测与免疫原性评估,例如在新冠病毒刺突蛋白变异体的结构分析中发挥重要作用。这些实际场景充分展示了该数据集从基础研究到产业转化的桥梁作用。
数据集最近研究
最新研究方向
AlphaFoldDB作为蛋白质三维结构预测的里程碑式数据库,正推动计算生物学与结构基因组学的深度融合。当前前沿研究聚焦于利用该数据集2.46亿条序列-结构映射记录,驱动基于深度学习的蛋白质动态模拟、功能位点预测以及稀有构象捕捉。随着欧洲生物信息学研究所持续扩展v6版本预测覆盖,结合大规模并行计算框架(如DuckDB、PyArrow),研究者得以系统解析疾病突变对蛋白质折叠稳定性的扰动机制。该数据库不仅加速了药物靶点发现与抗体设计流程,更催生了从单结构预测到多构象集合分析的范式跃迁,为理解生命分子机器的普适性运动规律提供了前所未有的数据基石。
以上内容由遇见数据集搜集并总结生成


