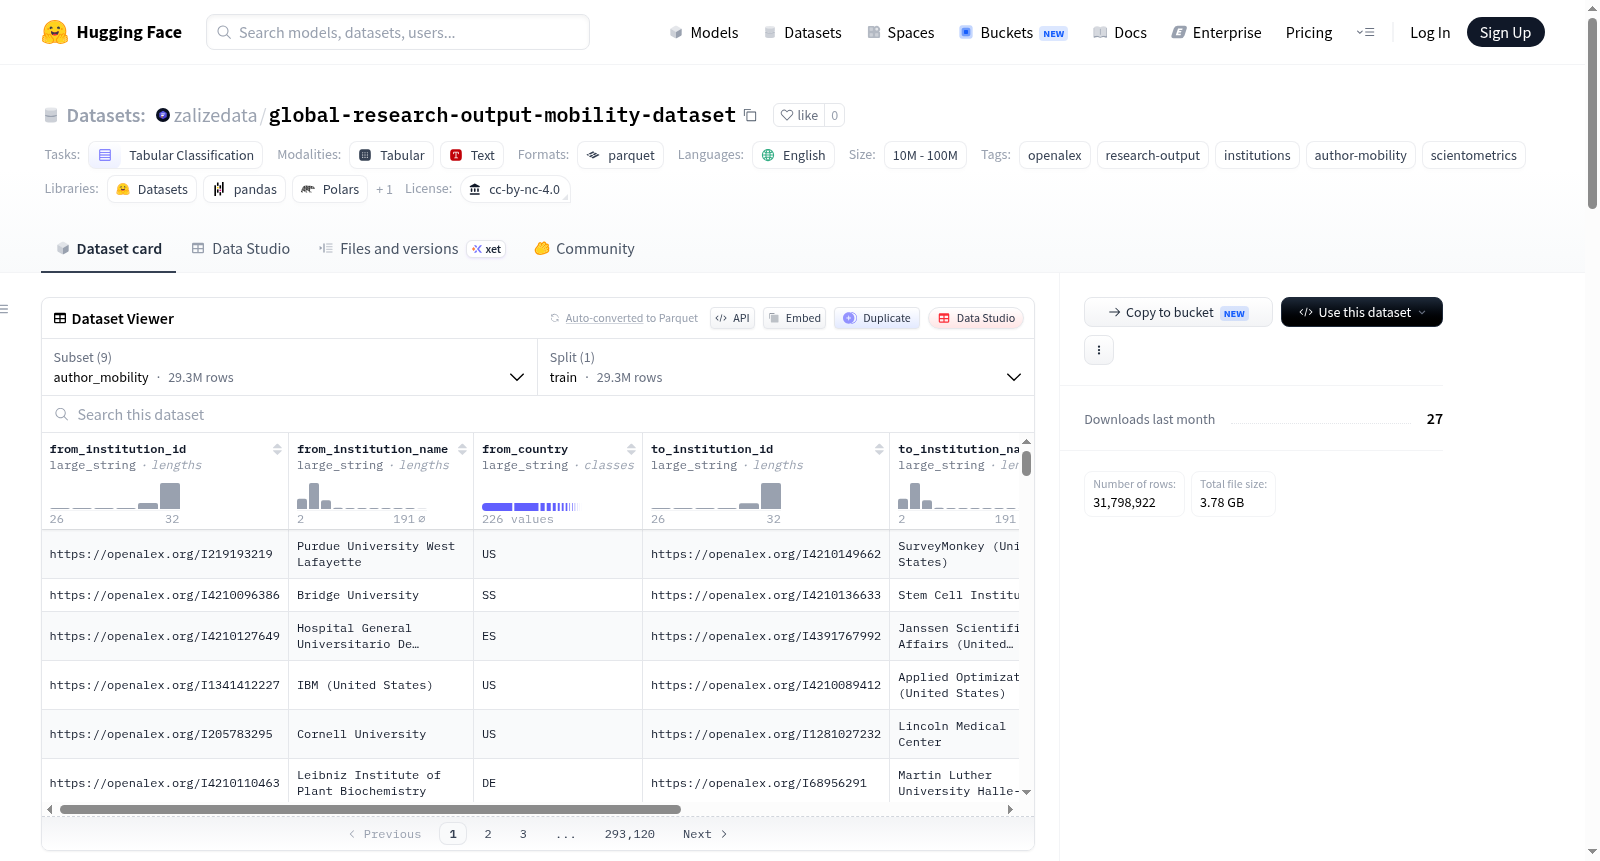
global-research-output-mobility-dataset
收藏资源简介:
该数据集是基于OpenAlex官方快照构建的全球研究产出与流动性数据集,由DataForge开源数据项目提供。数据集包含机构、来源(期刊等)、主题、资助者等核心实体,以及基于这些实体衍生的机构研究产出概况和聚合的作者流动信息。数据以多个配置(config)形式组织,包括:author_mobility(作者流动)、funders(资助者)、institution_master(机构主表)、institution_profiles(机构概况)、publishers(出版商)、source_profiles(来源概况)、sources(来源)、topic_trends(主题趋势)、topics(主题)。数据规模在10M到100M行之间,具体分为三个层级:S级(约30.5万行,包含机构/来源/主题引用表)、M级(约248.7万行,包含机构概况)、L级(约3179.9万行,包含完整的衍生库和聚合的作者流动数据)。每个数据包均附带数据字典、数据表和QA报告。数据集主要用于大学和实验室的基准测试、人才流动与人才流失分析、资助者和主题图谱绘制、研究政策分析等任务。许可协议为CC BY-NC 4.0(学术/个人使用需署名并回链),商业使用需获取DataForge商业许可。
This dataset is a global research output and mobility dataset built from the official OpenAlex snapshot, provided by the DataForge open-source data project. It includes core entities such as institutions, sources (journals, etc.), topics, funders, and derived information including institutional research output profiles and aggregated author mobility data. The data is organized into multiple configurations: author_mobility, funders, institution_master, institution_profiles, publishers, source_profiles, sources, topic_trends, and topics. The dataset size ranges from 10M to 100M rows, with three levels: S-level (~305k rows, including institution/source/topic citation tables), M-level (~2.487M rows, including institutional profiles), and L-level (~31.799M rows, including the full derived library and aggregated author mobility data). Each data package includes a data dictionary, data tables, and a QA report. The dataset is primarily used for university and lab benchmarking, talent mobility and brain drain analysis, funder and topic mapping, and research policy analysis. The license is CC BY-NC 4.0 (academic/personal use requires attribution and backlink; commercial use requires a DataForge commercial license).
全球科研产出与人才流动数据集(OpenAlex)
数据集概览
该数据集基于OpenAlex官方快照构建,提供机构层面的科研产出概况和聚合的学者流动数据,涵盖机构、来源、主题和资助者等信息。属于DataForge开放数据项目的一部分,适用于学术和个人使用。
数据规模与分装
数据集提供三个不同规模的压缩包:
| 版本 | 数据量 | 文件大小 |
|---|---|---|
| S(入门版) | 305,027行 | 18.8 MB |
| M(研究版) | 2,487,020行 | 180.7 MB |
| L(完整版) | 31,798,922行 | 2.41 GB |
每个压缩包均包含数据字典、数据说明书和质量评估报告。
数据配置
数据集包含9个配置子集,所有数据以Parquet格式存储:
- author_mobility(4个文件):学者流动数据
- funders(1个文件):资助者信息
- institution_master(1个文件):机构主数据
- institution_profiles(1个文件):机构概况
- publishers(1个文件):出版商信息
- source_profiles(1个文件):来源概况
- sources(1个文件):来源信息
- topic_trends(1个文件):主题趋势
- topics(1个文件):主题信息
数据用途
- 高校与实验室绩效评估
- 人才流动与人才流失分析
- 资助者与学科主题分布研究
- 科研政策分析
数据来源与方法论
数据来源于OpenAlex官方快照,包括机构、来源、主题、资助者等基础数据,并在此基础上衍生出机构概况和聚合的学者流动数据。
许可协议
采用双重许可模式:
- 学术/个人用途:CC BY-NC 4.0许可,要求注明出处并回链至data.zalize.com
- 商业用途:需获取DataForge商业许可
- 底层数据:遵循OpenAlex的CC0 1.0许可,允许商业再分发
引用方式
text DataForge (data.zalize.com), built from the OpenAlex CC0 snapshot — https://data.zalize.com/datasets/global-research-output-mobility-dataset
数据集同时提供DOI(10.5281/zenodo.21837748)和GitHub Release镜像。
技术使用
支持通过Hugging Face的datasets库加载:
python from datasets import load_dataset
ds = load_dataset("zalizedata/global-research-output-mobility-dataset", "author_mobility", split="train")
相关数据集
DataForge还提供其他健康、法律与科学领域的开放数据集,完整目录共25个数据集,可在 https://data.zalize.com/open-data 查看。