evocorps-neutral-news
收藏资源简介:
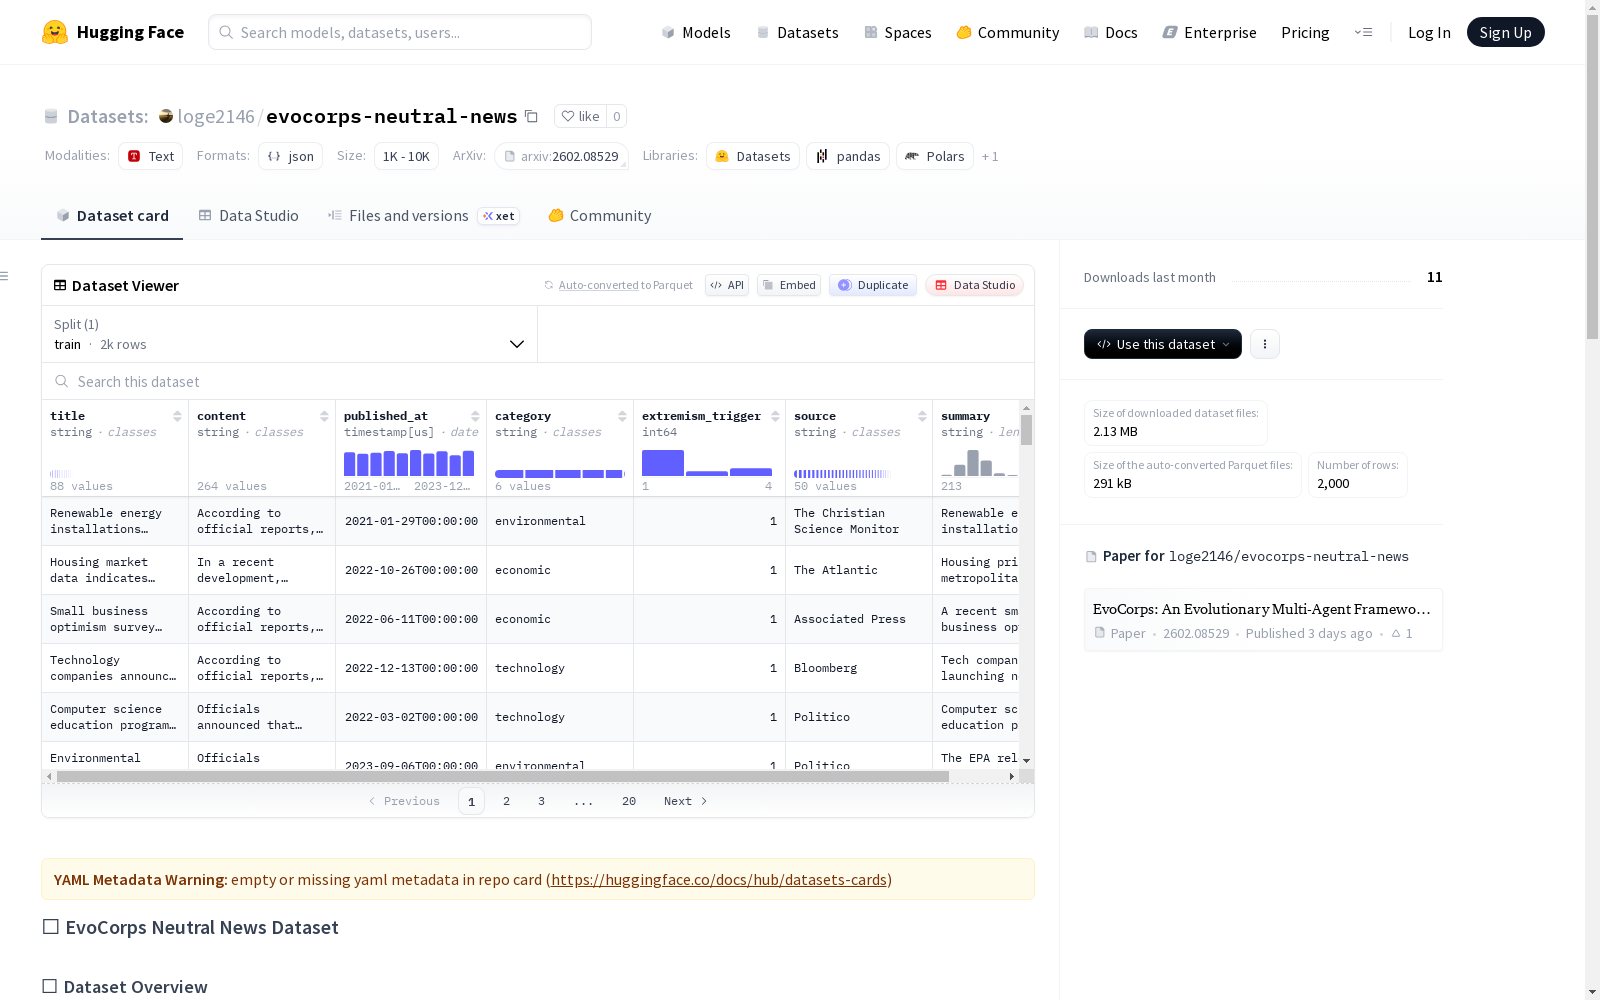
EvoCorps Neutral News Dataset 是一个精选的中立新闻文章集合,旨在用于自然语言理解、平衡报道分析、新闻分类及相关任务的研究。与专注于错误信息或情感极端的数据集不同,该数据集强调中立或事实导向的新闻内容,可作为模型和实验的基线或参考语料库。 每个样本包含以下结构化字段: - **title**:新闻标题 - **content**:新闻全文 - **published_at**:发布时间戳 - **category**:高级类别标签(如经济、环境) - **source**:新闻来源或出版商 - **summary**:新闻摘要 - **extremism_trigger**:数值指标(如中立性评分或注释) 数据集以 JSON 格式提供,包含约 2,000+ 条涵盖多样主题的中立新闻条目。 该数据集适用于多种研究和实际任务,包括但不限于: - 训练/基准测试中立新闻分类模型 - 构建基线语料库以与错误信息或有偏见的新闻数据集进行比较 - 研究不同主题和类别中的平衡报道模式 - 支持摘要、主题建模和信息检索等 NLP 任务 数据集采用 Apache-2.0 许可证,可自由用于研究和商业目的。
The EvoCorps Neutral News Dataset is a curated collection of neutral news articles, designed for research in natural language understanding, balanced journalism analysis, news classification, and related tasks. Unlike datasets focused on misinformation or emotionally extreme content, this dataset prioritizes neutral or fact-oriented news content, serving as a baseline or reference corpus for models and experiments. Each sample includes the following structured fields: - **title**: the news headline - **content**: the full news article - **published_at**: publication timestamp - **category**: high-level category tags (e.g., economics, environment) - **source**: the news source or publisher - **summary**: the news summary - **extremism_trigger**: a numerical metric (e.g., neutrality score or annotation) The dataset is provided in JSON format, containing approximately 2,000+ neutral news entries covering diverse topics. This dataset is suitable for a wide range of research and practical tasks, including but not limited to: - Training and benchmarking neutral news classification models - Constructing baseline corpora for comparison with misinformation or biased news datasets - Investigating patterns of balanced reporting across different topics and categories - Supporting NLP tasks such as summarization, topic modeling, and information retrieval The dataset is licensed under Apache-2.0, and can be freely used for both research and commercial purposes.
📰 EvoCorps Neutral News Dataset 概述
📌 数据集概览
EvoCorps Neutral News Dataset 是一个精选的中性新闻文章集合,旨在用于自然语言理解、平衡报道分析、新闻分类及相关任务的研究。与关注错误信息或情感极端的数据集不同,本数据集强调中性或事实导向的新闻内容,可作为模型和实验的基线或参考语料库。
每个样本包含以下结构化字段:
- title — 新闻文章标题
- content — 新闻文章全文
- published_at — 发布时间戳
- category — 高级类别标签(例如:经济、环境)
- source — 新闻来源或发布者
- summary — 文章简短摘要
- extremism_trigger — 数字指标(例如:中立性分数或注释)
数据集以 JSON 格式提供,包含约 2000+ 篇中性新闻条目,涵盖多样主题。
🎯 使用场景
本数据集适用于多种研究和实际任务,包括但不限于:
- 🧠 训练/评估中性新闻分类模型
- 📊 构建基线语料库,用于与错误信息或有偏见新闻数据集进行比较
- 🔎 研究跨主题和类别的平衡报道模式
- 📚 支持摘要、主题建模和信息检索等 NLP 任务
🔗 项目与论文链接
- 📂 项目仓库(GitHub) https://github.com/ln2146/EvoCorps
- 📄 相关论文(arXiv) https://arxiv.org/abs/2602.08529
🚀 快速开始
以下是一个使用 Hugging Face Datasets 库的简单 Python 示例: python from datasets import load_dataset
dataset = load_dataset("loge2146/evocorps-neutral-news")
for sample in dataset["train"]: print("Title:", sample["title"]) print("Category:", sample["category"]) print("Content:", sample["content"][:200], "…") print("Published:", sample["published_at"]) print("——" * 10)
📜 许可证
本数据集基于 Apache-2.0 许可证发布,可自由用于研究和商业目的。