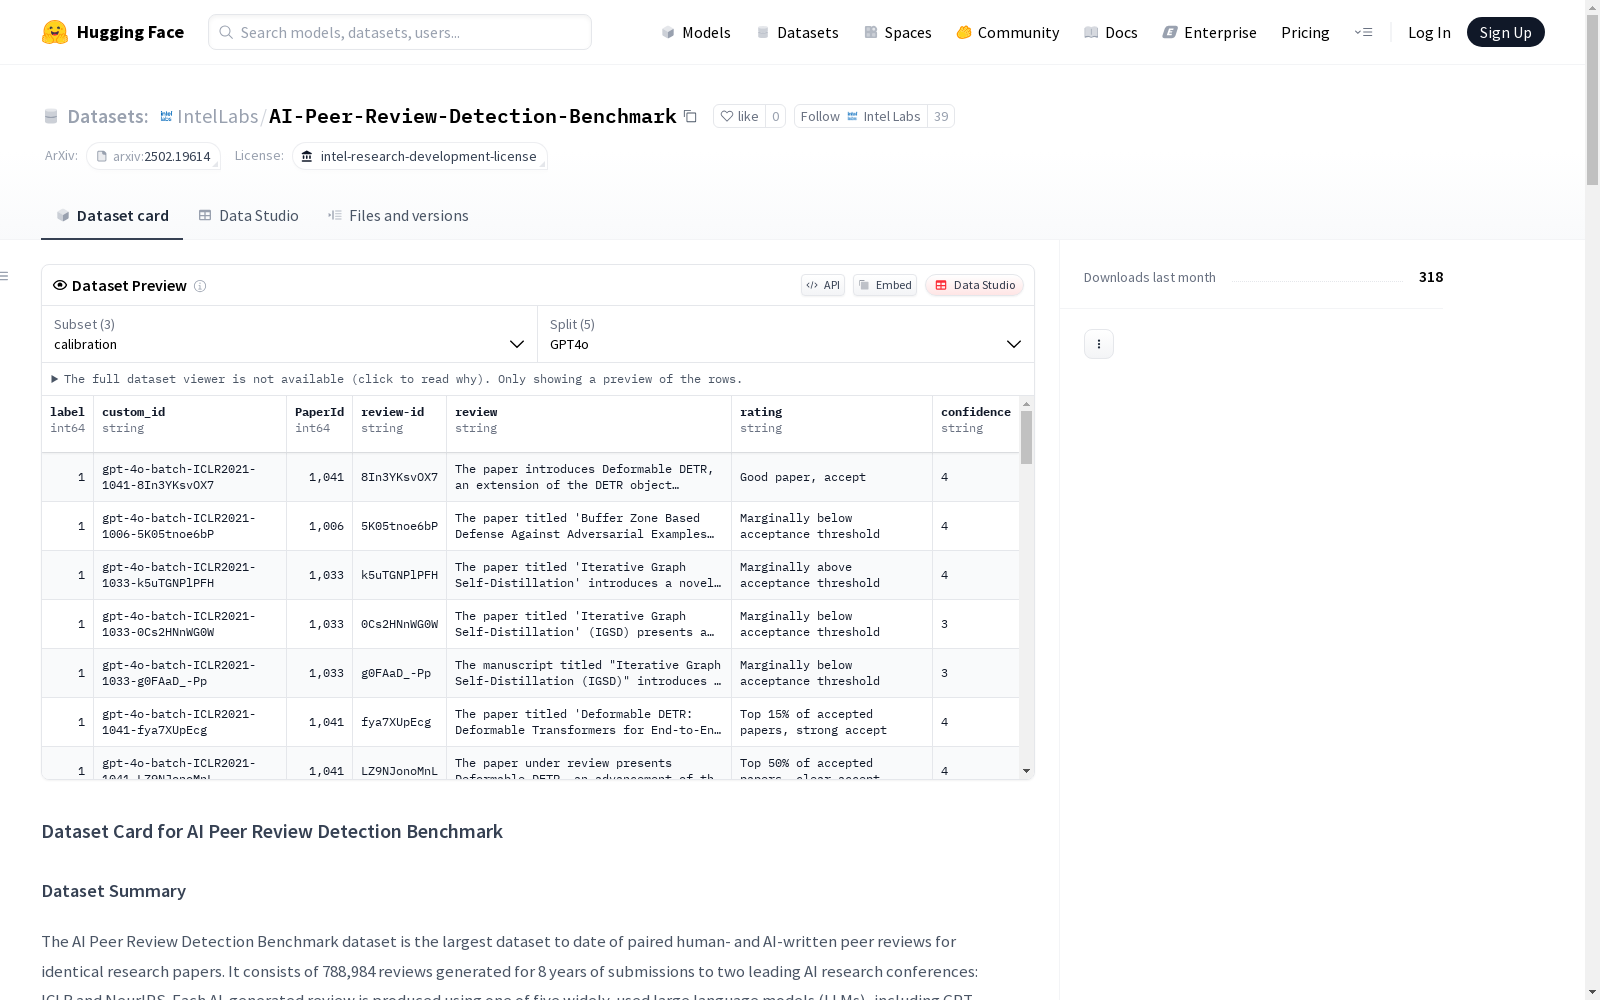
AI-Peer-Review-Detection-Benchmark
收藏资源简介:
AI同行评审检测基准数据集是目前为止最大的成对人类和AI撰写的同行评审数据集,用于相同的学术论文。该数据集包含了8年来提交给两个顶级AI研究会议:ICLR和NeurIPS的788,984篇评审,每个AI生成的评审都是使用五种广泛使用的大型语言模型(LLM)之一生成的,并与相应的人类撰写的评审配对。数据集包括多个子集(校准集、测试集、扩展集),以支持对AI生成文本检测方法的系统评估。
The AI-generated peer review detection benchmark dataset is the largest currently available corpus of paired peer reviews, where each pair consists of one human-written review and one AI-generated review for the exact same academic paper. This dataset includes 788,984 peer reviews submitted over an 8-year period to two top-tier AI research conferences: ICLR and NeurIPS. Each AI-generated review was created using one of five widely adopted Large Language Models (LLMs), and is paired with its corresponding human-written review. The dataset features multiple subsets (calibration set, test set, extended set) to support systematic evaluation of AI-generated text detection methods.
AI Peer Review Detection Benchmark 数据集概述
数据集摘要
- 该数据集是目前最大的配对人类和AI撰写的同行评审数据集,针对相同研究论文。
- 包含788,984条评审,涵盖8年内提交给ICLR和NeurIPS两个顶级AI研究会议的论文。
- 每条AI生成的评审由五种广泛使用的大型语言模型(LLM)之一生成,包括GPT-4o、Claude Sonnet 3.5、Gemini 1.5 Pro、Qwen 2.5 72B和Llama 3.1 70B,并与对应的人类撰写评审配对。
- 数据集包含多个子集(校准、测试、扩展),以支持对AI生成文本检测方法的系统评估。
数据集详情
- 创建者: Intel Labs
- 版本: v1.0
- 许可证: Intel OBL Internal R&D Use License Agreement
- 样本数量:
- 校准(训练)样本: 75,824
- 测试样本: 287,052
- 扩展样本: 426,108
- 总样本: 788,984
- 格式: CSV
- 字段: CSV文件的列结构可能因会议和年份而异,具体参见论文中的表5。
预期用途
- 主要用途:
- 仅限研究使用
- 用于AI生成同行评审检测方法的基准测试和开发
- 分析人类和AI评审内容的差异
- 非预期用途:
- 非研究或商业用途
- 在实际系统中部署用于自动评审检测
- 可能滥用同行评审或损害研究完整性的用途
数据收集过程
- 人类撰写评审通过OpenReview API(ICLR 2019–2024, NeurIPS 2021–2024)和ASAP-Review数据集(ICLR 2017–2018, NeurIPS 2016–2019)从公开来源收集。
- AI生成评审通过五种LLM生成,使用原始论文文本、会议特定的评审指南和评审模板对齐。
- 使用商业API服务和本地硬件(Intel Gaudi和NVIDIA GPU)生成AI评审。
文件命名和结构
- 文件命名格式:
<subset_name>.<conference_name>.<LLM_name>.csv - 目录结构:
- 校准、测试和扩展集分别位于单独的目录中。
- 每个目录包含用于生成AI同行评审样本的不同模型的子目录。
- 每个模型的子目录中包含多个CSV文件,每个文件代表特定会议的同行评审样本。
引用信息
如果使用此数据集,请引用以下论文:
@misc{yu2025paperreviewedllmbenchmarking, title={Is Your Paper Being Reviewed by an LLM? Benchmarking AI Text Detection in Peer Review}, author={Sungduk Yu and Man Luo and Avinash Madusu and Vasudev Lal and Phillip Howard}, year={2025}, eprint={2502.19614}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2502.19614}, }
联系信息
- 问题: 如有任何问题,请联系维护者或在数据集仓库中提交问题。