
遇见数据集

ytu-ce-cosmos/absa-tr

收藏
Hugging Face2026-07-20 更新2026-07-22 收录
官方服务:

资源简介:

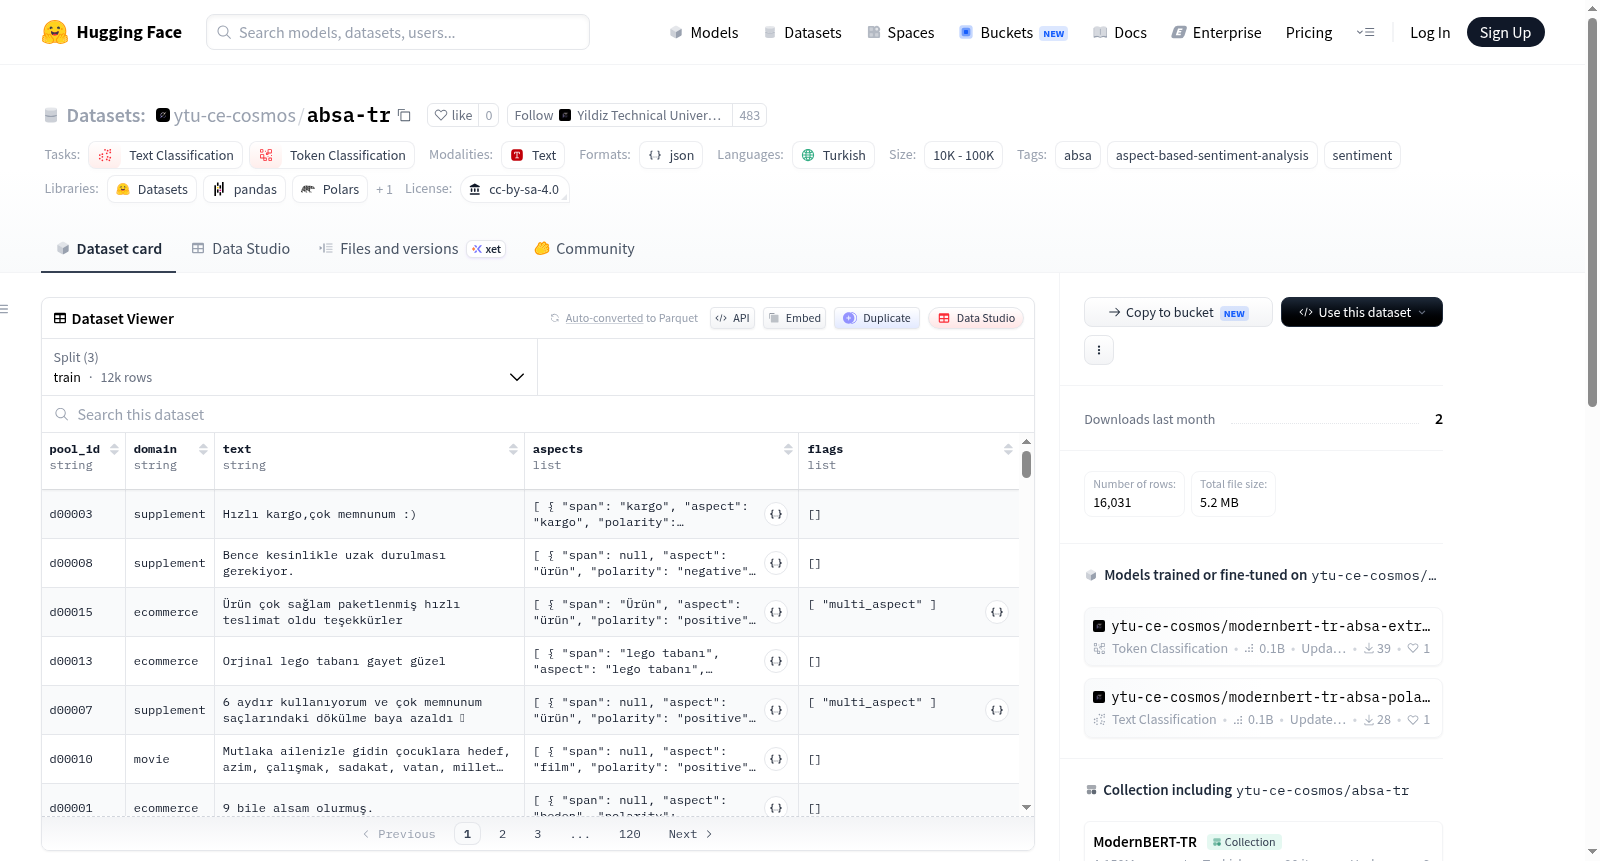
ABSA-TR是一个土耳其语方面级情感分析数据集,包含来自电子商务、补充剂和电影领域的16,031条真实用户评论句子和24,439个方面标注。数据集支持方面极性分类和方面术语提取任务,其中极性分类包括隐式方面,而提取任务仅使用显式跨度。数据划分为训练集(11,993个句子,17,423个方面,3,995个隐式方面)、验证集(688个句子,1,218个方面,179个隐式方面)和测试集(3,350个句子,5,798个方面,804个隐式方面)。每条数据包含pool_id、domain、text、aspects和flags列,每个方面有字面span、归一化aspect、极性(正面、负面或中性)和标注source。训练集由DeepSeek-V4-Pro标注,验证集和测试集基于GLM-5.1、MiniMax-M3和Kimi-K2.6的共识标注,数据源自Altinok (2023)介绍的土耳其评论资源。

A Turkish aspect-based sentiment dataset with 16,031 real user-review sentences and 24,439 aspect annotations from e-commerce, supplements, and movie domains. The dataset supports aspect polarity classification and aspect-term extraction, with polarity classification including implicit aspects and extraction using only explicit spans. It is split into train (11,993 sentences, 17,423 aspects, 3,995 implicit aspects), validation (688 sentences, 1,218 aspects, 179 implicit aspects), and test (3,350 sentences, 5,798 aspects, 804 implicit aspects). Each row contains pool_id, domain, text, aspects, and flags, with each aspect having a verbatim span, a normalized aspect, a polarity of positive, negative, or neutral, and an annotation source. The training split was annotated by DeepSeek-V4-Pro, while validation and test use a separate pool labeled by consensus among GLM-5.1, MiniMax-M3, and Kimi-K2.6, with original sentences from Turkish review resources introduced by Altinok (2023).
提供机构:
ytu-ce-cosmos
搜集汇总
数据集介绍
ytu-ce-cosmos/absa-tr 数据集图片
构建方式
ABSA-TR数据集构建于土耳其语真实用户评论之上,涵盖电商、保健品与电影三大领域,共计16,031条句子与24,439个方面级情感标注。训练集由DeepSeek-V4-Pro模型完成标注,验证集与测试集则采用GLM-5.1、MiniMax-M3与Kimi-K2.6三个模型共识标注策略,确保标注质量。数据源沿用Altinok(2023)提出的土耳其语评论资源,原始评论来自MusteriYorumlari、vitamins-supplements-reviews及beyazperde-top-300-movie-reviews等公开数据集。每条数据包含pool_id、domain、text、aspects与flags字段,其中aspects字段记录方面项的原始文本片段、归一化方面词、情感极性(正面、负面或中性)及标注来源。
特点
该数据集具备双重任务支持能力,既可进行方面情感极性分类,又能用于方面词抽取任务。情感极性分类涵盖显式与隐式方面表达,而方面词抽取仅基于显式文本片段。数据规模分布为训练集11,993句、验证集688句、测试集3,350句,方面标注总数达24,439个,其中隐式方面占比约20%。验证集与测试集特别强化了困难案例的覆盖,通过多模型共识机制提升标注可靠性。三个领域的数据混合设计增强了模型的泛化能力,使数据集适用于跨领域情感分析研究。
使用方法
数据集以JSONL格式提供,包含train.jsonl、dev.jsonl与test.jsonl三个拆分文件,可通过HuggingFace Datasets库直接加载。使用默认配置名default即可读取全部拆分。对于方面情感极性分类任务,可利用aspects字段中的polarity标签进行多分类训练;对于方面词抽取任务,则需从text字段中定位span字段对应的显式方面片段。建议先对隐式方面进行过滤处理,确保抽取任务的输入与标签对齐。模型评估可参考标准分类指标(如准确率、F1分数)或序列标注的实体级评价指标。
背景与挑战
背景概述
在自然语言处理领域,细粒度情感分析是理解用户评论的关键任务,其中基于方面的情感分析能够捕捉文本中对特定实体的情感倾向。土耳其语作为低资源语言,在情感分析研究中长期面临标注数据匮乏的困境。为此,研究人员于近期构建了ABSA-TR数据集,该数据集由Altinok等机构主导创建,整合了来自电商、保健品和电影领域的16,031条真实用户评论,包含24,439个方面标注。核心研究问题在于为土耳其语提供高质量的方面级情感分析资源,推动模型在该语言上的泛化能力。该数据集采用半自动化标注流程,结合大语言模型进行高效标注,并通过多模型协商机制保证质量,为低资源语言的细粒度情感分析研究树立了重要基准。
当前挑战
ABSA-TR数据集所解决的领域挑战主要源于土耳其语作为低资源语言在情感分析中的结构性不足,具体包括:缺乏统一标注规范的方面级语料库,现有模型难以精准识别隐式方面与情感极性间的复杂关联,以及来自电商、保健品和电影等跨域评论中术语差异导致的迁移学习困难。在构建过程中,挑战则体现在确保标注一致性方面。训练集依赖单一DeepSeek模型自动标注可能引入系统性偏差,而验证集与测试集虽采用多模型共识策略,但模型间对情感极性及方面边界的判断分歧仍需人工调和。此外,隐式方面占总标注的16.4%,其隐含语义的捕捉既考验模型推理能力,也增加了标注噪声控制的难度。
常用场景
经典使用场景
在自然语言处理与情感计算领域,ABSA-TR数据集为面向土耳其语的细粒度情感分析研究提供了坚实基石。其核心使用场景聚焦于两个方面:一是进行方面项抽取(Aspect-Term Extraction),即从用户评论中精准识别出评价的具体对象(如产品特性或服务细节);二是执行方面情感极性分类(Aspect Polarity Classification),判断每个方面所承载的情感倾向——积极、消极或中性。数据集涵盖电商、营养补充品与电影三大领域,包含超过1.6万条真实用户评论及2.4万余条方面标注,尤其引入了隐性方面(implicit aspects),使得模型在理解隐含情感表达方面面临更高挑战。这些特性使ABSA-TR不仅适用于搭建和评估土耳其语情感分析系统,也成为跨语言对比研究中检验模型泛化能力的重要测试平台。
解决学术问题
该数据集的创建有力回应了土耳其语资源匮乏背景下情感分析研究的瓶颈问题。传统情感分析方法侧重于篇章或句子级别的情感判断,难以捕捉针对不同属性的复杂情感分布。ABSA-TR通过精细化的方面级标注,使研究者能够探索细粒度情感挖掘这一核心学术难题,包括如何从非结构化评论文本中提取具有语义的方面项,以及如何建立情感极性与其所修饰对象之间的映射关系。此外,数据集引入隐性方面(如未明确提及但通过上下文推断的评价对象),为文本隐含语义理解研究提供了珍贵的训练与评估资源。这一数据集的出现极大推动了土耳其语自然语言处理在少资源设定下的发展,其领域多样性和标注规模也为构建鲁棒的情感分析模型、探索跨领域迁移学习提供了关键支撑。
衍生相关工作
自ABSA-TR发布以来,围绕该数据集已衍生出一系列富有影响力的研究工作。在算法层面,研究者探索了基于Transformer架构(如BERTurk、XLM-R)的序列标注与分类联合模型,并对比了不同预训练语言模型在土耳其语方面情感分析任务上的表现。在方法创新上,隐性方面标注的引入催生了关于连接推理与情感分析的新型模型设计,部分工作尝试利用图神经网络或提示学习来捕获隐式评价与显式文本间的关联。在资源贡献方面,该数据集被用作土耳其语情感分析挑战赛的基准,驱动了针对低资源语言联邦学习与数据增强技术的研究。此外,跨语言研究团队以ABSA-TR为锚点,构建了土耳其语-英语方面情感分析对照语料库,促进了多语言情感理解系统的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

