
遇见数据集

futo-org/coco-captions-qwen3vl

收藏
Hugging Face2026-06-12 更新2026-06-14 收录
官方服务:

资源简介:

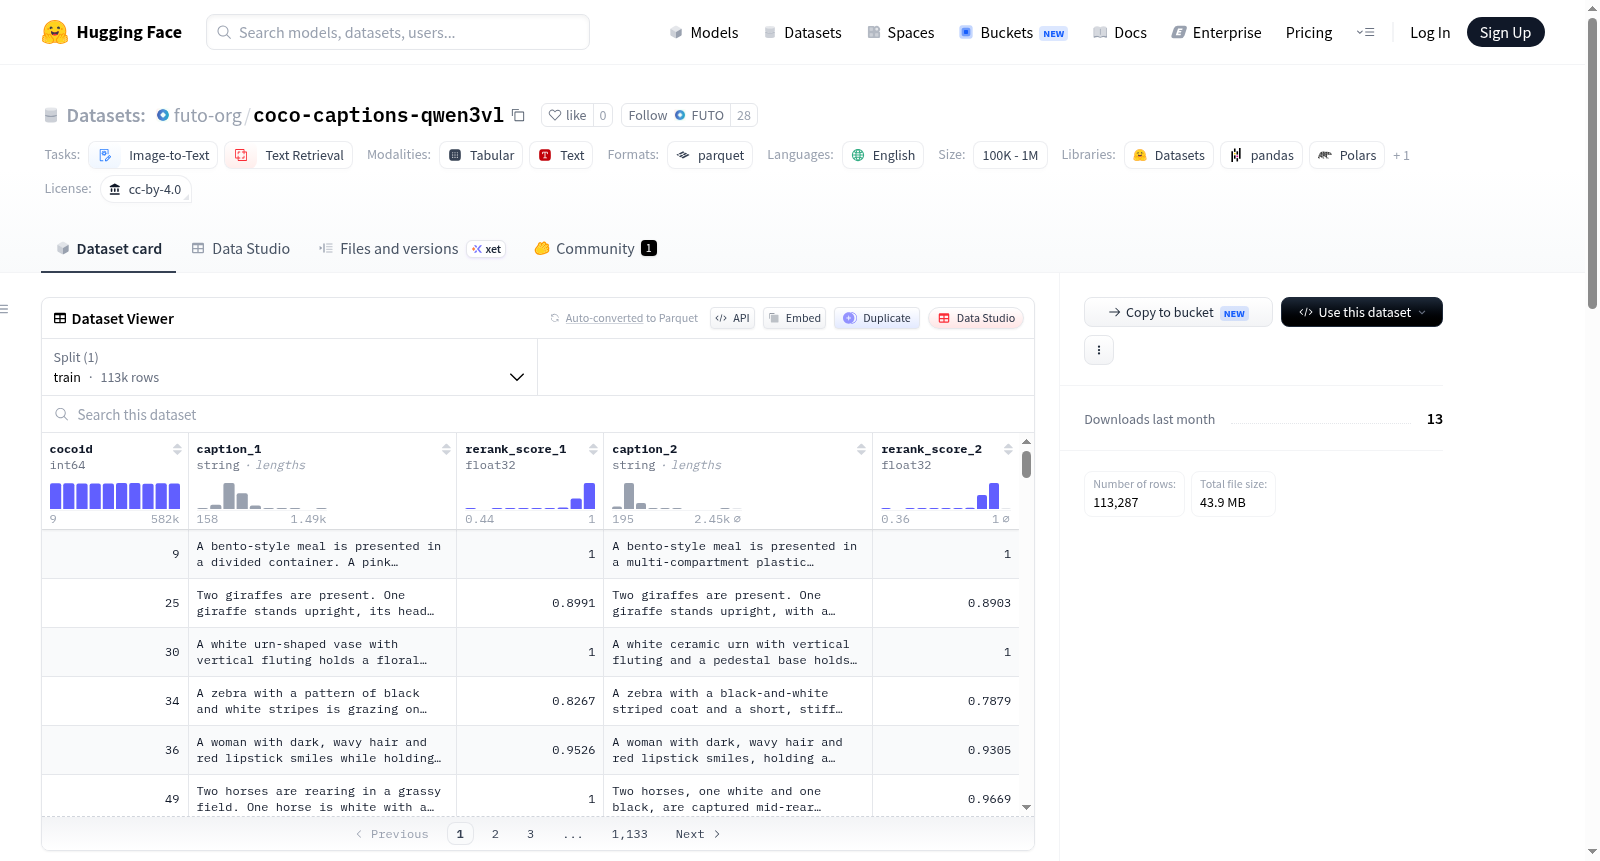
这是一个高质量、面向检索的文档式描述数据集,基于COCO(Karpathy训练分割)的113,287张图像。它提供丰富、接地气、属性密集的描述,旨在作为搜索文档(60-150个单词),而非单行描述。数据集覆盖COCO 2014训练+验证池中的图像(标准分割用于描述/检索工作),未包含保留的Karpathy验证/测试集(各5,000张)。每张图像通过Qwen3-VL-30B-A3B-Instruct模型生成16个候选描述,然后使用Qwen3-VL-Reranker-8B模型对所有候选进行排名,保留前2个最佳描述。原始COCO人类描述(每张图像5个)作为生成提示提供,但未包含在数据集中。所有113,287张图像均被覆盖,确保数据完整性。

High-quality, retrieval-oriented document-style captions for the 113k COCO (Karpathy train split) images: rich, grounded, attribute-dense descriptions intended as search documents (60–150 words), not one-line captions. This dataset covers the Karpathy training split: 113,287 images drawn from the COCO 2014 train+val pool (the standard split for caption/retrieval work; the held-out Karpathy val/test 5k+5k are deliberately not included). For each image, 16 candidate captions were generated with Qwen3-VL-30B-A3B-Instruct, then ranked with Qwen3-VL-Reranker-8B and the top-2 were kept. Original COCO human captions were used as hints but are not included. All 113,287 images are covered.
提供机构:
futo-org
搜集汇总
数据集介绍
futo-org/coco-captions-qwen3vl 数据集图片
构建方式
该数据集是基于COCO Karpathy训练分割中的113,287张图像构建的高质量检索导向文档式描述。针对每张图像,采用Qwen3-VL-30B-A3B-Instruct模型生成16个候选描述,并利用Qwen3-VL-Reranker-8B重排序器对所有候选进行评分,最终保留排名前二的描述。生成过程中,将原始COCO的五条人工描述作为提示输入,但强调模型需依赖图像内容。为确保全面覆盖,对于两条保留描述均非模型生成结果的179张图像,通过相同流程进行重新生成,最终确保所有图像均具备模型生成的优质描述。
特点
该数据集的核心特点在于其描述文本的检索优化属性,每条描述长度介于60至150词之间,富含属性信息且具有扎实的视觉基础,而非简单的一行式标题。经重排序器筛选后,所选描述的中位重排序得分高达0.960,显著优于原始人工描述拼接结果的0.766。数据集包含cocoid、caption_1、rerank_score_1、caption_2及rerank_score_2五个字段,其中部分图像仅保留一条有效描述。此外,cocoid与COCO 2014和2017版本兼容,便于跨版本数据整合。
使用方法
该数据集主要用于训练文本与图像之间的检索任务,尤其适用于SPLADE风格的稀疏对齐模型、描述质量研究以及知识蒸馏场景。用户可通过cocoid字段将描述与COCO 2014或2017版本的图像进行关联,但需注意图像需从COCO官方渠道获取,本数据集不包含图像数据。数据集以CC-BY 4.0许可证发布,使用时应引用COCO数据集,并注明描述源自Qwen系列模型的生成与筛选结果。
背景与挑战
背景概述
COCO Captions Qwen3-VL数据集诞生于大规模图像理解与多模态检索领域对高质量、检索导向的描述文本的迫切需求。该数据集由研究机构基于Qwen3-VL-30B-A3B-Instruct模型与Qwen3-VL-Reranker-8B排序器构建,覆盖COCO Karpathy训练划分中的113,287张图像。其核心研究问题在于如何为每张图像生成60至150词的丰富、具象且属性密集的文档式描述,以替代传统短标题,从而提升文本-图像检索系统的对齐精度与稀疏表征学习效果。该数据集对多模态检索、细粒度描述生成及蒸馏目标设定等领域产生了重要影响,其选用的描述在排序器下的中位得分高达0.960,显著优于原始人工描述。
当前挑战
该数据集所解决的领域挑战在于传统单句标题无法支撑高精度图像检索任务,缺乏属性密度与上下文信息,导致稀疏对齐困难。在构建过程中,面临的挑战包括:生成模型的候选质量一致性难以保证,需通过每图16次采样并引入人工标注作为提示来提升描述的地面性;排序器的可靠性验证中,原始人工描述与LLaVA-NeXT生成的候选仅在0.8%的图像中胜出,暴露了生成与筛选流程的偏差风险;此外,对于179张两候选均非模型生成的图像,需执行一轮重生成以覆盖全部实例,体现了流程的复杂性与对数据完整性的权衡。
常用场景
经典使用场景
COCO Captions Qwen3-VL数据集是面向图像与文本跨模态检索任务构建的高质量描述资源。该数据集基于COCO Karpathy训练拆分中的113,287张图像,利用Qwen3-VL-30B-A3B-Instruct模型为每张图像生成16个候选描述,并通过Qwen3-VL-Reranker-8B重排序器筛选出最优的两个描述。这些描述以文档风格呈现,内涵丰富的属性细节与空间关系,摒弃传统单行标题的简洁性,转而采用60至150词的详尽表述。经典使用场景聚焦于训练基于文本的稀疏检索模型,例如SPLADE风格的稀疏对齐系统,通过丰富的视觉语义映射提升跨模态匹配精度。
衍生相关工作
该数据集衍生了多个开创性工作,显著推动了多模态检索与生成领域的发展。基于其文档式描述,研究者开发出SPLADE-style稀疏对齐框架,实现了零推理状态下的高效跨模态映射,挑战了传统双编码器主导的稠密检索范式。该工作进一步催生了对比学习优化的描述增强方法,通过模型合成数据提升稀疏表示的判别力。此外,重排序器选择的训练策略被广泛应用于半监督描述生成任务,结合知识蒸馏技术,将大型视觉语言模型的能力迁移至轻量级网络。这些衍生产物共同构建了一个从数据构建到模型优化的完整生态,为多模态信息检索与视觉语义理解提供了新范式。
数据集最近研究
最新研究方向
该数据集聚焦于多模态检索场景下,利用大型视觉语言模型(如Qwen3-VL-30B-A3B-Instruct)生成高质量、面向检索的文档式描述,并通过重排序模型(Qwen3-VL-Reranker-8B)精选最优候选项,以替代传统单行标注。这一方向紧密关联当前多模态检索与稀疏对齐的前沿探索,尤其在无需推理的图文检索流水线中,通过富文本描述增强属性级匹配精度。数据集覆盖113K COCO Karpathy训练图像,其重排序质量(中位数0.960分)远超原始人工标注,为基于SPLADE等技术的训练与蒸馏提供了可靠基础,推动了检索式描述生成范式从简洁标注向结构化文档语料的演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

