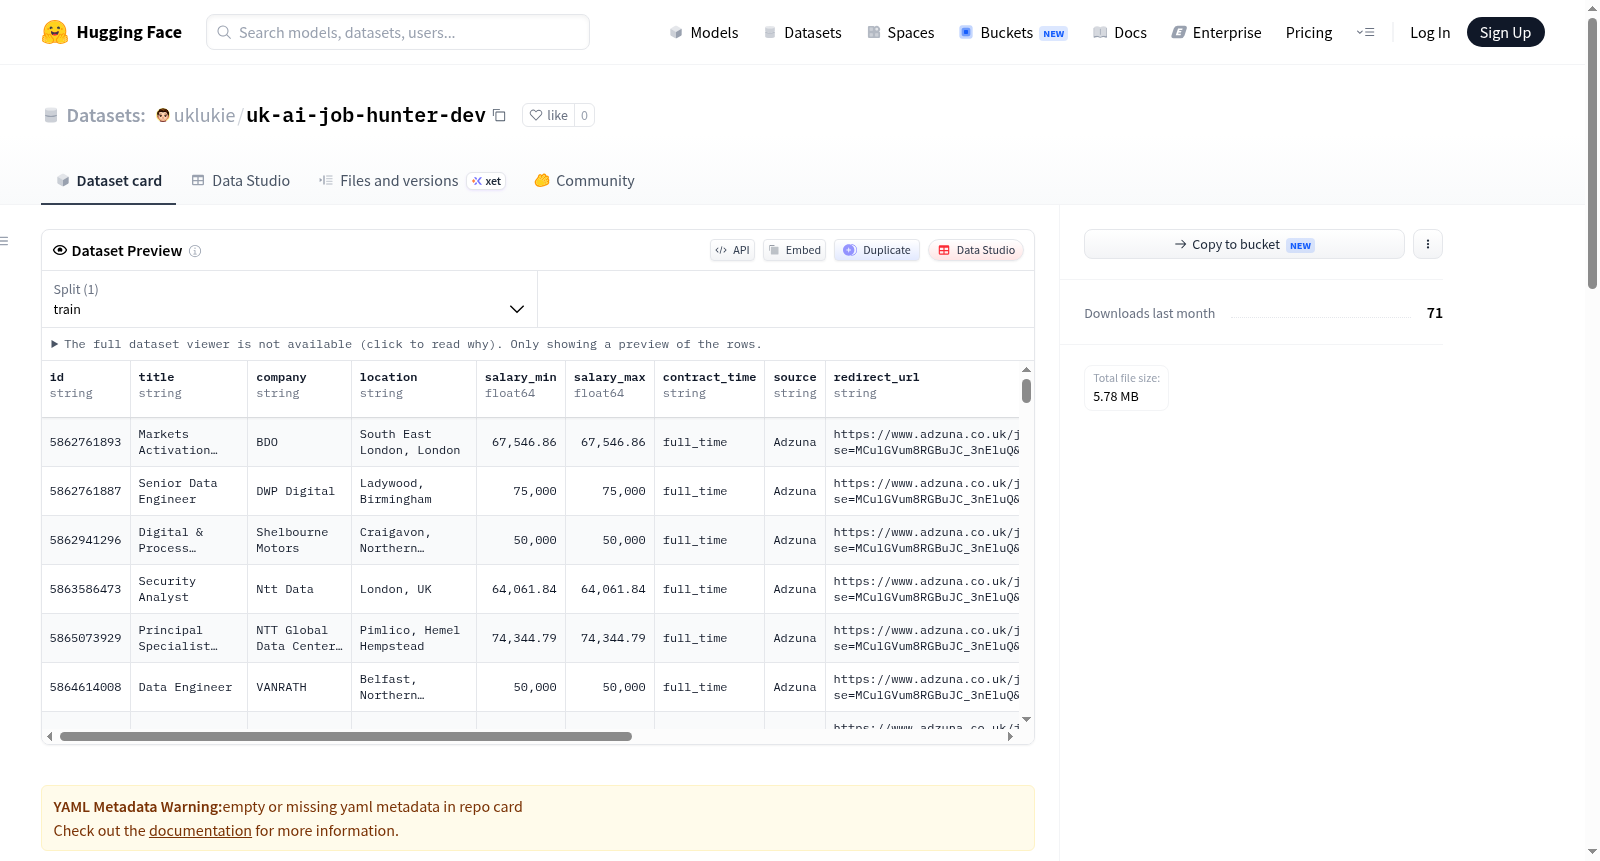
uk-ai-job-hunter-dev
收藏资源简介:
该数据集是英国IT和AI职位招聘信息的精选集合,专为语义去重和高匹配候选人识别设计。数据通过混合管道从多个来源聚合:Adzuna API覆盖英国IT岗位的广泛市场,JSearch/RapidAPI针对高科技和AI岗位进行定向搜索,JobSpy直接抓取Indeed和LinkedIn列表。数据通过GitHub Actions每日收集,并存储在Hugging Face上的版本化存档中。预处理流程包括:使用all-MiniLM-L6-v2或BGE-large-en-v1.5嵌入模型基于语义相似性进行去重;利用LLM(Gemini/Llama)根据高级云/DevOps/AI标准评估职位描述,识别高匹配候选人;自动提取技术技能(如AWS、Kubernetes、Terraform)和安全许可级别(如SC、DV)。数据集包含10个字段:title(职位名称)、company(公司)、location(英国城市/地区)、source(来源API)、job_url(申请链接)、date_posted(发布日期)、isHighMatch(AI确定的高相关标志)、tags(提取的技术关键词)、clearance(安全许可要求)、description(职位描述片段)。该数据集旨在用于本地LLM的监督微调,以自动分类职位、通过比较用户简历与isHighMatch标签预测匹配概率,并基于tags和description生成高转化率的求职信。
This dataset is a curated collection of UK IT and AI job postings, designed for semantic deduplication and high-match candidate identification. The data is aggregated from multiple sources via a hybrid pipeline: Adzuna API for broad UK IT job market coverage, JSearch/RapidAPI for targeted searches on high-tech and AI positions, and JobSpy for direct scraping of Indeed and LinkedIn listings. Data is collected daily via GitHub Actions and stored in a versioned archive on Hugging Face. Preprocessing includes: deduplication based on semantic similarity using all-MiniLM-L6-v2 or BGE-large-en-v1.5 embedding models; evaluation of job descriptions using LLMs (Gemini/Llama) against senior cloud/DevOps/AI criteria to identify high-match candidates; automatic extraction of technical skills (e.g., AWS, Kubernetes, Terraform) and security clearance levels (e.g., SC, DV). The dataset contains 10 fields: title, company, location (UK city/region), source (API), job_url, date_posted, isHighMatch (AI-determined high relevance flag), tags (extracted technical keywords), clearance (security clearance requirement), and description (job description snippet). The dataset is intended for supervised fine-tuning of local LLMs to automatically classify job postings, predict match probability by comparing user resumes with isHighMatch labels, and generate high-conversion cover letters based on tags and description.
数据集概述
数据集名称与用途
UK AI Job Hunter Dataset 是一个针对英国境内 IT 与人工智能(AI)职位发布的精选数据集,旨在支持语义去重以及高匹配候选人的识别。该数据集可作为训练本地大语言模型(LLM)的黄金标准数据,用于职位自动分类以及基于专业简历(CV)的匹配概率预测。
数据来源与采集方式
数据通过混合型流水线从多个来源汇总:
- API01 (Adzuna):提供英国 IT 岗位的广泛市场覆盖。
- API02 (JSearch/RapidAPI):针对高科技与 AI 岗位的定向搜索。
- API03 (JobSpy):直接抓取 Indeed 与 LinkedIn 上的职位信息。
数据每日通过 GitHub Actions 采集,并以版本化归档形式存储在 Hugging Face 上。
预处理与 AI 处理流程
- 语义去重:使用
all-MiniLM-L6-v2(或升级版BGE-large-en-v1.5)嵌入模型,基于语义相似性(而非精确文本匹配)识别跨平台的重复职位信息。 - AI 标注:通过基于 LLM(Gemini/Llama)的评估方法,将职位描述与“高级云/DevOps/AI”标准进行比对,从而识别高匹配候选人。
- 标签提取:自动提取技术技能(如 AWS、Kubernetes、Terraform 等)以及安全许可等级(如 SC、DV)。
数据模式(Schema)定义
| 字段 | 类型 | 描述 |
|---|---|---|
title |
字符串 | 官方职位名称。 |
company |
字符串 | 招聘组织名称。 |
location |
字符串 | 英国的城市/地区。 |
source |
字符串 | 来源 API(Adzuna、JobSpy、JSearch)。 |
job_url |
链接 | 职位申请页面的直接链接。 |
date_posted |
日期 | 发布时间(ISO 格式)。 |
isHighMatch |
布尔值 | AI 判定的高相关性标识。 |
tags |
列表 | 提取出的技术关键词。 |
clearance |
字符串 | 安全许可要求(例如 SC、eDV)。 |
description |
字符串 | 职位描述片段。 |
预期用途:面向 LLM 训练
该数据集计划用于本地大语言模型的监督微调(Supervised Fine-Tuning, SFT),具体应用方向包括:
- 无需外部 API 调用,即可自动完成职位分类。
- 通过将用户 CV 与
isHighMatch标签进行比对,预测“匹配概率”。 - 基于
tags与description生成高转化率的求职信(cover letter)。